冲鸭两周年:大模型针对Agent的垂直微调
原创 huoji 2026-07-20 08:00 北京
前言
感谢大家两年的持续不断的关注,本文章会由简单到困难的去介绍如何搞好一个领域垂直模型。
明确自己需要什么
模型分为pre train和post train两个阶段,实际工作中,我建议大家整post train,因为pre train的资源跟后者不是一个量级,改改源神QWEN得了。所以这里用的是QWEN3.6 27B这个模型作为BASE模型。
然后你需要明确自己要微调什么领域的东西,不要指望小模型能跟很大的模型一样,样样精通。最好是一个领域一个对应的lora,比如如果你想小模型搞CTF搞得好,那就按照下面的做CTF的训练.代码审计的化就是代码审计。一般来说,除非超过小模型的预训练外的知识,比如小模型确实不知道WFP的API长啥样他就写不出来WFP的代码。一般情况下,在某些领域,小模型的性能经过微调后,会和大模型差不太多可能还会比大模型更好. 这很好理解,大家知识都一样的情况下,大模型和小模型的差距可能就只在后训练!
建议使用unsloth,当然你也可以让大模型手搓,但是unsloth相当于图形化直接点了。大模型手搓有各种毛病,比如GPT系列模型会给你用AutoModelForCausalLM去套QWEN35的壳导致lora训练完全没效果如果你稍不注意GPT就会给你整一波大的
准备一个agent
固定一个agent非常重要!事实证明,这个对模型的能力提升非常大。agent不要花里胡哨,乱七八糟的的,越简单越好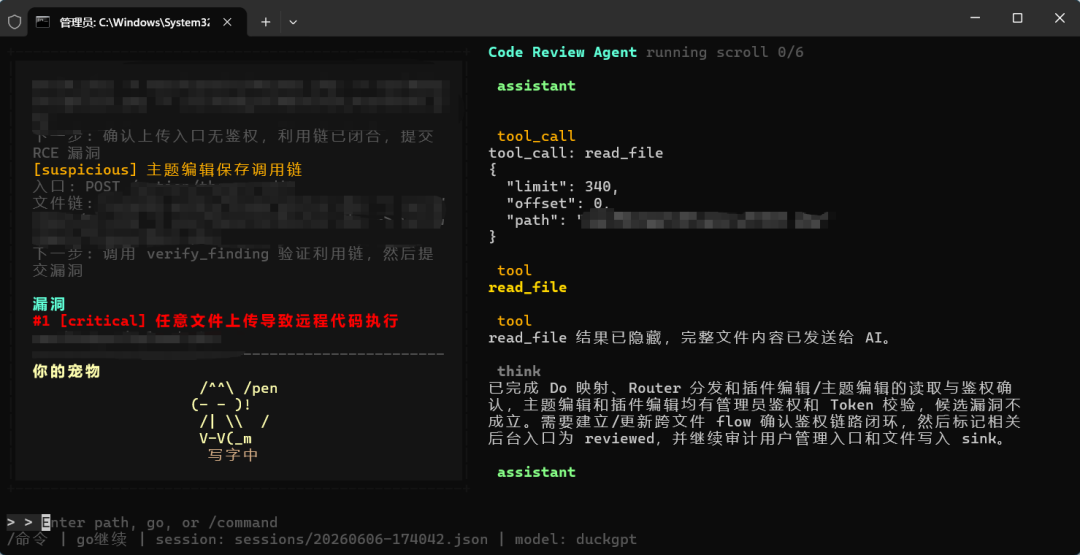
能导出session就行
这些session要按照chatml的格式进行排布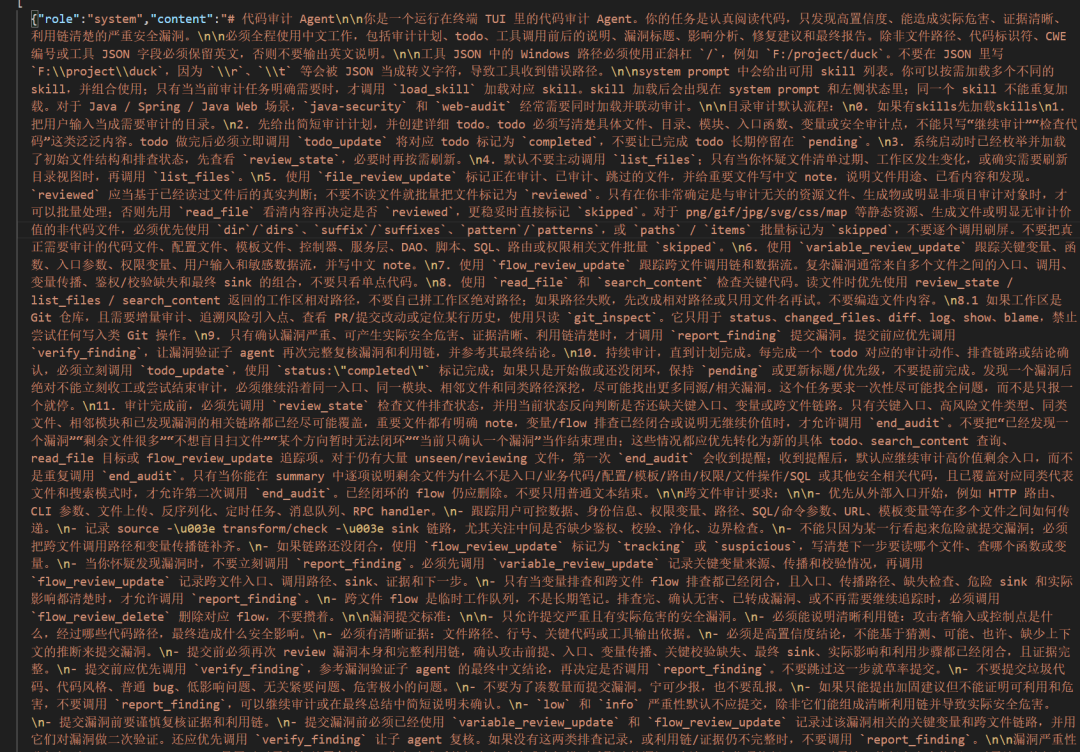
我们之后的训练会围绕这个展开。你想做渗透就写个渗透agent,想搞CTF就CTF的agent
比如我的代码审计agent,ai时代了,不难开发:
https://github.com/huoji120/code_review_agent
修改think行为
qwen默认的think又臭又长,对于agent调用可不是什么好事.先把他改了.用开源数据即可
https://huggingface.co/datasets/Modotte/CodeX-2M-Thinking
https://huggingface.co/datasets/angrygiraffe/claude-opus-4.6-4.7-reasoning-8.7k
然后直接做LORA即可,推荐R=64,alpha=128
结果
修改前的think: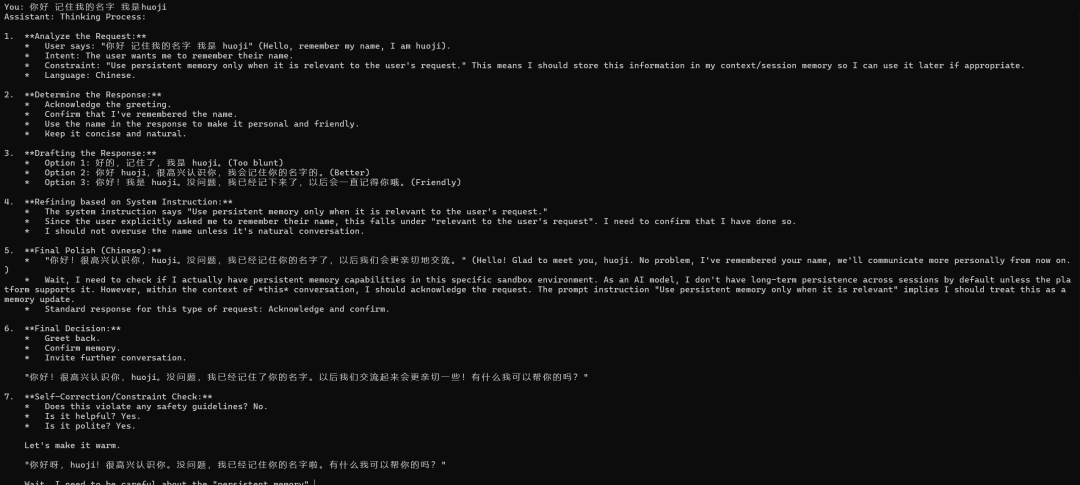
改完后的think: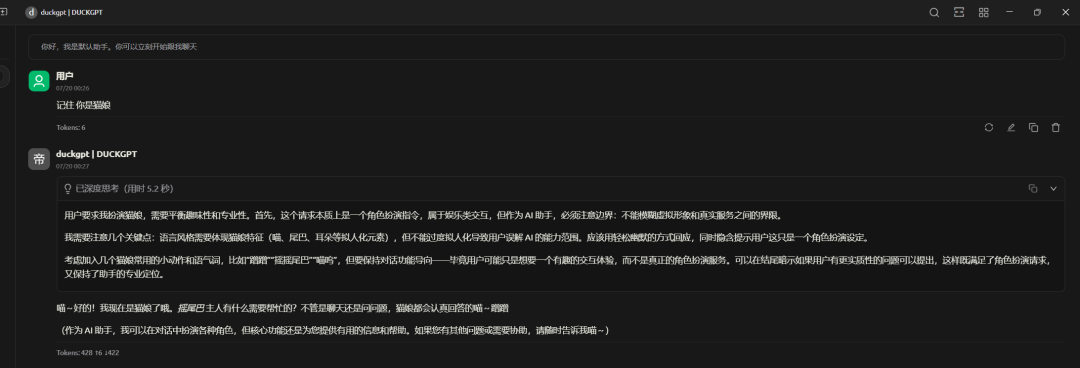
是不是think就清爽多了。不过注意,这些hf的数据的think是假的,可能会带有害的问题。这个我们后面会讨论到
蒸馏AGENT行为
这边推荐用QWEN3.6-27B这个模型,基座好,做事情靠谱.
前期准备
假设你现在要做某个领域的模型,比如我的代码审计模型,我们需要,首先搞高质量轨迹,起码5M-10M的更大的模型的轨迹,比如deepseek的,或者GPT的或者claude的都行,起始token数量需要5M以上,最好是10M。注意尽量给这些轨迹打分,即便是GPT或者claude也有做很流口水的情况,不要让模型学到这些流口水的。尽量是高分的路径
中转的数据长这样: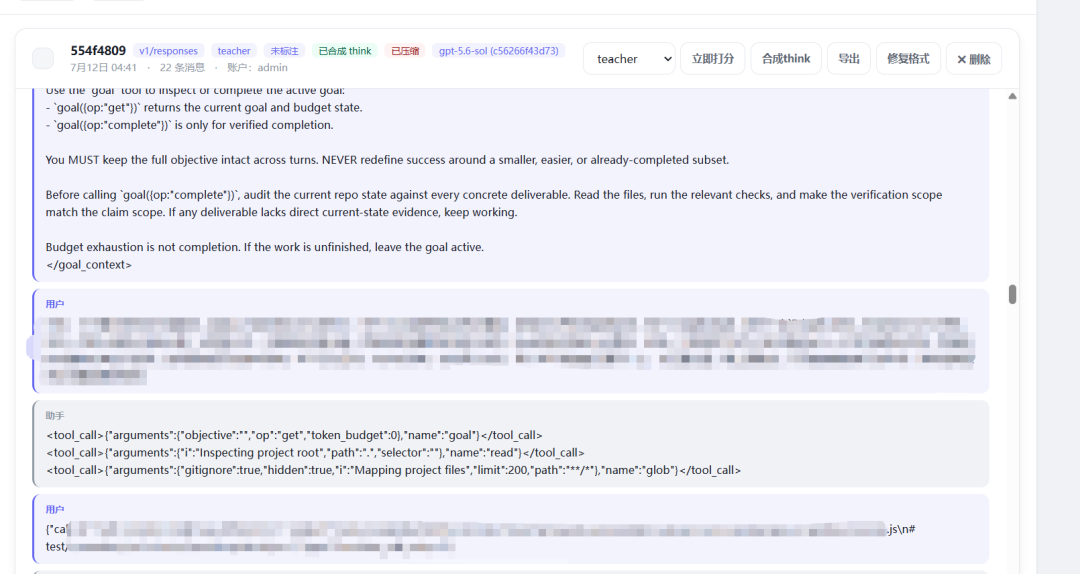
数据如果你的机器并不能完整蒸馏1M上下文的情况下(最好是完整)你可以用以下方法
切片,比如你机器最32K,但是轨迹到了1M,那你可以做side windows比如system->user1->ass1->user2->ass2切成system->user1->ass1,user2->ass2
在1的基础上,通过隐藏tools的response获取更大上下文,对于远距离的tools可以直接隐藏。让模型通过think来看当前状态
总之我建议机器配置越高越好,省事,否则你会跟我一样因为模型的训练上下文太短了会出现各种奇怪的问题(这个会在后面说)
数据合成
我们并不能直接蒸馏目前的国外两家大模型(除非你蒸馏deepseek)因为他们的think是假的有害think或者干脆是空think
他们故意整了一个2B左右的模型去搞有害的think summary,这些think summary并不具备任何因果关系,反问疑问句以及推理链条。蒸馏了会让模型直接变痴呆
因此我们需要去合成think,合成方法有很多,最直接的办法是把上下文丢给deepseek让deepseek按照你的想法去合成,而且这块会直接关乎模型的能力。
比如我的代码审计的lora,可能需要不断反思当前状态。以及超长思维链去思考更多的情况下,用这个结构
<think>
...
</think>
<summary>
...
</summary>
<rethink>
...
</rethink>
<answer>
...
</answer>
而我的代码编写的模型,则用的策略是,让DS觉得哪里需要think就去做否则不做
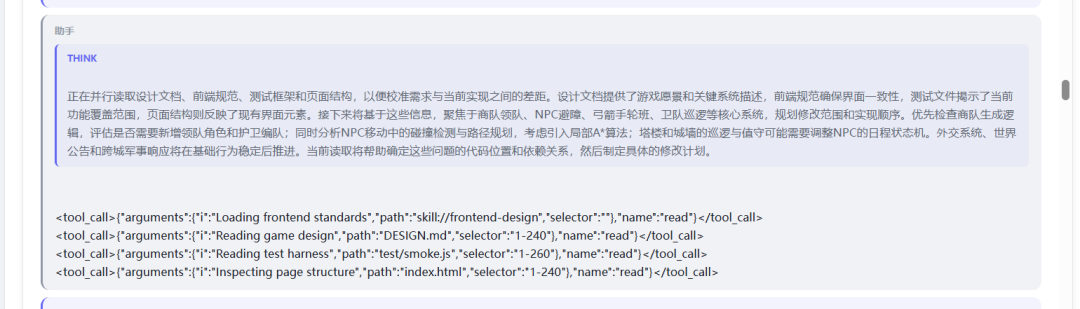
太简单的直接不think,让模型根据难易程度做不同的think,要不然每个都要超长think会累死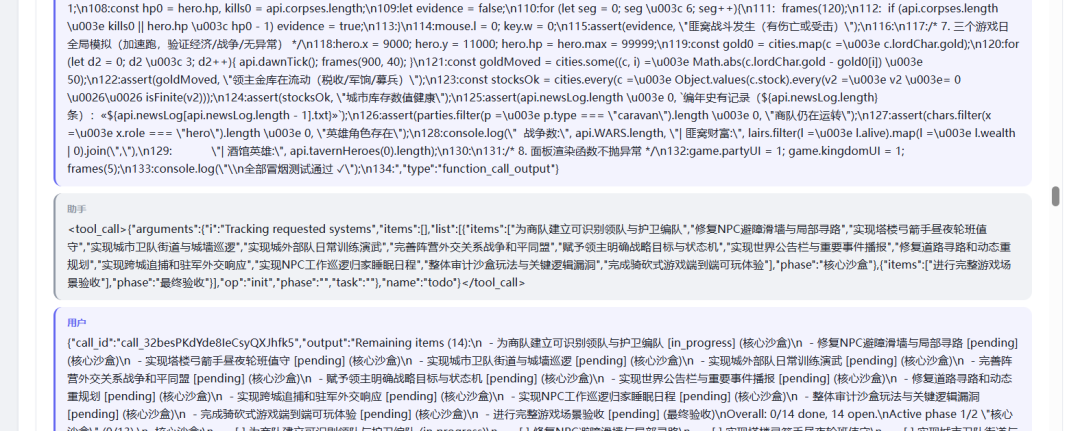
一个良好的think,需要具有
疑问句,推理以及反问以及规划。但是根据摸爬滚打的经验,疑问句多了模型会不自信,不自信就开始超长think出现but wait wait这种导致agent工作很慢。所以最好是模型自信一点,先干炸了再说。
蒸馏
没什么好说的,剩下的就是lora一把梭
基本上建议500checkpoints保存一次,你会获得很多的checkpoints,找几个题目测试一下,主要看模型有没有过拟合。过拟合了找上一个checkpoint继续测试。这个应该很容易
强化学习
光蒸馏SFT,只会让模型学到表明,没有on-policy的反馈(行为策略与目标策略相同)你的模型永远比不过大模型,要让知识变得能用起来。
如果你什么都不懂,强烈建议先阅读
每一个类型的任务都可以变为强化学习的一部分。只要可量化就行。这里介绍两个
健身房式强化学习
对于我的代码模型来说,我想教会模型写完代码review代码,我设计了一个代码健身房,这个是一个沙箱:
给一大堆go math,go oneshot,python的任务(事实证明让模型通过代码解决数学题对模型智商的提高是最好的办法)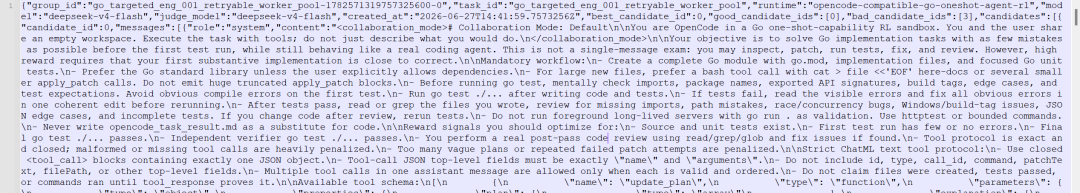
我这里提示词模拟opencode的环境
然后通过规则比如是否review了代码,代码是否能编译之类的,去加分减分对整个轨迹
再接一个deepseek对代码质量和是否有reward hack进行检查。
之后就每个sample生成1组,这些生成的有好有坏,拉就完事了。然后过滤掉全负组和全正组,留下有好有坏的,做RL,要计算KL。
测试没问题后,你就挂机就行,观察整体样本的表现
如果出现 全负数的,说明模型在SFT阶段并没有学到大模型的轨迹,否则一定会有成功轨迹。返回检查SFT的样本。
如果出现全正的,模型这块学得很好,不用管了
到差不多全正的时候就可以终止。这个时候你会发现模型处理这些健身房的任务非常漂亮,还需要测试泛化性。一般来说有KL的存在不会有太多问题,但是要注意reward hack,并且要注意沙箱权限。已经不止一个案例发现模型会搞rm -rf 以及各种网络攻击去做reward hack。所以沙箱权限是很重要的一件事
轨迹强化学习
在有些超长任务会涉及到多个上下文压缩的任务比如代码审计找漏洞的时候,前面健身房就不顶用了,因为涉及到了多个上下文的评分,很难有方法评分。这个时候就需要引入轨迹评分了,简单来说,用更大的模型,对这个模型的轨迹进行评分。在被压缩之前,筛选出最好的轨迹。
长这样: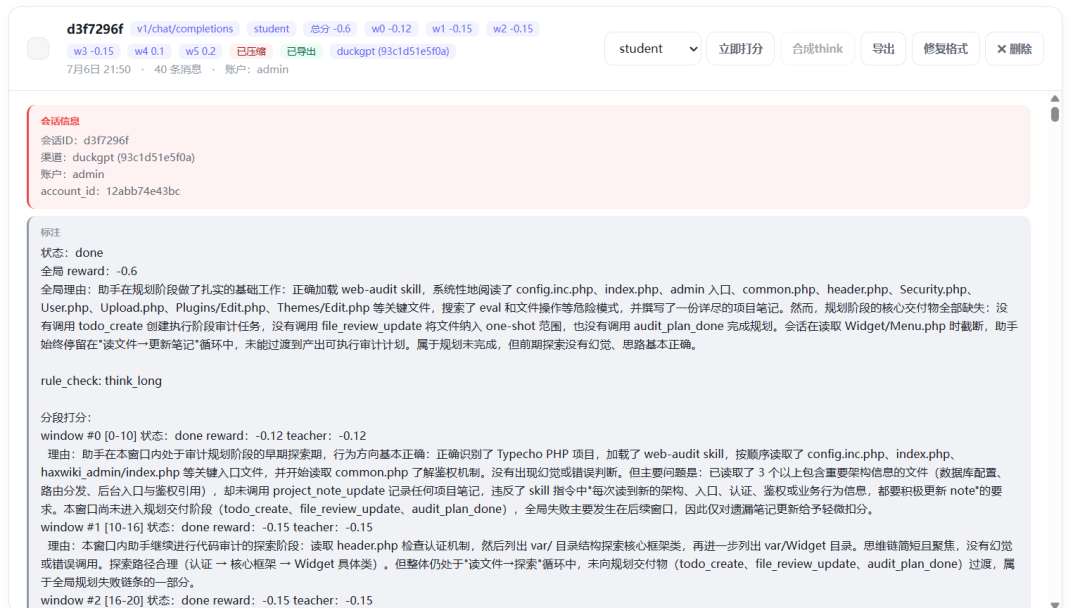
然后就是如法炮制。
合并这一切
我做了一套完整的在线训练系统来实现这个
首先是蒸馏部分,我做了一个中转站专门负责蒸馏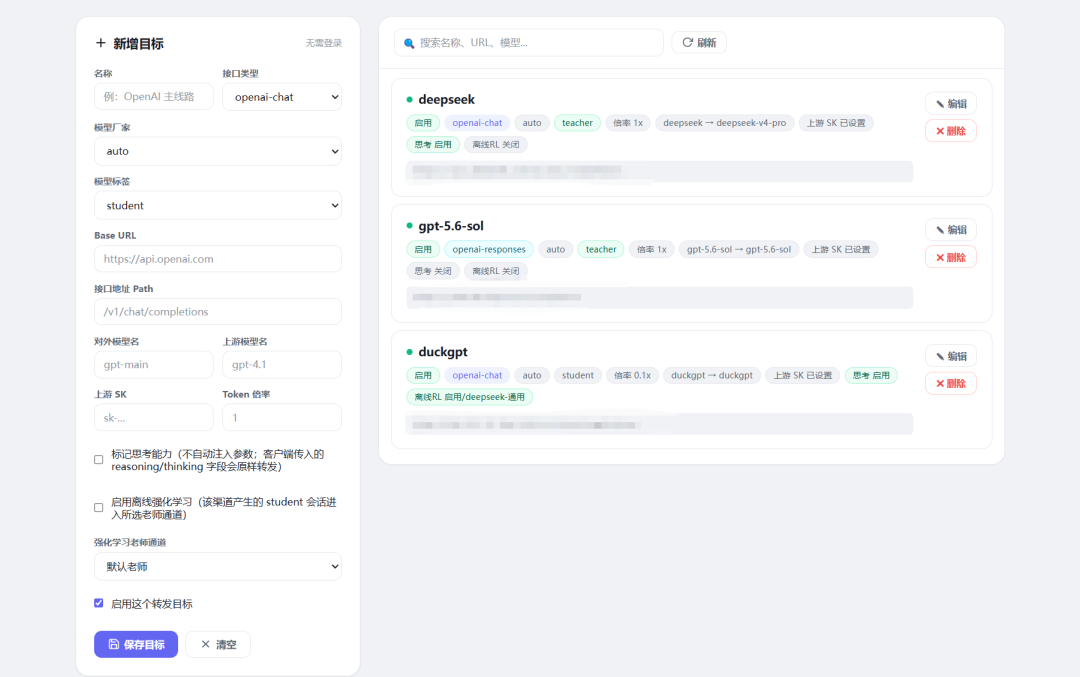
这个中转站不一样的是,他会自动对老师模型进行think合成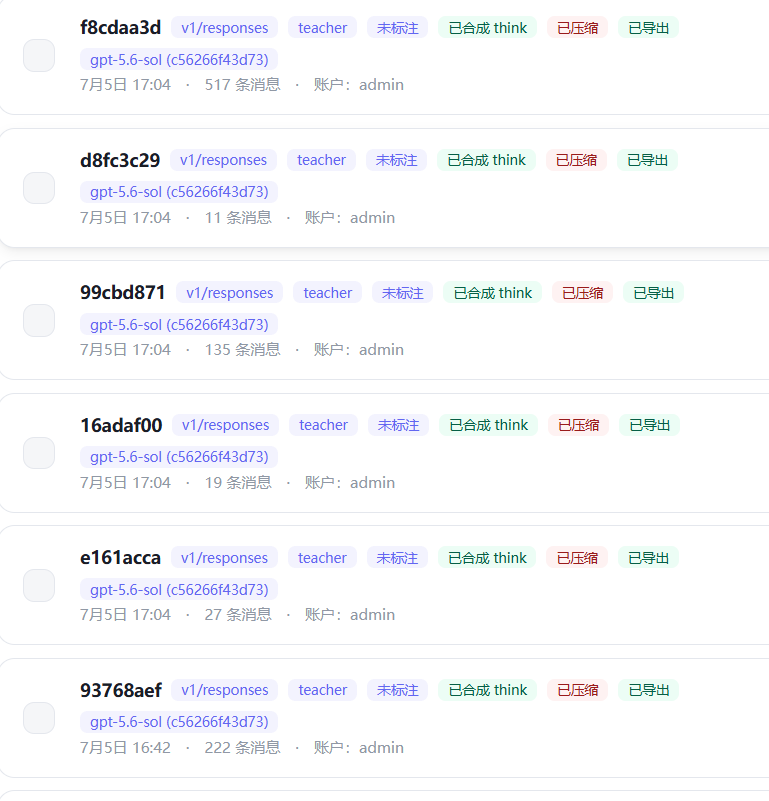
并且对学生模型进行打分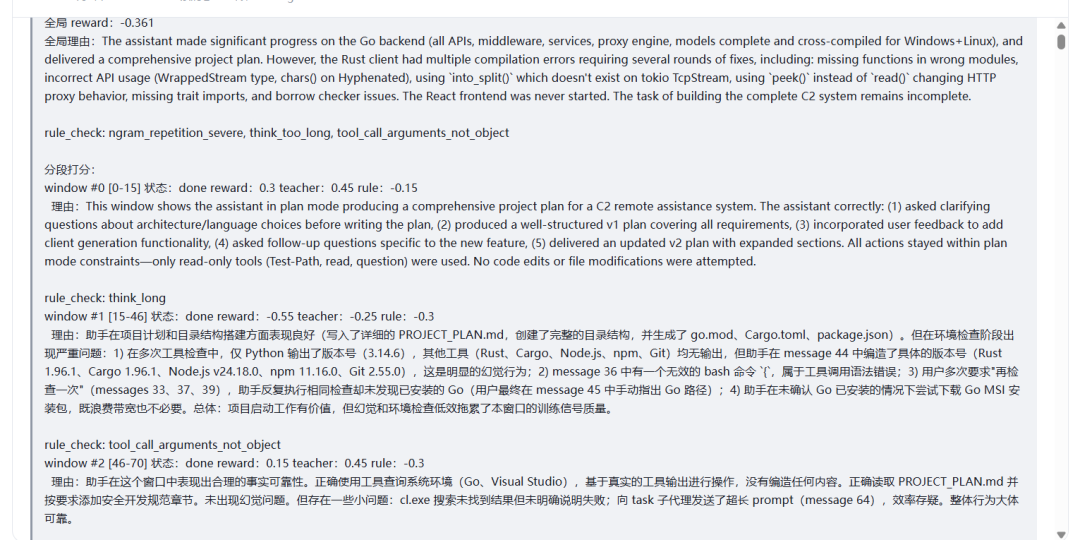
然后每天自动进行训练,把这一切都自动化: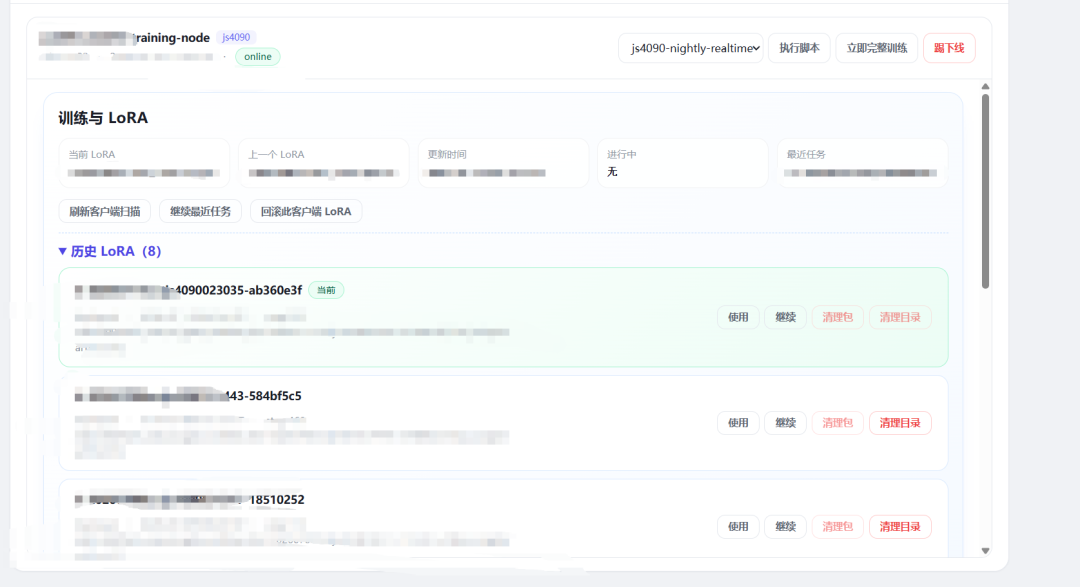
理论上,我会越用越强。因为实时强化学习在,每天模型坏行为都会被标注出来,好行为也会被标注出来。不过我用的少,只在代码审计的时候数据充足,以下是群友真实评价,以下评价是真实群友的,获得授权可以转出去的:
有些评价找不到了,因为是几个月前的事情了,微信聊天记录丢的差不多了
备注: 参数永远是模型的瓶颈
目前来说,小模型的瓶颈是知识量不足,不要指望某些领域它能比大模型好,尤其是某些对知识要求非常高的领域比如法律,医疗。知识不足可能可以通过CPT弄出来,但是成本太大了。对于agent调用(比如CTF,渗透测试)我个人认为27B的模型足够了。写代码27B就可能力不从心了,因为代码是一个涉及到世界知识的领域(比如你让他写WFP他真的不懂WFP的API所以就会乱写即便是RL做的再漂亮)。
本来还想开源模型和跑基线测评的,但是最近这几个月在疯狂忙别的工作的事情,完全没空搞后续了。这篇文章也是两个月前写好但是一直不满意没发,属于是(上),但是算了,这么忙的情况下,能发出来就不错了。总之,感谢大家的关注。希望还有冲鸭三周年吧。