通过命令行反馈利用大语言模型提高编译器选项黑盒模糊测试
原创 FuzzWiki 2025-06-18 15:15 四川

基本信息
原文名称:Enhancing Black-box Compiler Option Fuzzing with LLM through Command Feedback
原文作者:Taiyan Wang; Ruipeng Wang; Yu Chen; Lu Yu; Zulie Pan; Min Zhang; Huimin Ma; Jinghua Zheng;
原文链接:https://ieeexplore.ieee.org/document/10771447
发表期刊:ISSRE 2024
开源代码:无
一、引言
编译器在软件构建中扮演着核心组件的角色,编译器中的缺陷可能会导致编译失败,并引入潜在的安全漏洞,进一步影响编译后程序的质量和功能。因此通过软件测试和安全分析来确保其可用性和可靠性至关重要。目前,大多数研究集中在编译器在编译各种测试用例时的鲁棒性上,对编译器选项的可靠性缺乏关注。尽管一些研究人员已经在这方面做出了努力,但由于对编译器命令反馈信息的利用不足,导致测试效率低下,阻碍了更多样化和深入的测试。
在本文中,作者提出通过利用命令反馈来增强编译器选项黑盒模糊测试。其中命令反馈包括命令行消息和编译文件。命令行消息包括错误消息和标准输出。为了弥合错误与可能崩溃之间的差距,并使编译器能够自动修复运行时错误,提出了错误修复模块,将根据错误消息修改编译器命令行选项。为了挖掘隐藏在成功结果中的错误和崩溃,并减少运行时间,提出了选项修剪模块,将删除那些强制输出、掩盖崩溃的选项。上述两种方法都利用了大语言模型(LLM),并根据命令反馈消息和选项描述执行相应的操作。
本文实现的原型在4个版本的LLVM上进行了评估。实验表明,与基线相比,本文的方法显著提高了崩溃检测率,减少了假阴性,并提高了编译的成功率。迄今为止,该方法已经识别出9个以前未知的漏洞,其中8个已被分配CVE编号,1个在报告后得到了修复。
二、研究动机
编译器模糊测试有两种接口:编译测试用例和编译器选项。大多数研究专注于生成多样化且格式良好的测试用例,以在模糊测试过程中提高代码覆盖率,但往往忽略了编译器选项的测试,实际上,编译器选项能够启用特定功能(如优化),提供更大的测试多样性。此外,现有的黑盒模糊测试方法主要依赖生成的二进制程序中的变化作为反馈来引导测试过程,未能充分利用编译器命令输出中的关键信息,例如错误信息和成功输出。
而针对上述的问题,作者提出了本文的方法:
(1)深入研究了现有编译器选项模糊测试方法中大量的假阴性,并揭示了这些假阴性发生的关键原因。
(2)提出了一种新方法,利用大语言模型自动化执行选项修复和选项修剪的过程,从而减少假阴性,并提高编译器选项模糊测试的效率。
(3)通过性能实验和消融研究进行评估,与基准方法Cornucopia进行比较,评估在崩溃检测、减少假阴性以及提高编译成功率方面的效果。
三、概述
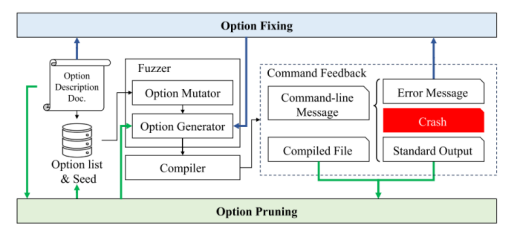
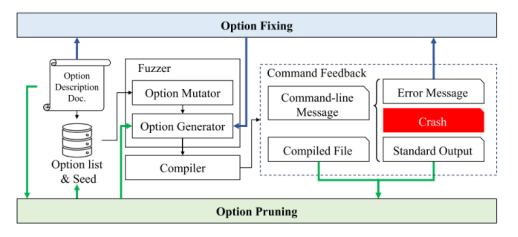
图 1 本文方法的工作流
本文的工作流如图1所示,包含了测试过程中的关键阶段。该方法从生成选项列表开始,选项列表来源于选项描述文档,包含了所有可供编译器直接在模糊测试中使用的选项。接着,模糊测试器利用选项列表中的选项集合生成命令行选项的组合,并将指示符替换为指定范围内的随机数据。最后,测试中的编译器将被调用,使用各种选项组合,并监控是否发生崩溃,记录所有崩溃输出以及错误和成功的结果。
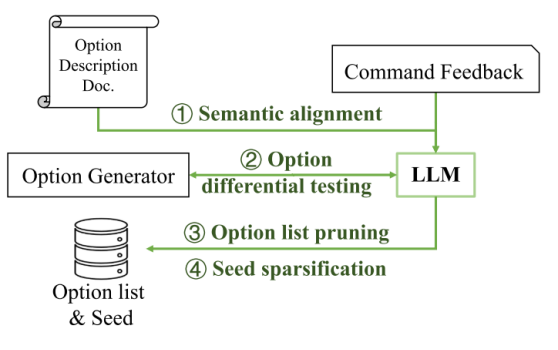
除了常规流程外,本文提出了两个模块来减少假阴性:选项修复和选项修剪。选项修复模块利用编译器测试产生的命令反馈中的错误信息。基于LLM,依靠网页搜索引擎和本地编译器选项描述文档,执行检索增强生成(RAG),最终提供如何修复相应命令行选项组合的建议,以消除错误。选项修剪模块利用标准输出和已编译文件来判断是否存在阻碍崩溃输出的信息,或者是否为无效编译导致空输出文件。同时,使用LLM对选项描述文档进行语义对齐,通过差异测试识别出控制相应消息打印的特定选项。通过从选项列表中去除这些选项以减少时间消耗并揭示隐藏的崩溃。
1.初步模糊测试
本文的方法从初始的模糊测试阶段开始,该阶段对收集后续过程所需的关键信息至关重要,由四个不同的阶段组成。
(1)生成选项列表:解析选项描述文档以生成选项列表作为语料库。选项描述文档可以来源于帮助页面和在线文档。对于不需要值的选项,通过包含或排除来使用;对于一个值有范围的选项,则列举该选项的所有可能值并将其包含在选项列表中;对于有些值过分广泛的选项,用指示符<int>和<str>来描述。
(2)生成选项组合:使用选项列表中所有可能的选项生成选项组合
(3)变异:根据选项变异模块进行变异。当模糊测试器遇到指示符时,它会将随机种子中的特定部分解析为“< str >”的字节串,并使用取模操作将“< int >”的值限制在指定范围内。
(4)编译并收集命令反馈:使用生成的选项组合执行编译器并收集所有命令反馈,包括命令行消息和编译文件。持续监控运行状态,以确保及时报告发生的任何崩溃。
2.选项修复
在初步模糊测试阶段之后,利用结果测试数据(包括编译器命令反馈消息和编译输出文件)来帮助修复编译错误。选项修复过程与模糊测试循环并行工作,为模糊测试器提供修复后的选项组合进行执行。通过这种方式,可以发现隐藏的崩溃,并且甚至可以实现自动编译。
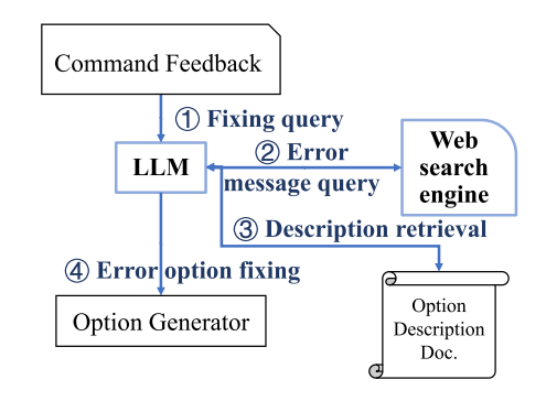
选项修复过程依赖于两个新集成的组件:一个用于查询的LLM,能够根据测试结果提供潜在的修复方案;一个供LLM使用的网络搜索引擎,用于获取在线资源以提高准确性。如图2所示,选项修复模块包括以下四个步骤。
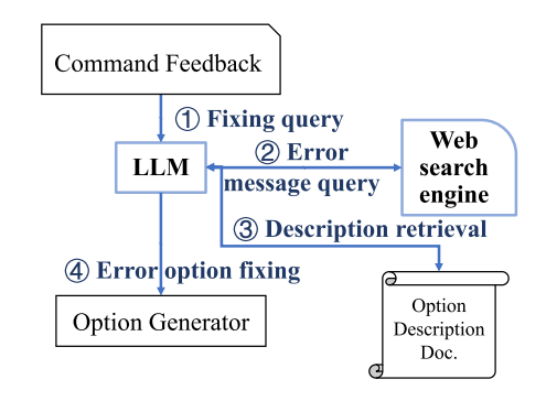
图 2 选项修复模块工作流
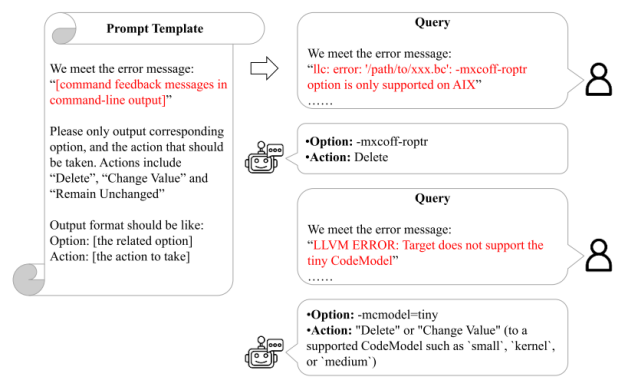
(1)修复查询:首先,报告错误的测试结果被用于查询LLM,以获取这些错误的原因及解决方法。为了与LLM有效互动,需要使用提示语,理想的提示语应尽可能详细,包括示例和具体指令,如图3所示。
为了纠正错误,本文定义了两种主要的候选操作:“删除”和“更改值”。“删除”操作涉及完全移除有问题的选项,而“更改值”操作则是为该选项选择一个不同的适当值。为了避免开启更大的选项搜索区间,该方法暂不考虑“添加其它选项”。
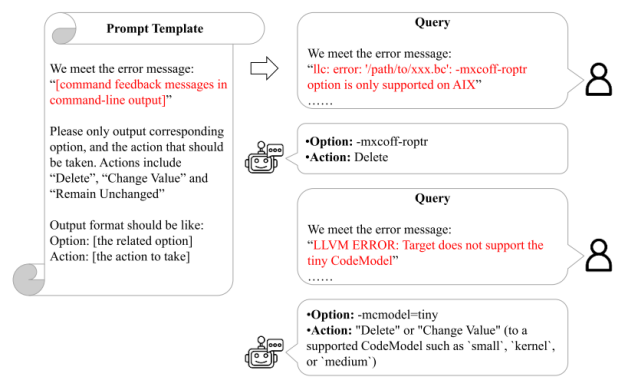
图3 选项修复的提示语
(2)错误信息查询:LLM利用搜索引擎搜索与错误信息相关的额外文章。通过进行实时在线搜索,LLM能够收集有关错误原因和潜在解决方案的更全面信息。这些额外的信息增强了LLM响应的可靠性。
(3)描述检索:在进行错误信息的在线查询后,LLM获得了对错误原因和潜在解决方案的初步理解,但这些信息仍需进一步验证。检索增强生成(RAG)通过参考其训练数据源之外的权威知识库来增强LLM回答的可信度。本文将编译器选项的描述文档视为这样的外部知识库,有利于判断是删除该选项,还是将其更改为不同的值。
(4)错误选项修复:一旦LLM处理了查询并从描述文档中检索到相关信息,它就会生成修复选项的策略,如图3所示。输出结果包括与错误相关的选项以及需要采取的具体行动,如删除或更改值。
接下来,对识别出的选项应用指定操作,并通过操作选项生成器重新运行编译器。如果错误未完全解决,将启动迭代过程:当错误消息不变时,触发三层循环提示,重复查询,直到出现新错误消息或同一错误消息出现三次。若出现新错误,则为其启动新的三层循环提示;若同一错误出现三次,则结束提示并处理下一个错误案例。这一迭代过程旨在有限时间内尽可能解决更多错误。
3.选项修剪
选项修剪阶段的目的是删除会导致强制信息输出的选项,从而提高效率,减少被隐藏的崩溃。选项修剪在下一轮模糊测试之前以串行方式执行,它准备了一个修剪后的选项列表,用于在模糊测试过程中生成测试用例。该模块同样是基于LLM构建的,如图4所示,包含以下四个步骤。
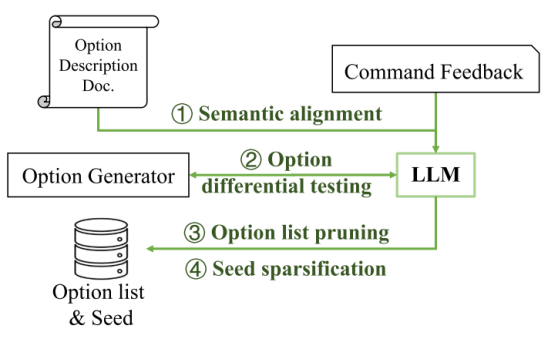
图4 选项修剪模块工作流
(1)语义对齐:为了修剪不相关的选项,首先通过语义对齐识别输出类型的选项。利用LLM分析选项描述文档,判断选项是否属于输出类型;从输出消息开头的前十行中提取信息,确定输出类型,并与选项描述文档进行语义对齐,识别对应的输出选项;通过差异测试验证已识别的选项,确保其准确性。该过程中设计的提示语如图5所示。
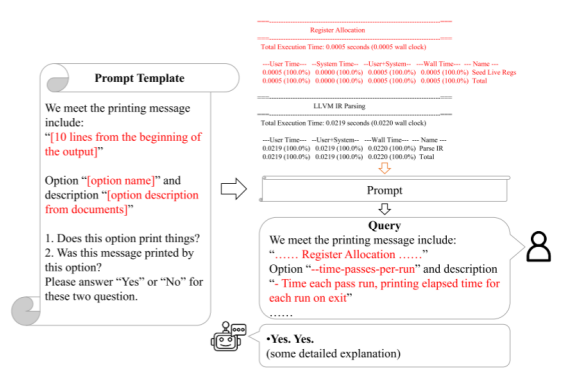
图5 选项修剪的提示语
(2)选项差异测试:差异测试从崩溃概念验证(PoC)开始。一旦通过语义对齐识别了选项,通过将每个选项单独添加到崩溃PoC中,检查它是否会导致崩溃或改变状态。如果修改PoC后没有发生崩溃,则新增的选项被验证为阻碍崩溃发现,必须进行修剪。
(3)选项列表修剪:将待修剪的选项从选项列表中删除。由于仍然存在被修剪的选项可能导致崩溃的可能性,所以必须收集历史运行状态数据,以决定是否移除或保留它们,以便触发更多的崩溃。如果某个选项曾经出现在导致崩溃的组合中,则不建议移除它。若选项不与任何崩溃相关联,则更适合将其移除。
(4)种子稀疏化:将种子字节稀疏化到一个新的分布空间中。该方法涉及减少种子值的范围,使得种子主要由二进制“0”组成,且包含较少的二进制“1”。这意味着生成的选项组合中使用的选项数量将减少,并且本文的实验表明,这种方法在一定程度上是有效的。
4.来自LLM的错误答案的影响
在选项修复和修剪过程中,LLM的输出可能存在的随机性和错误答案。
在选项修复过程中,LLM可能提供错误答案(如删除错误选项或替换错误值),导致原始错误保持不变或引入新错误。但本文设置了三层循环机制,通过三层循环提示过程处理错误,每个错误最多只有三次修复机会,若未解决则结束该进程,时间和资源消耗有限。该过程对LLM错误答案有一定的弹性。
在选项修剪过程中,LLM的错误结果可能会提供与编译器输出无关的选项,这些选项将通过选项差异测试来处理。若一个选项通过了差异测试,则会检查历史崩溃信息,确认其是否是已知崩溃的原因,可能潜在触发漏洞的选项会被保留。
5.具体实现
整个模糊测试框架基于AFL++,其变异模块由Cornucopia实。代码使用Python编写,主要用于解析选项文档,将其转化为可用选项列表,并生成随机种子。
选项修复模块使用Python实现,并在每轮模糊测试后操作模糊器中的选项生成器。选项修剪模块也使用Python实现,并集成到模糊测试框架中进行离线处理,控制种子生成和选项生成器。
在选项修复和选项修剪模块中,作者根据LLM的不同需求做出了不同的选择。对于选项修复,它需要在线检索能力,因此选择了商业版Microsoft Copilot,由Bing在线搜索引擎提供支持。此外,由于需要文档检索,部署了基于LangChain-Chatchat项目的RAG服务。对于选项修剪,它需要LLM实现语义对齐,本文尝试了开源LLM,如Vicuna、Alpaca、LLaMA和RWKV。通过实验发现基于GLM的开源ChatGLM3-6B与LangChain-Chatchat提供的RAG支持配合得最好。
四、实验
本文在三个实验中评估了本文原型的实现。首先,检查是否能在基准测试中检测到比现有工具更多的崩溃,并比较其与现有工具在假阴性方面的表现。其次,分析本文方法所提出的各个组件是否促进该有效性。最后,研究是否能够在现实世界中发现新的漏洞。
1.实验设置
环境:所有实验均在使用Intel Xeon Gold 6230R CPU@104×4 GHz和256 GB内存的专用服务器上进行。 对每个目标和测试用例的组合并行进行了模糊测试,使用相同的配置在20个CPU核心上运行了2小时。
目标:在C/C ++编译器框架LLVM中进行了评估,专门针对其内部工具链,其中包括Clang,Opt,LLC,LLI等工具。本文仅对命令行选项进行模糊测试,因此会使用一组没有语法错误的良性测试用例集进行编译。 这种方法能够消除测试案例的影响并专注于选项。
基线:由于本文是基于Cornucopia测试结果的观察,并且还基于cornucopia来构建本文的方法,所以选择cornucopia作为比较基线。本文方法包括两个新增模块:选项修复和选项剪枝。选项剪枝模块又包含两部分:种子稀疏化和选项列表剪枝。因此,在消融研究中,共有八个版本的方法来展示。
指标:采用触发的崩溃crash数量作为度量标准,因为这本质上是模糊测试的目标。独特崩溃的数量是另一个评估指标,因为不同根本原因导致的崩溃数量可以在一定程度上反映黑盒测试中的代码覆盖率。
2.实验1:有效性
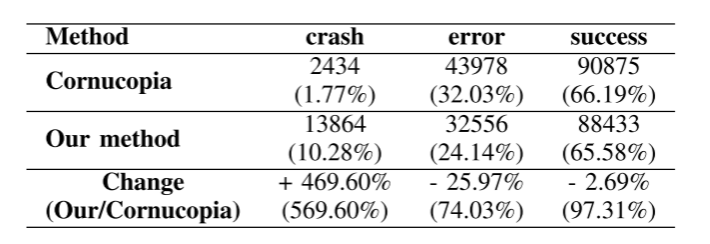
表1 不同测试结果的统计
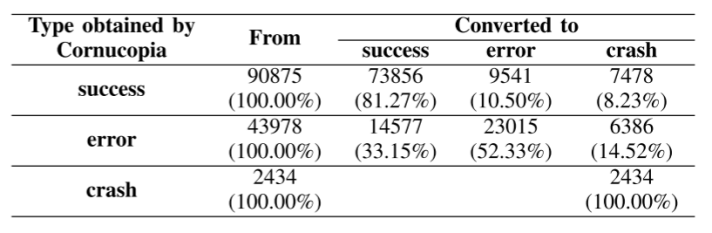
表2 不同测试结果转换的统计
本文的方法旨在改善错误和成功测试结果中的假阴性案例,为了证明该方法的有效性,分别对错误和成功测试结果的变化进行了全面的统计分析,并记录了崩溃的次数。
表1统计了基准Cornucopia和本文方法的测试结果,并比较了二者之间测试结果数量的变化。表中数据显示,本文的方法能够发现比基准显著更多的崩溃,增加了569.60%。错误结果数量的减少表明方法有效地解决了错误。表2说明,通过本文的方法,Cornucopia获得的大约18.73%的成功结果被转化为崩溃或无法处理的错误,大约47.67%的错误结果被转化为成功编译或崩溃。这些数据展示了本文工作在实现自动化成功编译方面的有效性。
独特崩溃的数量是评估模糊测试效果的重要指标之一。LLVM在崩溃时会生成“堆栈转储”,可以在修剪地址信息后通过比较堆栈跟踪来对崩溃进行分类。作者收集了从成功/错误结果到崩溃结果的转换数据,并将其记录在表3中。
通过本文的方法,观察到大约8.23%的原始成功结果和14.52%的原始错误结果被转化为崩溃,从而导致崩溃总数显著增加。独特崩溃的数量增加了245.36%。
表3 唯一崩溃数量的统计
3.实验2:消融实验
在5.2中,选择了一组多样化的通用测试用例进行编译,其中包括来自 coreutils及其他软件包的代码片段。在消融实验中,仅选择了来自 augeas-tools软件包的单个代码片段augmatch,以使实验规模更小且更高效。
本文将八个版本进行对比:基线方法Cornucopia、带有种子稀疏化的基线方法、带有选项列表修剪的基线方法、同时包含两部分选项修剪的基线方法,以及另外四个对应的版本,这些版本额外包含选项修正模块。
如表4所示,记录了每个实现版本的总崩溃次数及唯一崩溃次数。括号中的数字表示唯一崩溃的数量。
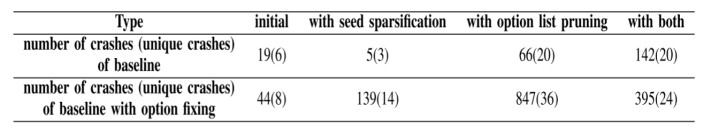
表4 消融实验中的崩溃数量统计
选项修正模块在模糊测试中的作用更多是优化而非核心支持,而选项修剪模块则在整个模糊测试过程中对崩溃发现的贡献最为显著。具体而言,选项修剪将总崩溃次数从19次(包含6个唯一崩溃)显著提升至142次(包含20个唯一崩溃),而选项修正仅将总崩溃次数增加至44次(包含8个唯一崩溃)。尽管如此,表4下半部分展示了包含选项修正模块的四个版本相较于上半部分的版本,发现了更多的唯一崩溃,这表明该模块在提升测试效果方面具有一定的有效性。
在选项修剪过程中,选项列表修剪操作对崩溃发现能力的提升贡献最为显著,且具有持续性。相比之下,种子稀疏化仅在特定条件下表现出有限的效果,甚至在仅应用于基线方法时,导致崩溃次数从19次(包含6个唯一崩溃)下降至5次(包含3个唯一崩溃)。为了在实际应用中平衡效果与性能,仅对50%的种子执行种子稀疏化操作。
4.实验3:漏洞检测
因为最终导致崩溃的实际触发命令包含大量选项,其中导致崩溃的关键选项隐藏在众多可用选项中。为了进一步研究本文方法如何从误判为非崩溃的测试结果中发现崩溃,以及如何处理崩溃以确定其是否是独特的,再次展示一个来自实验的真实案例。
(1)案例研究:对最新版本的LLVM进行了初始模糊测试,选择图6所示的命令作为分析起点。所有带有冗余打印消息的成功结果都会经过选项修剪模块处理。在所有成功结果中,大约 26.85%与图 6(a) 所示的命令消息相同。
通过选项修剪模块的语义对齐阶段,自动识别出选项“--version”是这些消息的触发因素。选取初始模糊测试阶段检测到的一次崩溃,并在 PoC命令中添加“--version”以检查崩溃是否仍然发生。结果发现崩溃消失了,这证明“--version”可能会掩盖崩溃。因此,该选项被从选项列表中移除。在去除“--version”后提取结果,使其从图 6(a) 过渡到图6(b) 中的错误结果。通过与LLM的交互修正该问题。
随后,编译命令再次成功执行,但它生成了一个空的编译文件,并伴随新的命令反馈消息,如图6(c) 所示,这表明命令仍然存在问题。在选项修剪模块的语义对齐阶段,识别出该输出消息由“--opt-bisect-limit”选项引起,因此将该选项从选项列表中移除。最终成功触发了一次崩溃,如图6(d) 所示
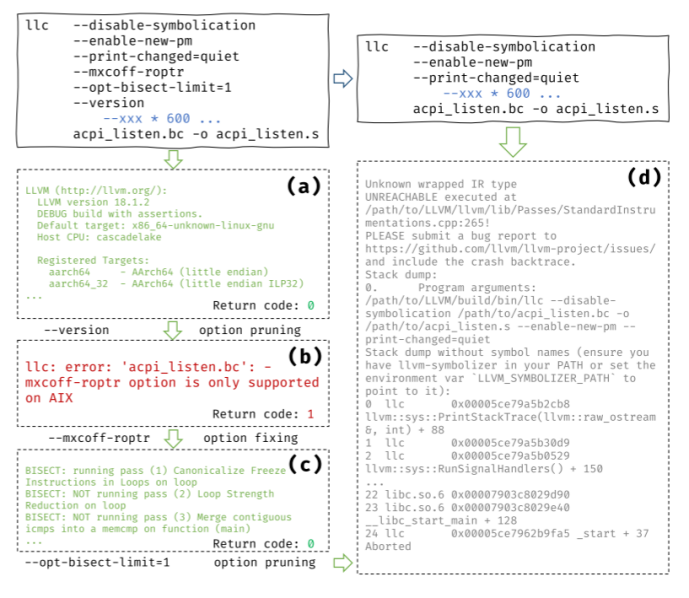
图6 一个真实案例的研究
(2)真实漏洞:对LLVM 框架的四个版本(12.0.0、14.0.0、16.0.6、18.1.2)进行了全面测试,检测到的漏洞总体统计数据列于表5。由表可知,检测到的漏洞总数在较高版本中呈增加趋势,这可能是由于 LLVM 版本升级后选项数量的增长,例如:LLVM-12.0.0具有1148个选项,LLVM-14.0.0具有2385个,LLVM-16.0.6具有2009个,而LLVM-18.1.2具有2594个。另一个可能的原因是在选项修正模块的检索增强生成阶段,缺少在线支持,导致修正效果受到一定影响。
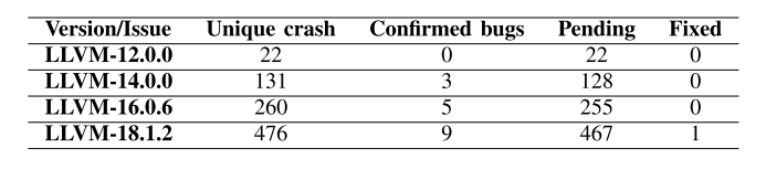
表5 在不同版本LLVM中检测到的bug的统计数据
所有唯一崩溃均由脚本根据堆栈转储自动计算,而所有已确认的漏洞则经过人工分析,因此数量相对较少。本文主要关注最新的LLVM-18.1.2 版本中的崩溃,并尝试将相同的 PoC 应用于其他较低版本。所有已确认的漏洞均已上报至社区,其中一个已被修复,但仍有数百个崩溃待分析。
最终,有8个漏洞被分配了CVE编号,另一个问题仍在处理中。每个漏洞都与LLVM的某个组件相关,表6列出了相关工具,包括bugpoint、opt、llc、clang-repl、lli、clang-import-test 等。表中列出的每个工具都有其特定功能,例如:bugpoint通过简化有缺陷的位代码文件来帮助定位漏洞;opt 用于优化 LLVM 中间表示(IR)。由于这些工具都属于 LLVM 框架,并共享多个关键组件,它们的功能和代码之间存在一定的耦合关系。
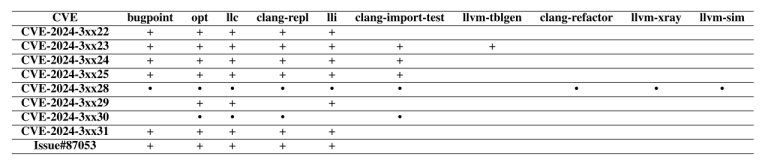
表6 确认的漏洞细节和相关工具
五、讨论
在本文中,作者研究了当前编译器选项模糊测试方法中普遍存在的假阴性问题,具体表现为:错误结果中的崩溃被错误消息掩盖,以及成功结果中的崩溃被强制标准输出信息隐藏。为解决这两类假阴性问题,设计了选项修正模块和选项修剪模块,以增强现有的黑盒模糊测试框架。这两种方法均利用了LLM的智能语义理解能力。在受控且一致的计算环境与时间约束下,评估结果表明,所提出的方法显著降低了假阴性率,提升了崩溃检测性能,并发现了额外的唯一崩溃。
—END—

Beyond REST:一种用于全面API漏洞模糊测试的工具APIF
Towards Generic DBMS Fuzzing:面向通用数据库的模糊测试