MonkeyScan 硬刚 Codex Security:多找回22个真实漏洞,成本仅1/5
原创 夺旗猫 2026-08-14 15:59 北京
我们用MonkeyScan 和 Codex Security 做了一场真实的AI代码审计测试。
7 月底,OpenAI 开源了代码安全审计工具 Codex Security CLI。不到半个月,GitHub 星标(Star)接近 1 万,AI 代码审计迎来了一个能打的新选手。
MonkeyScan 今年 4 月上线,同样主打 AI 原生代码审计。看到 Codex Security 开源,我们的第一反应很兴奋:
既然大家是同一条赛道,那就别只看产品介绍了,竞技场上见真章,咱们真刀真枪 PK 一把!
我们把 Codex Security 和 MonkeyScan,放进同一批已知真实漏洞的代码中,提出三个大家最关心的问题:
谁找回的漏洞更多?谁的误报更少?谁花的钱少?
先搭一个公平的竞技场
在具体测试数据的选择上,为保证测试公平,我们没有自己制定评分标准,而是从公开的基准测试集(benchmark)中选择测试对象。
我们先让 GPT 推荐,2026年最适合评估 AI 源码审计工具的公开基准测试集。
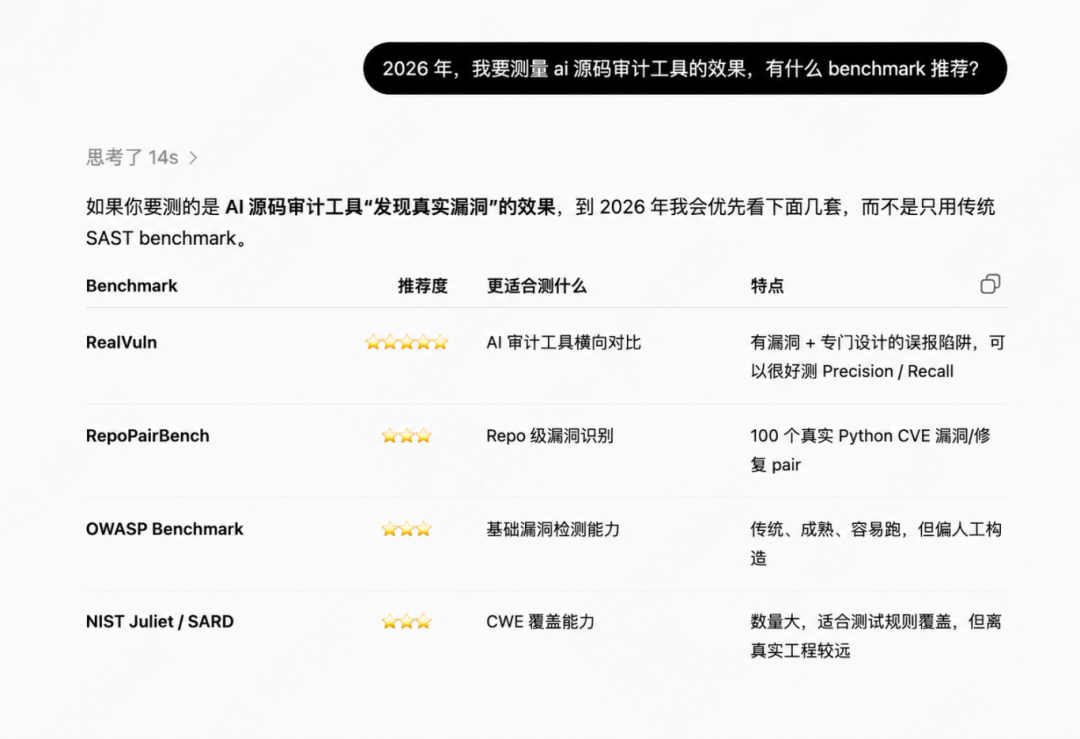
在推荐结果中,RealVuln 排在首位。它包含经过人工确认的真实漏洞,也专门设置了容易诱发误报的代码。
它公开了三项核心指标:查准率(Precision,即报告中有多少是真的)、检出率(Recall,即真实漏洞中找回了多少),以及更看重少漏报的 F2 综合分。
好,就是它了!
在正式测试前,我们又人工核对了 RealVuln 的真实漏洞清单(ground truth)、固定源码版本(commit)和官方评分程序(scorer),确认每一个正确检出(TP)、误报(FP)和漏报(FN)都可以复现。
本轮测试,从 RealVuln v2.0 中选取了 3 个可本地复现、源码版本可以锁定的 Python Web(网页应用)项目:
DSVW:27 个真实漏洞;
DSVPWA:32 个真实漏洞;
Damn Vulnerable Flask Application:15 个真实漏洞。
合计 74 个真实漏洞,开始。
结果:57 比 35,MonkeyScan 多找回 22 个真实漏洞
三轮扫描结束后,先给出大家最关心的结果:
57 VS 35:MonkeyScan 多找回 22 个真实漏洞
77.03% VS 47.30%:MonkeyScan 检出率高出 29.73 个百分点
35 元 VS 200 元:本轮界面 MonkeyScan 可见成本折算约为Codex Security的 1/5
Codex Security 唯一领先的指标是查准率:66.04%,MonkeyScan 为 59.38%。
但大家都清楚,对安全审计来说,漏掉一个真实漏洞,意味着研发团队连复核它的机会都没有。
所以,RealVuln 选用 F2 综合分作为主指标,因为它更看重检出率、更看重少漏报。而在 F2 指标上:
MonkeyScan 为 72.7,Codex Security 为 50.1
这些数字是怎么算出来的
为了让结果可以复核,我们没有人工挑选"看起来更像漏洞""的报告,而是统一交给 RealVuln 官方评分程序(score.py)计算:
1. 三个项目的源码版本与 RealVuln 真实漏洞清单中固定的版本完全一致;
2. 两款工具扫描相同源码,只统计最终扫描发现项;
3. 扫描结果统一转换为 Semgrep 兼容的 JSON 结果格式;
4. 官方匹配规则(matcher)根据文件路径、RealVuln 接受的漏洞类型(CWE)和真实漏洞所在代码行的上下 10 行范围计算;
5. 每个真实漏洞最多被命中一次,没有匹配到真实漏洞的报告计为误报(FP),没有被找回的真实漏洞计为漏报(FN)。
同一份代码仓库,两款工具实际怎么跑
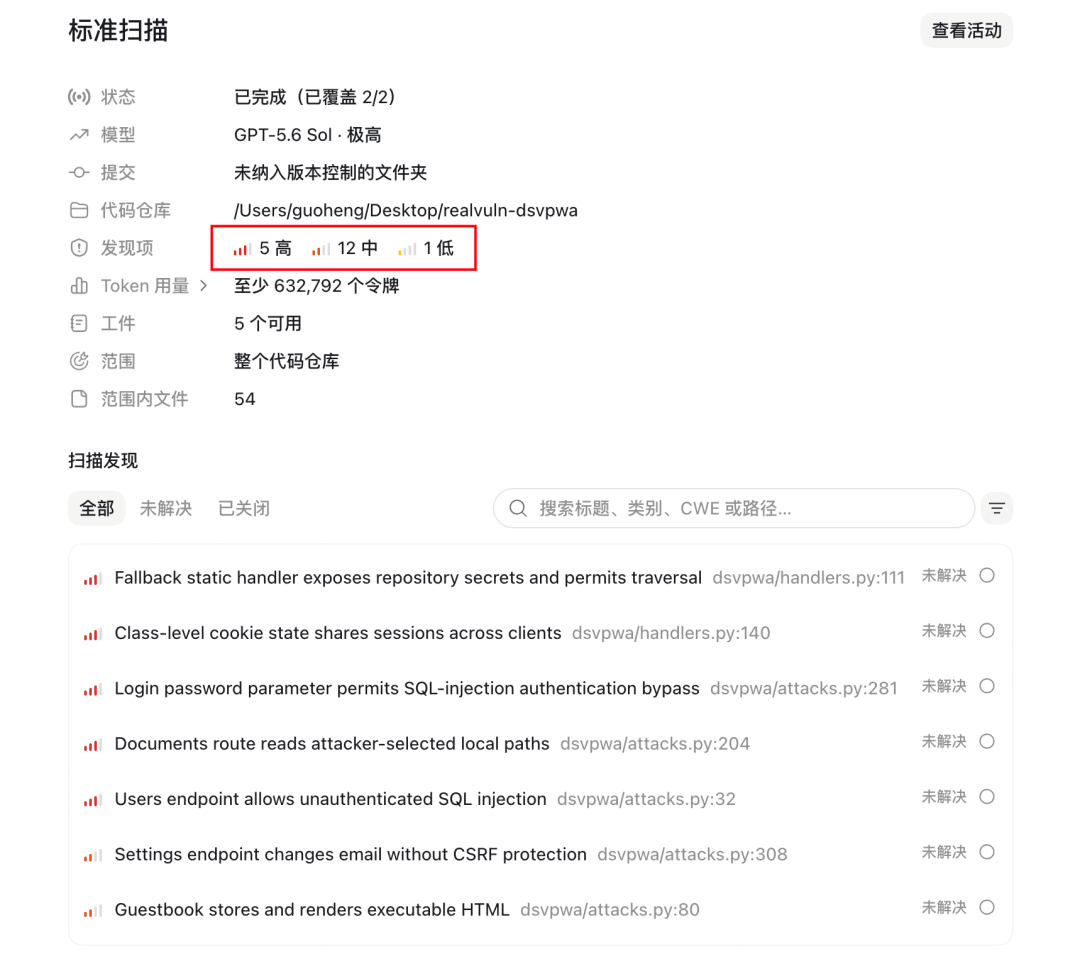
下面是两款工具扫描同一版本 DSVPWA 后的最终页面。
Codex Security:18 个扫描发现项
MonkeyScan:44 条已验证缺陷
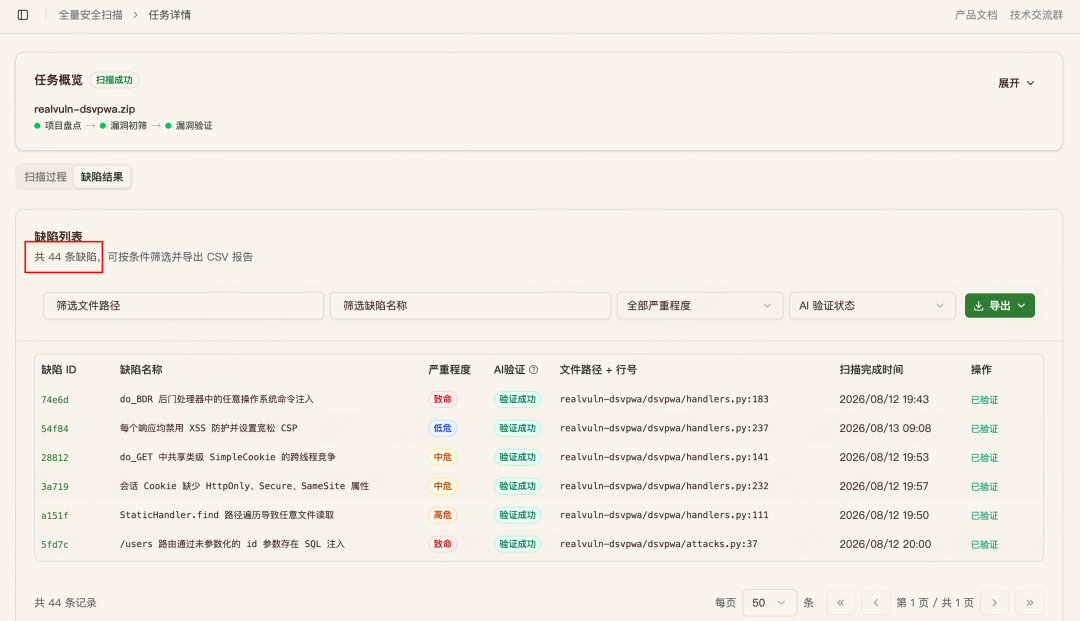
18:44,但报告漏洞的数量不代表最终胜负,这里我们还不能宣布获胜。
因为 44 个发现项不等于命中了 44 个真实漏洞,18 个发现项也不代表只能发现 18 个漏洞。最终仍由 RealVuln 官方评分程序判断哪些属于正确检出、哪些属于误报,以及还有多少真实漏洞被漏掉。
继续看详细结果。
三个项目逐项对比
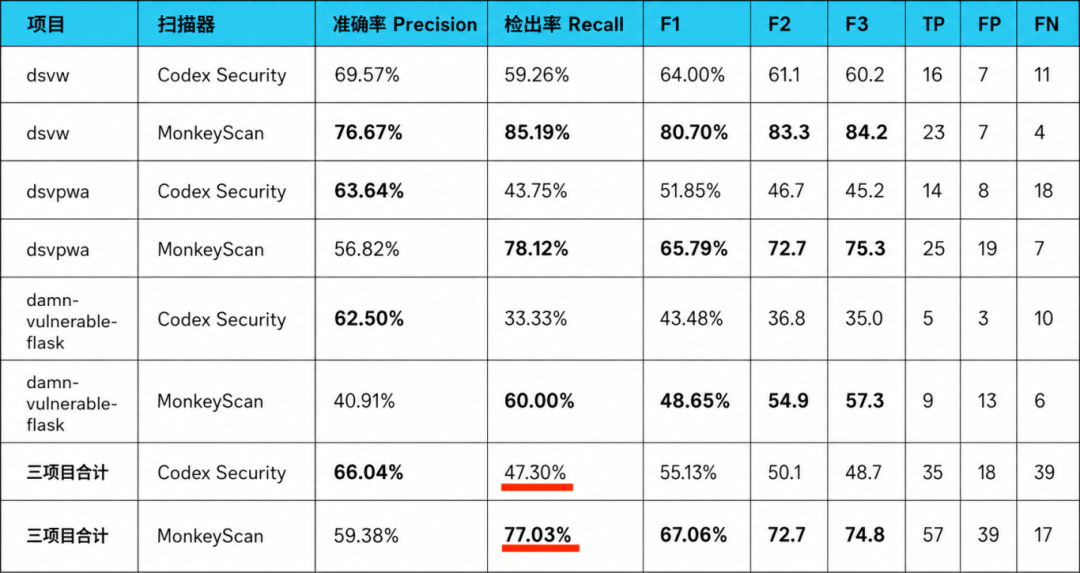
逐项对比,三组结果呈现出相同的趋势:
DSVW:MonkeyScan 的查准率、检出率和 F2 综合分均高于 Codex Security;
DSVPWA:Codex Security 的查准率更高,但 MonkeyScan 命中 25 个真实漏洞,Codex Security 命中 14 个;
Flask:这个项目比较有挑战,MonkeyScan 的检出率为 60%,Codex Security 为 33.33%。
三个项目合计后,MonkeyScan 找回 57 个真实漏洞,Codex Security 找回 35 个;MonkeyScan 的漏报为 17 个,Codex Security 为 39 个。
对安全团队而言,这 22 个额外找回的真实漏洞,正是更高覆盖率最直接的价值。
多找回 22 个,但成本仅为 1/5
说完了检出效果,再来看看安全团队同样关心的成本问题。
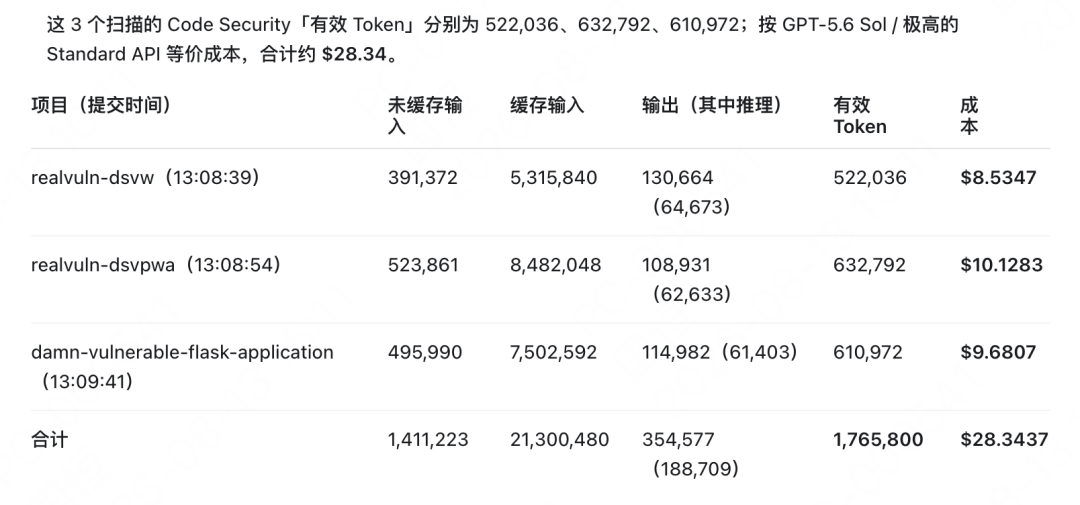
本轮测试,Codex Security 三次扫描合计消耗 1,765,800 个有效 Token(模型处理量)。按 GPT-5.6 Sol、极高推理强度的 Standard API(标准档接口)等价成本估算,约为 28.34 美元,折合人民币约 200 元。
MonkeyScan 三次扫描合计消耗 2723 积分。按当前 39 元 / 3000 积分的零售价折算,约为 35 元。
这对安全团队是个好消息,MonkeyScan 找回的真实漏洞更多,但成本仅为 Codex Security 的 1/5。不用担心费用,可劲用。
为什么 MonkeyScan 更能打
下面,简单和大家解释下MonkeyScan 为什么能做到这些。
MonkeyScan并不是让更多 AI 智能体(Agent)重复阅读同一份代码,而是先理解整个仓库,再把推理预算投入更值得检查的位置。
扫描开始后,MonkeyScan 会先识别项目使用的语言、框架、入口、函数和调用关系,建立仓库级的代码知识;随后根据目录、复杂度和风险目标,把审计任务拆给多个智能体并行执行。
第一轮结束后,系统还会继续检查高风险路径中的覆盖缺口,只对复杂候选追加深度分析,并根据智能体实际阅读过的文件和代码区间判断证据是否充分。
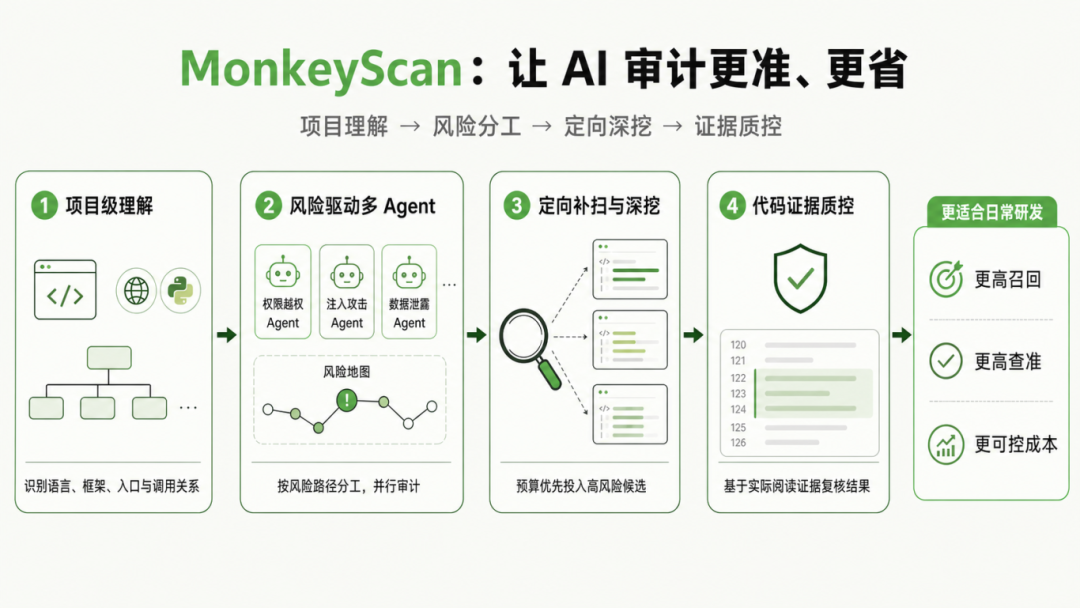
简单来说,它的工作方式是:先理解项目,按风险分工,再补扫缺口,把更贵的推理留给真正复杂的问题。
这些特点,让 MonkeyScan 在本轮测试中用更少的成本,找回了更多真实漏洞。
下一次测试,应该发生在你的代码里
公开基准测试集给出了一个可复现的结果,但真正重要的测试,应该在你自己的代码仓库里。
为了让大家可以直接体验 MonkeyScan ,现在新用户注册即可获得 3000 积分,足够你跑一个自己的测试。
MonkeyScan支持 GitHub 仓库和 ZIP 源码扫描,真诚地邀请大家体验一下 ,让它帮你把代码里的隐藏风险都给揪出来。
立即体验长亭MonkeyScan: