基于GPT架构的webshell识别模型
原创 k 2026-07-11 22:57 浙江
模型架构
基于gpt3 only decode架构
完成从头开始训练,模型总参数量: 9.98 百万,在mac m1上使用mps进行训练
模型代码
import torchimport torch.nn as nnfrom tokenizers import Tokenizerimport configimport osclass GPTBlock(nn.Module):def __init__(self, embed_size, num_heads):super().__init__()self.ln1 = nn.LayerNorm(embed_size)self.attention = nn.MultiheadAttention(embed_dim=embed_size, num_heads=num_heads, batch_first=True)self.ln2 = nn.LayerNorm(embed_size)self.ffn = nn.Sequential(nn.Linear(embed_size, embed_size * config.FFN_SIZE), # 升维nn.GELU(), # 非线性激活 (比 ReLU 更平滑)nn.Linear(embed_size * config.FFN_SIZE, embed_size), # 降维)def forward(self, x, mask=None):# 1. 注意力机制与残差连接# PyTorch 的 MultiheadAttention 会返回 (输出, 注意力权重),我们目前只需要输出# is_causal=True 搭配 mask 会自动处理防止“看未来”的逻辑attn_output, _ = self.attention(x,x,x,attn_mask=mask,is_causal=True,need_weights=False,)x = self.ln1(x + attn_output)# 2. FFN 与残差连接ffn_output = self.ffn(x)x = self.ln2(x + ffn_output)return xclass SimpleGPT(nn.Module):def __init__(self, vocab_size, embed_size, max_seq_length, num_heads, num_layers):super().__init__()# 1. 词嵌入与位置嵌入 (PyTorch 的 nn.Embedding 自带可学习权重)self.token_embedding = nn.Embedding(vocab_size, embed_size)self.position_embedding = nn.Embedding(max_seq_length, embed_size)# 2. 堆叠多个 Transformer Block (盖楼)# 用 nn.ModuleList 包装起来,确保 PyTorch 能够追踪里面的参数self.blocks = nn.ModuleList([GPTBlock(embed_size, num_heads) for _ in range(num_layers)])# 3. 语言模型头 (LM Head)self.ln_final = nn.LayerNorm(embed_size)# 投射回词表大小,bias=False 是行业惯例,节约参数self.lm_head = nn.Linear(embed_size, vocab_size, bias=False)def forward(self, input_ids):batch_size, seq_length = input_ids.size()device = input_ids.device# 生成位置索引 [0, 1, ..., seq_length - 1]positions = torch.arange(0, seq_length, dtype=torch.long, device=device).unsqueeze(0)# 特征融合:词意 + 位置x = self.token_embedding(input_ids) + self.position_embedding(positions)# 生成因果掩码 (Causal Mask)mask = nn.Transformer.generate_square_subsequent_mask(seq_length, device=device)# 让数据一层一层穿过所有的 Transformer Blockfor block in self.blocks:x = block(x, mask=mask)# 最后一层归一化x = self.ln_final(x)# 通过 LM Head 转化为词表打分 (Logits)# 形状变为: (Batch_Size, Seq_Len, Vocab_Size)logits = self.lm_head(x)return logits
关键参数如下:
EMBED_SIZE = 256 # 256维特征MAX_LEN = 1024 * 4 # 4k上下文VOCAB_SIZE = 1024 * 8NUM_HEADS = 8 # 8个注意力头 (256/8 = 每个头32维)NUM_LAYERS = 6 # 堆叠6层 Transformer BlockFFN_SIZE = 4
生成词表
trainer = BpeTrainer(vocab_size=config.VOCAB_SIZE,special_tokens=["[UNK]", "[PAD]", "[BOS]", "[EOS]", "[black]", "[white]"],)
预训练
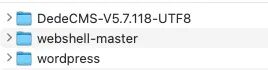
使用数据 WordPress + dede + webshell
PHP 文件数量: 2445原始 token 总量: 16,139,532当前训练实际 token 总量: 4,480,725被 MAX_LEN 截断的文件数量: 593平均原始 token/文件: 6,601.04平均训练 token/文件: 1,832.61
预训练能力测试
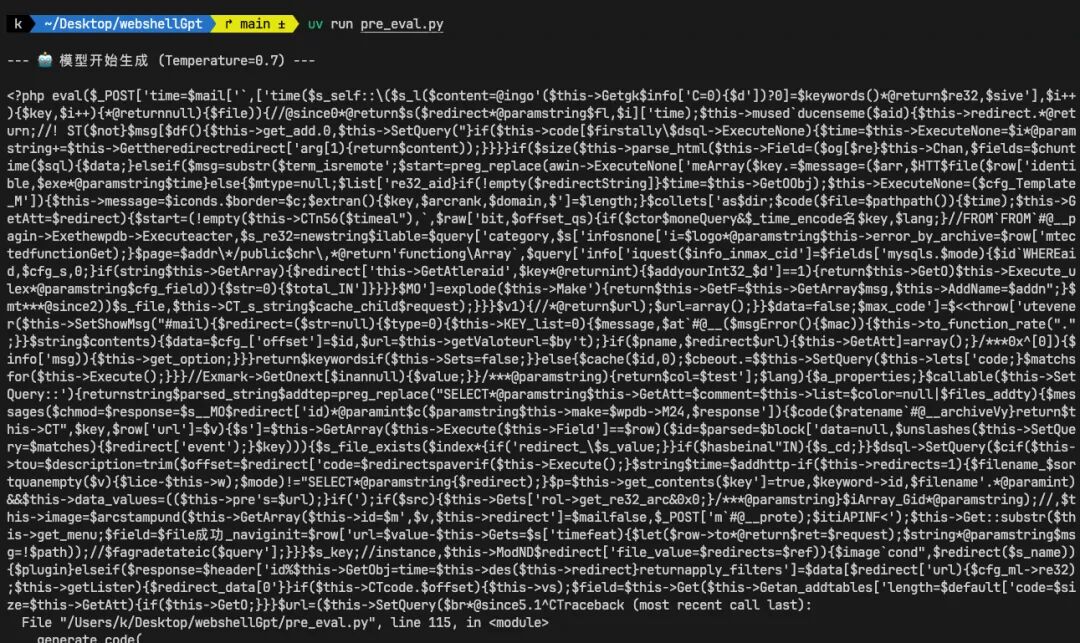
prompt = """<?php eval($_POST['"""
学到了一堆没屌用的
SFT
[bos_id] + code_ids + [eos_id]
在[eos_id]后增加[black]或者[white] 特殊token来标识样本
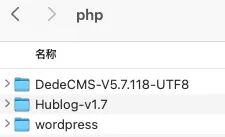
sft白数据:
sft黑数据:
•https://github.com/tennc/webshell•https://github.com/xl7dev/WebShell•https://github.com/JohnTroony/php-webshells
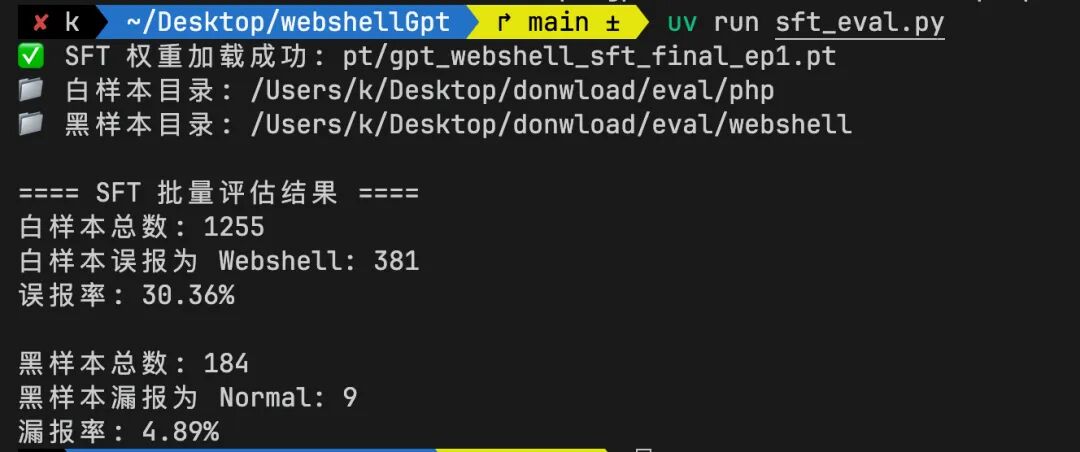
第一轮训练完以后出现了很严重的误报问题,会把<?php echo $admin; ?>也判断为webshell
大概原因是因为在sft数据中,黑样本的数据长度总是比较短,模型学歪了把长度作为特征了。
后续做了注入增强,1.随机抽取白样本中的片段,作为短白样本 2. 将黑样本去掉<?php ?>标签复制到白样本的;后做黑样本,并且将比例对齐
🔍 SFT 数据集加载完毕:原始 Webshell 780 个,注入增强 Webshell 780 个,正常样本 780 个,短正常样本 780 个 (原始正常 2098,原始 Webshell 780)Eval
扩大预训练规模
接下来我想探索一个我一直很好奇的问题,在sft完全不变的情况下,增加预训练的规模对模型的最终效果是否有改善。
根据经验,模型的最近预训练token数量是模型的参数*20
这是1千万的模型,所以最佳的训练token是 2e
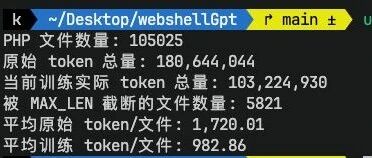
我在compose上收集了大概1.8e的php token,单论实际训了的token大概是1e左右。训练2论,大概在2e左右。
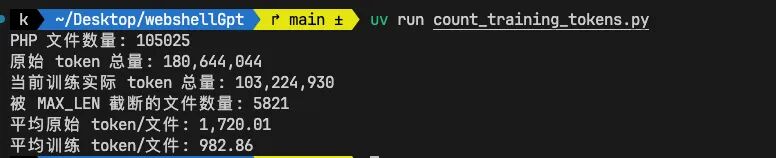
首先在我的mac上训练,大概训练了5-8小时,才训了是1/20。完整训练完大概要几天到一周。
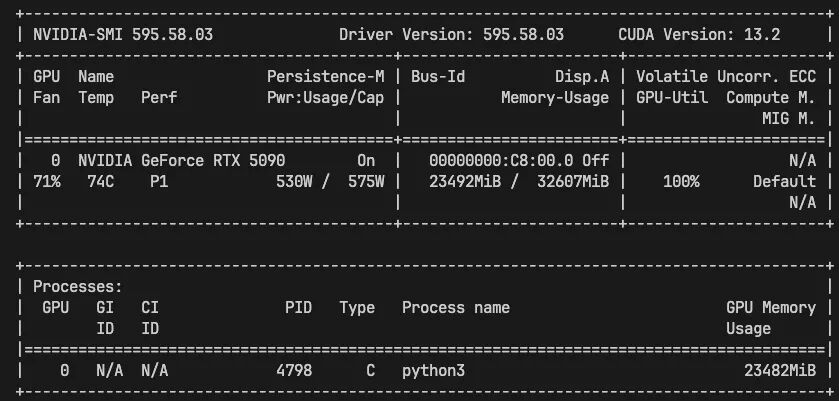
不得已,租了一个5090的服务器,大概训练2个多小时即可

预训练完第一个batch,看看效果
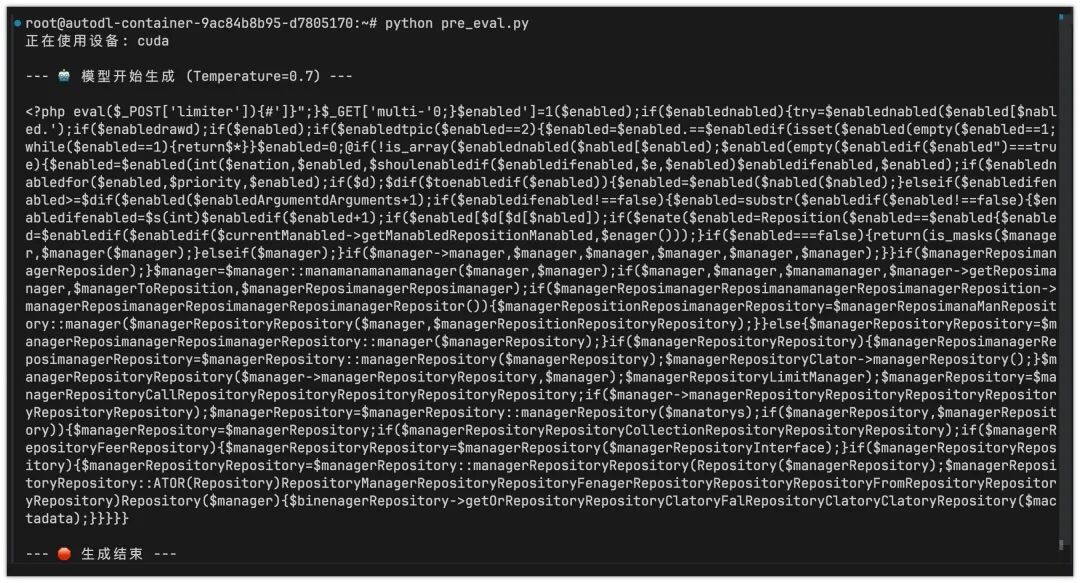
第二个batch的效果
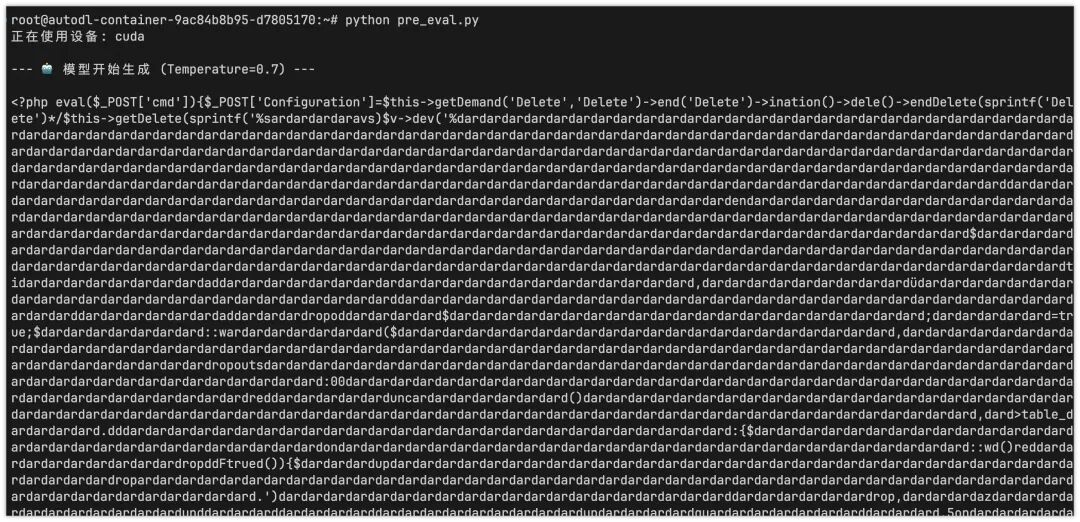
有比较严重的重复的问题。
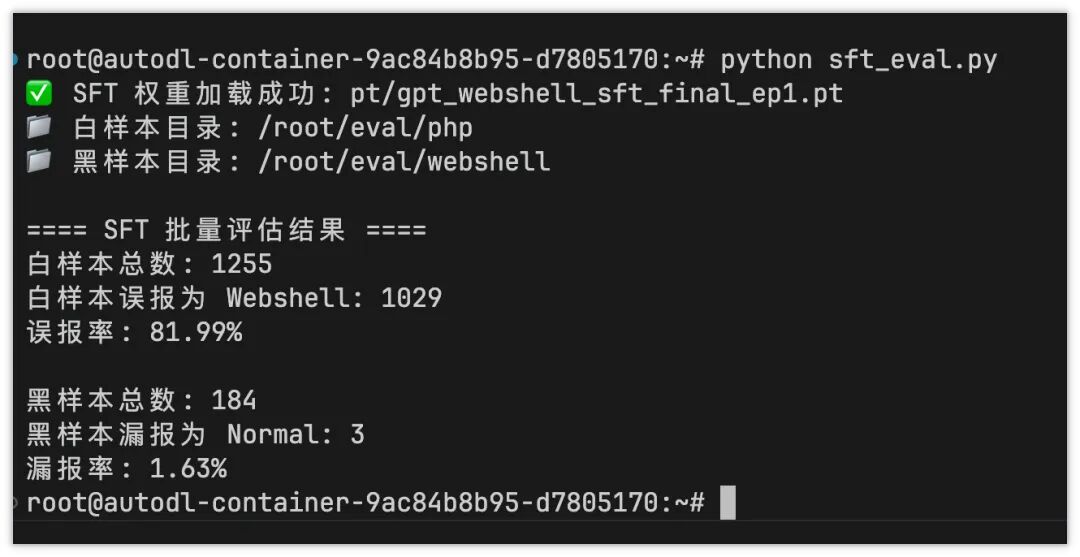
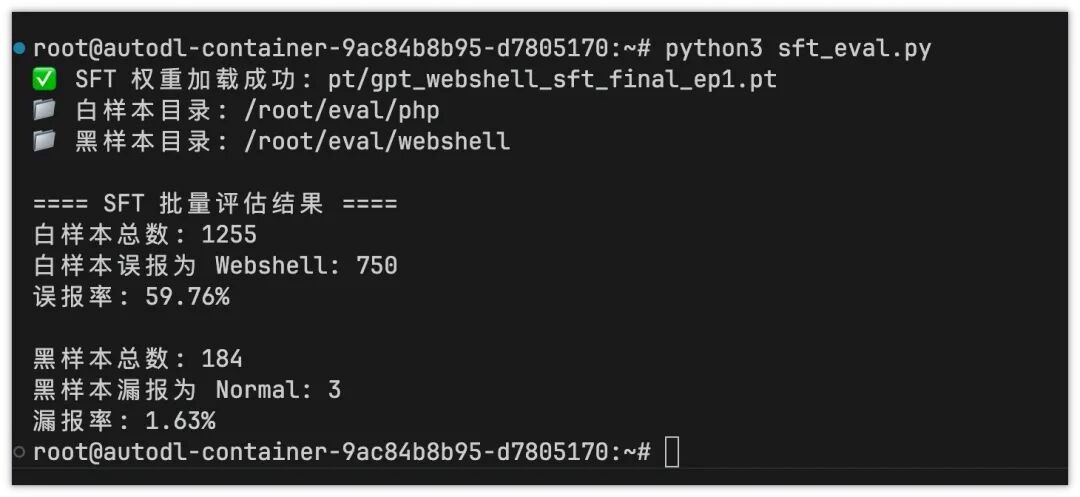
sft以后的误报率也大幅升高。
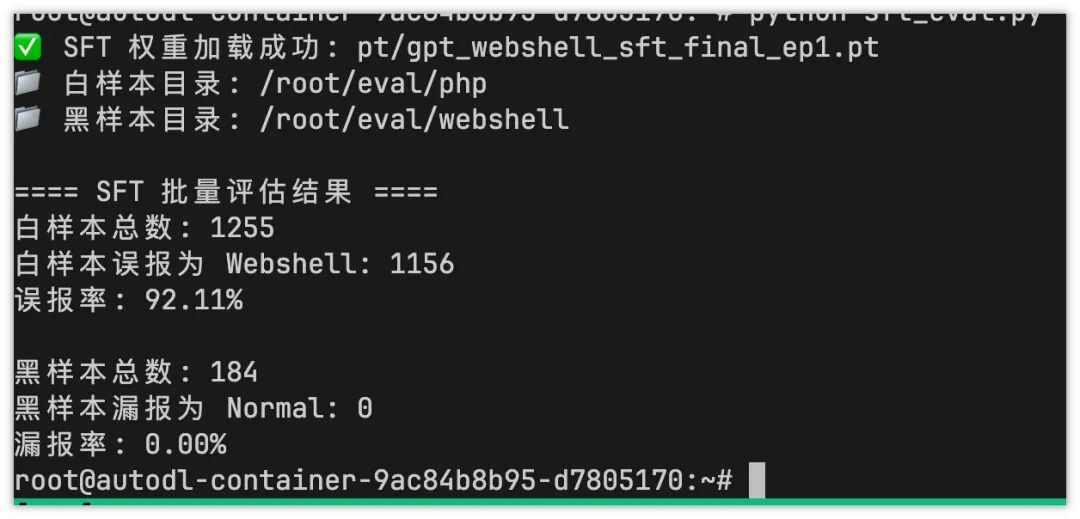
推测可能是因为我在预训练数据中放了webshell的代码,webshell代码中有大量的重复,删除掉webshell代码以后再训练
Batch1
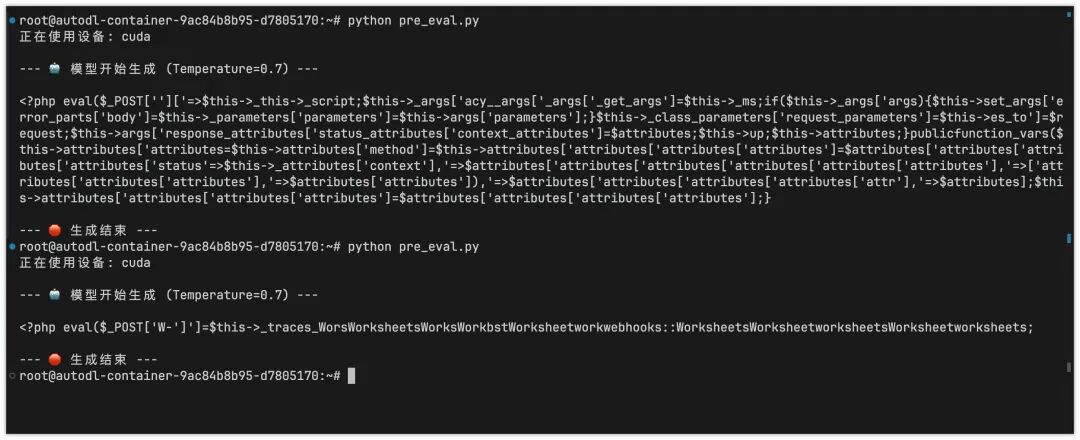
batch2
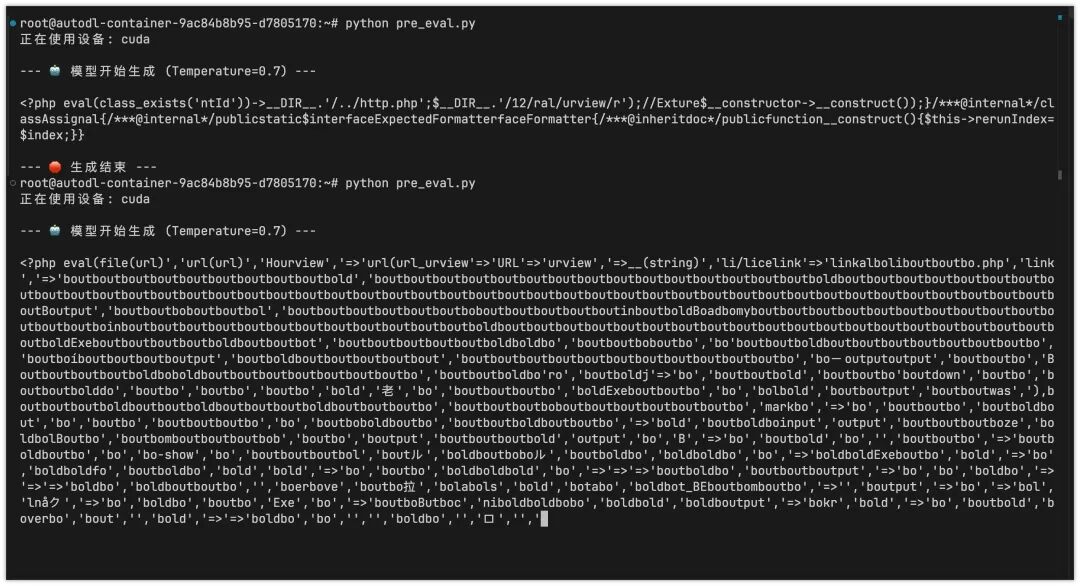
基于batch1 sft结果
基于batch2 sft结果
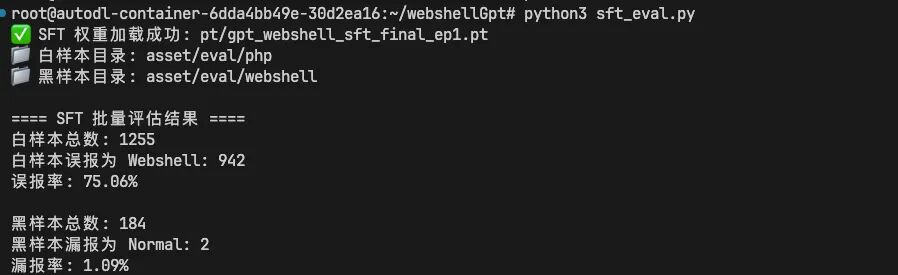
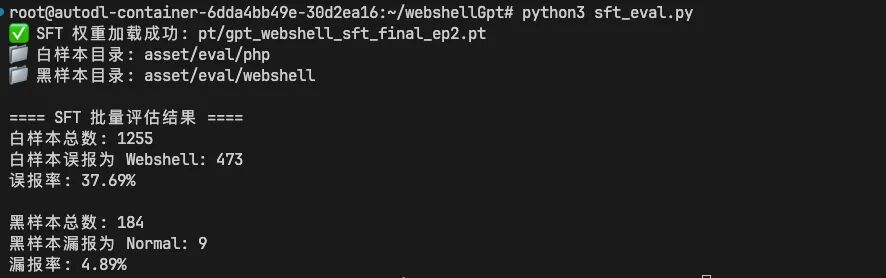
如果完全不做预训练的情况下进行SFT对齐
sft batch1
sft batch2
sft batch3
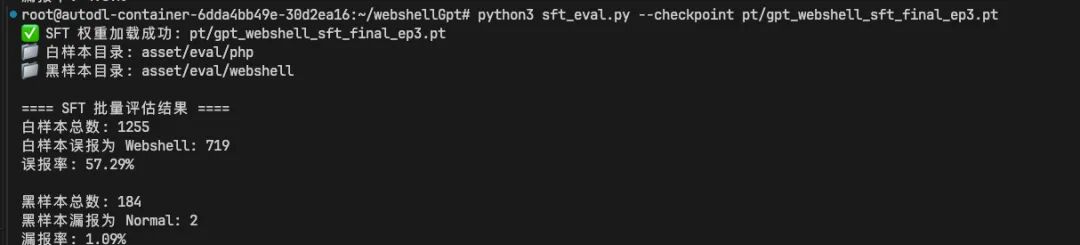
根据样本表现的情况,我个人觉得在模型参数量比较小的时候,模型即使经过预训练也不能完全掌握php的语法信息,导致对后期的webshell识别帮助并不大。后续训练直接做SFT训练,不再做预训练
参数对结果的影响
通过一些工程化手段,收集了GitHub上全部的webshell仓库和扩大了白样本的数量。将误报率和漏报率降下来了。
基准 10M参数
embed_size = 256
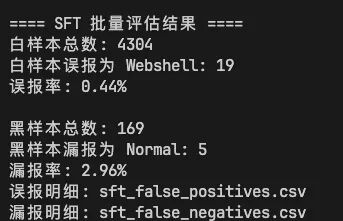
30M参数 embed_size = 512
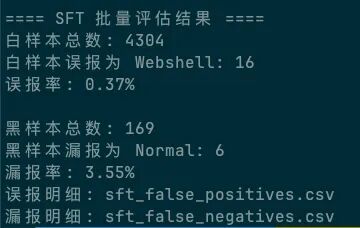
在扩大embed_size的情况下,参数增加了20m,但是对于结果并没有显著改变。
尝试增加 FFN_SIZE = 16
20M 参数
尝试增加 FFN_SIZE = 32
30M 参数
可以见到webshell识别能力并没有明显提高,虽然FFN的siez大了很多。
我觉得可能是因为黑样本的数量还是太少,就算把GitHub上全部的黑样本收集起来去重以后也就不到3000,而且还有小部分不是webshell的噪音混在里面。而高质量黑样本数量成本很高,像阿里的伏魔比赛大概是以500每个以上的价格来收集黑样本。
因为黑样本数据太少,我个人感觉目前的数据应该是还没有触及到模型能力的上限。在数据量较少的情况下很难做到误报率和漏报率的平衡,漏报率的降低必然会显著增加误报率。
最后我把我的模型部署到我的vps上了大家可以体验一下这个
webshellgpt: https://webshell.hx-std.com/