关于目录枚举的最新玩法!
messfree 2026-07-22 10:31 山西
以下文章来源于:MessFreeSecurity
MessFreeSecurity提供社区优质咨询服务
护网里最让人麻木的场景之一:目录扫描器跑了一整夜。
/admin、/manage、/system、/console、/api/v1/users……几十万条字典轮番上阵,回来一片 404。换份更大的字典再跑一遍;大小写、下划线、连字符、复数排列组合,再跑一遍。
最后结论:这个站没有后台。
但如果开发者真正写下的接口叫——
/api/Usr_crt
先插一句:原报告里存在拼写不一致,第 32、35、38 页截图用 User_*,第 34、37 页文字和作者研究网站用 Usr_*。本文讲语法时沿用作��网站的 Usr,解读截图时保留画面里的 User。
通用字典认识 user/create,但未必认识这套"实体缩写 + 下划线 + 动作三字母缩写"的内部方言。
更要命的是,同一套系统里删除接口可能不叫 Usr_del,也不叫 Usr_dlt,而叫:
/api/Usr_rmv
这就是 DEF CON 33 Recon Village 上那份 105 页报告《enumeraite: AI-Assisted Web Attack Surface Enumeration》想解决的问题。
它没让 AI 直接扫描,也没让模型自动找漏洞。研究者做的事更像是:把目标已经暴露出来的几个名字丢给模型,让它根据这些种子临时归纳命名规律,再给目标编一份专属字典。
不是每遇到一个目标就重新训练模型。前面 Apple LSTM、nanoGPT 属于目标专用训练实验;后面 0x0、0x1 两种模式则是在全局训练分布上,把目标种子放进 prompt 做条件化生成。
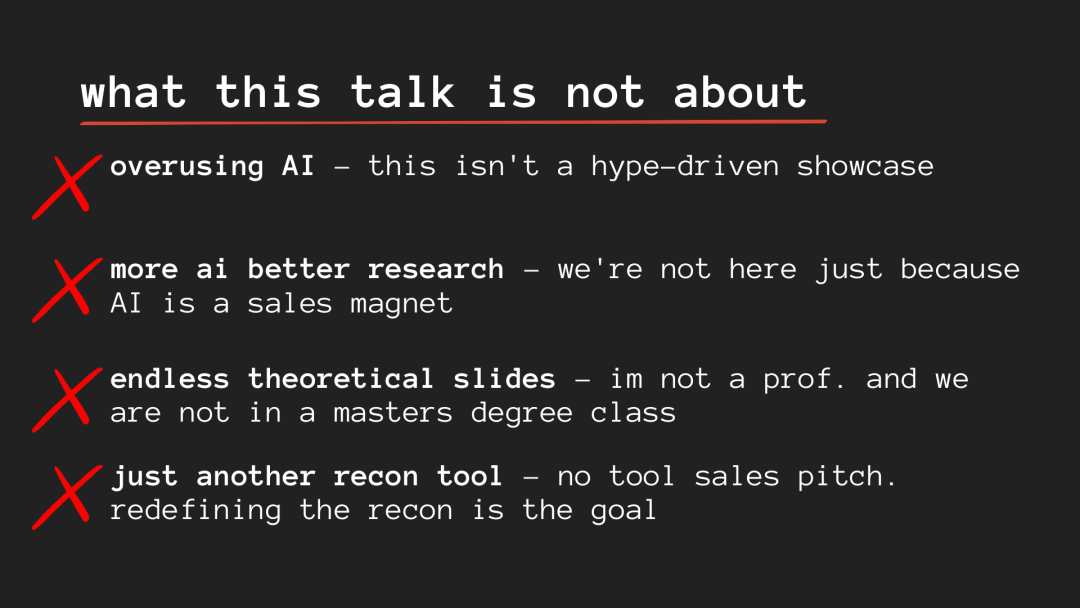
这思路听起来容易像 AI 营销话术。但这份材料最值得看的地方,恰恰是作者一上来就给自己踩了刹车:这不是"模型越大越牛",不是 AI 自动渗透演示,也不只是再卖一款 Recon 工具。
这篇文章就按 105 页幻灯片的顺序拆。先说字典为什么失效,再看那个作者声称命中管理功能的接口案例,然后把 LSTM、nanoGPT、GPT-2、Qwen3-4B 四段实验讲明白,最后落到护网里真正能用的工作流和蓝队检测。
整份报告翻完,我最大的感受是:
AI 在这儿最合适的角色,不是扫描器,也不是漏洞验证器,而是"目标专属字典编译器"。
105 页到底讲了什么
这份 PPT 动画页很多,真正的主线可以合成六段:
| 页码 | 内容 | 要回答的问题 |
|---|---|---|
| 1—4 | 议题边界与目录 | AI 在这项研究里负责什么、不负责什么 |
| 5—28 | Web 攻击面与传统枚举困境 | 为什么更大的字典仍然看不到目标专属资产 |
| 29—38 | /api/User_crt / Usr_crt 案例 | 一个已知接口如何暴露整套命名语法 |
| 39—72 | 从 LSTM 到 Qwen3-4B | 模型到底学了什么,又在哪些地方失败 |
| 73—99 | 四种枚举模式 | 路径、子域、结构槽位和语义接口怎么生成候选 |
| 100—105 | 后续计划与发布 | 研究做到哪了,离生产可用还有多远 |
这里有个容易搞混的概念:check 和 discover。
打个比方:你手里已经有 5,000 个子域名,然后去探测哪些能解析、哪些开了 HTTP——这是 check。
还有 2,000 个资产从来没进过清单,证书透明度、搜索引擎和通用字典都没收录——这才是 discover。
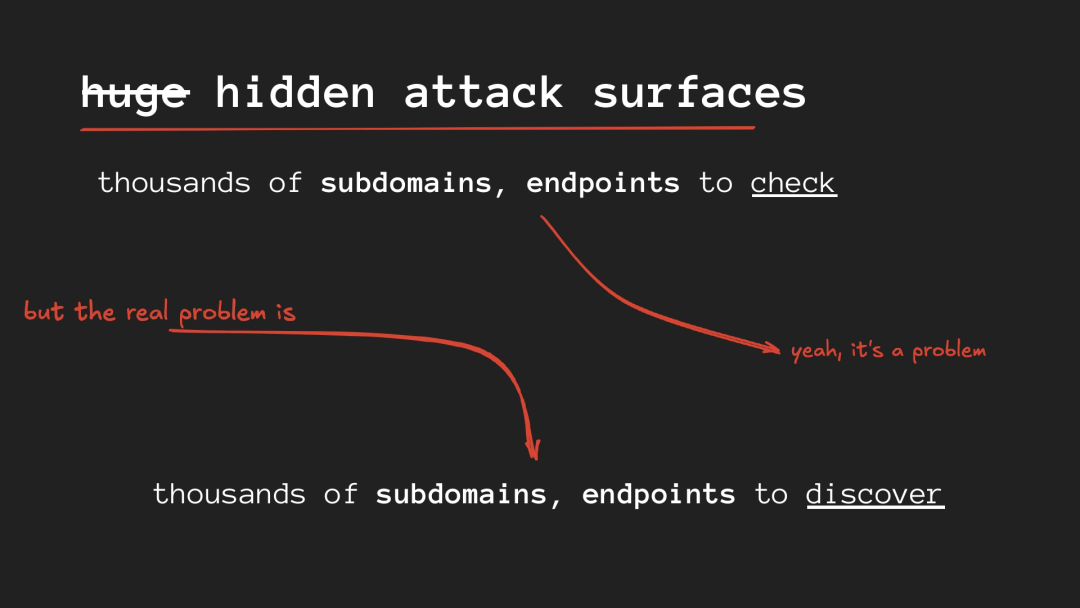
传统工具干前一件事很强;未知资产发现则受限于被动数据源、预设词表和变异规则的覆盖上限。
字典不是太小,而是听不懂目标的方言
通用字典的基本假设是:大家会反复用一批相似的词。
子域名常见 dev、test、stage、api、mail;路径常见 admin、login、user、upload、swagger。词表够大、排列组合够全,总能撞中一部分。
问题是,企业内部命名从来不只由英语单词组成。它还混着:团队缩写、历史项目代号、机房与城市代码、云区域和集群编号、开发者个人习惯、旧框架留下的大小写下划线和后缀、只有内部才知道的业务简称。
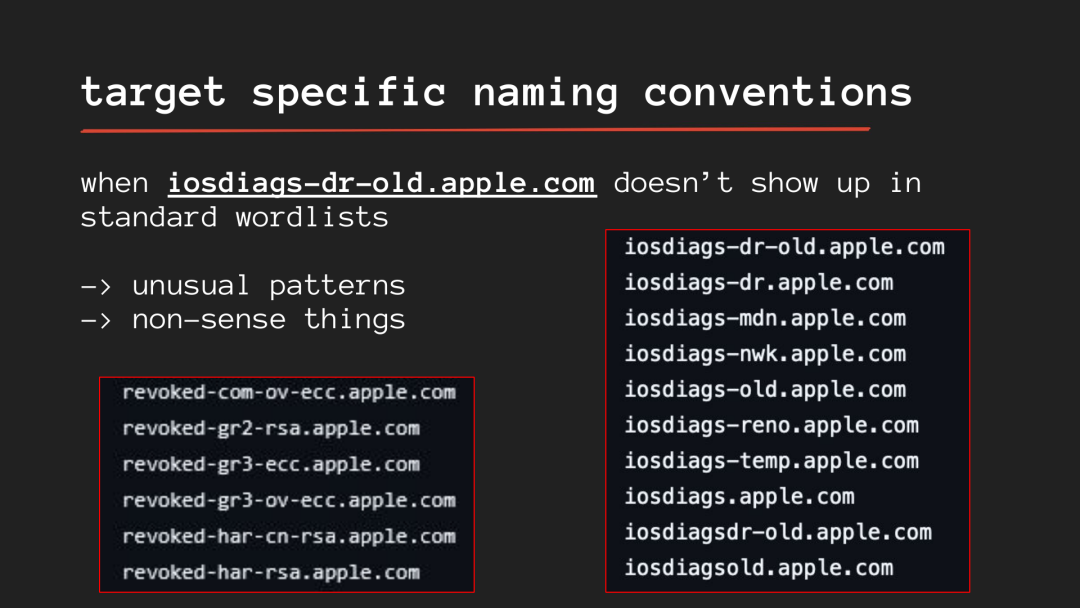
报告第 18 页用 Apple 风格的名字举例:iosdiags-dr-old.apple.com。iosdiags 还能看懂,后面的 dr-old、mdn、nwk——如果不结合目标自己的邻居样本,通用字典没理由把这些片段拼到一起。
模型第一次也会猜错
报告先把 iosdiags-mdn.apple.com 单独丢给模型。
没有上下文时,模型把 mdn 猜成 Mobile Device Network 或 Mobile Diagnostics Network,把 nwk 猜成 Network。听起来都挺专业,也可能都是一本正经地胡说。
然后作者补入了相邻样本:
iosdiags-reno.apple.comiosdiags-mdn.apple.comiosdiags-nwk.apple.com
模型的解释方向就变了:reno 可能是 Reno,mdn 可能指 Maiden,nwk 可能指 Newark。三个后缀被重新理解成地点或机房代码。
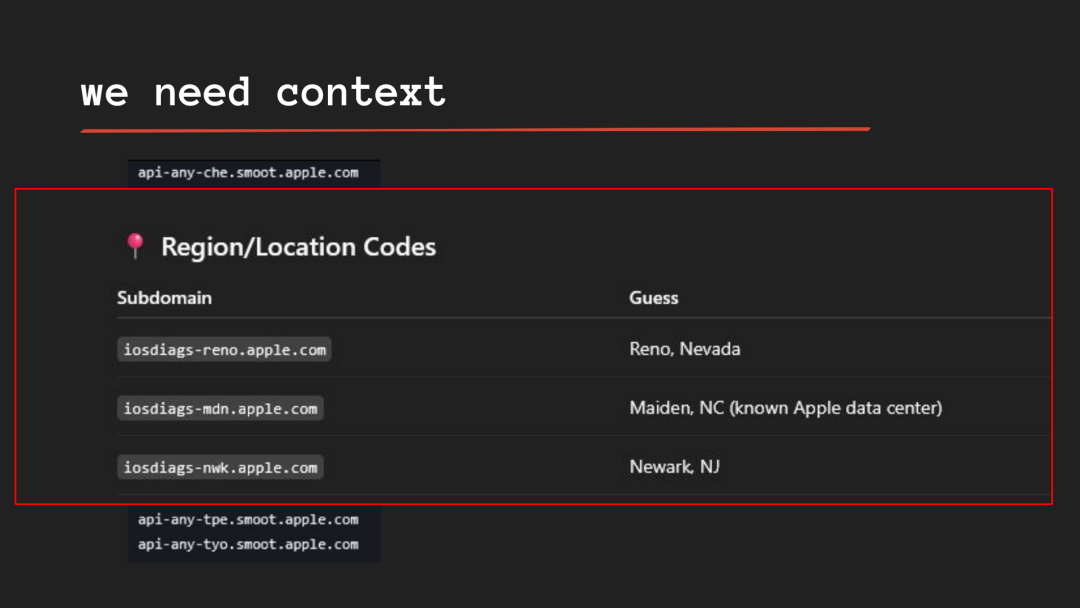
这个例子最关键的不是"AI 认出了 Maiden"——幻灯片也没证明这些解释一定对。真正重要的是:一个孤立的字符串只能让模型编故事;一组来自同一目标的邻居样本,才可能让模型归纳出可验证的结构假设。
如果假设是"后缀代表地点",下一步就可以生成 sjc、iad、dfw、ams、lhr、tyo 等候选,再丢给 DNS 和 HTTP 工具验证。候选不是资产,通过验证的才有资格进资产表。
路径比子域名还头疼
子域名主要面对标签、分隔符和层级。路径还叠加了技术栈、HTTP 方法、参数、扩展名和路由规则。
同一个"添加用户"功能,可能长这样:
POST /app/user_add.htm?company_id=3
POST /api/Usr_crt
PUT  /management/accounts/new
POST /console/member/save.do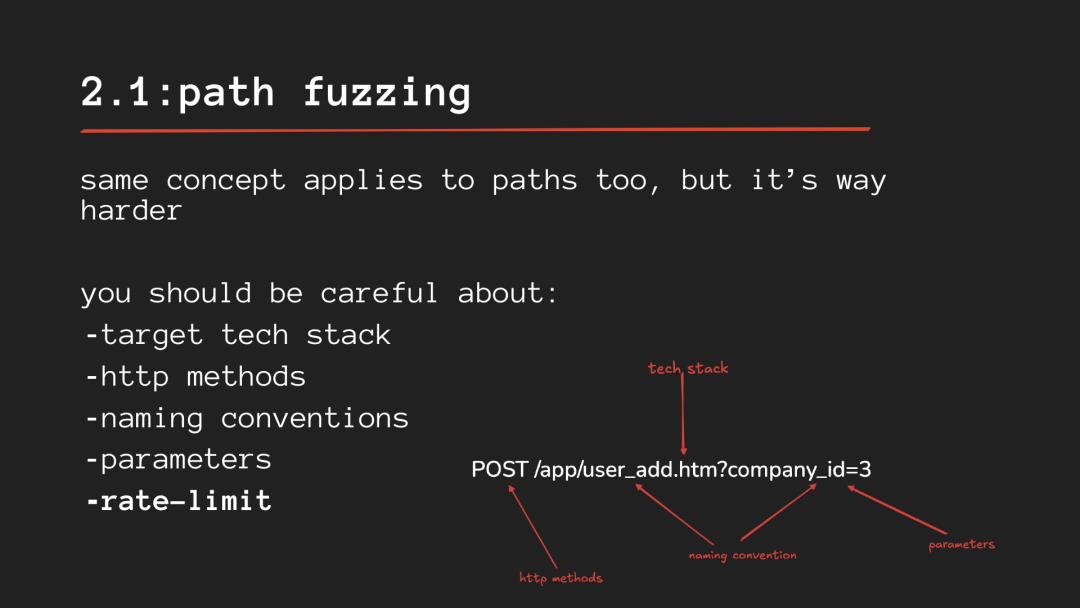
这也是为什么把 100 万行字典喂给 ffuf 不等于理解目标。字典解决的是"有哪些常见词",目标化枚举解决的是"这家开发团队会怎样把一个业务动作写进 URL"。
一个"GET 不受支持",比十万个普通 404 更值钱
报告第 31 页开始讲作者称为真实经历的案例。
他在一次 Web 渗透测试里注册账号,观察到一个创建用户接口。PPT 截图显示 /api/User_crt,直接用 GET 访问时,服务端返回:请求的资源不支持 GET 方法。
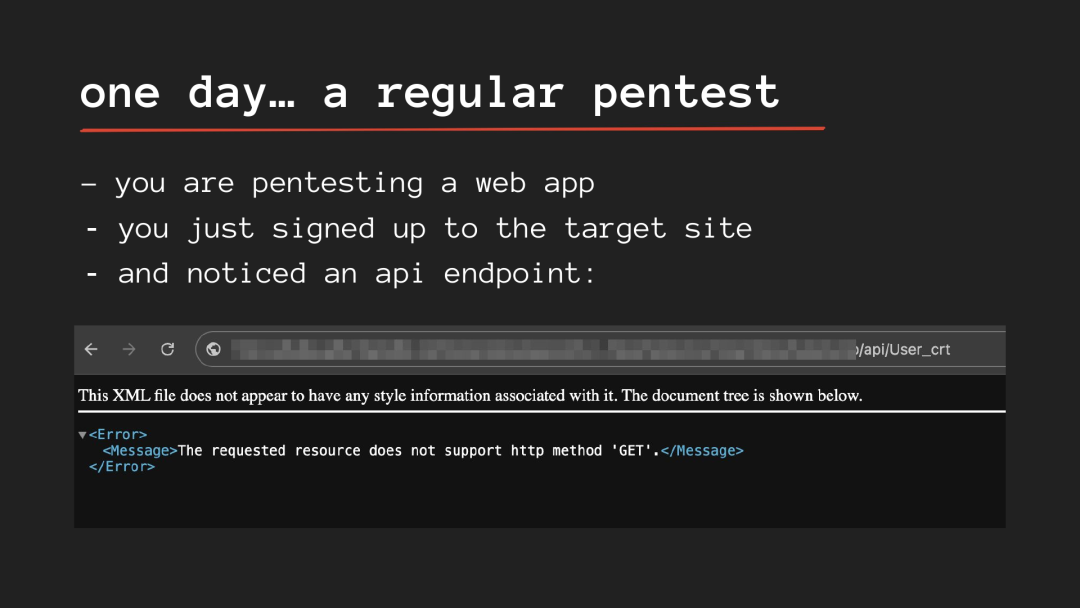
这个差异很小,但很值钱。
报告里手工猜错的那些候选返回的是"找不到 URI 对应的资源"或"Controller 不存在";User_crt 返回的是"资源存在,但 GET 不支持"。截图能直接证明的是响应正文不同;实际测试时还可以继续比状态码、长度和 Allow Header。这类差异会形成路由 Oracle,泄露后端路由到底存不存在。
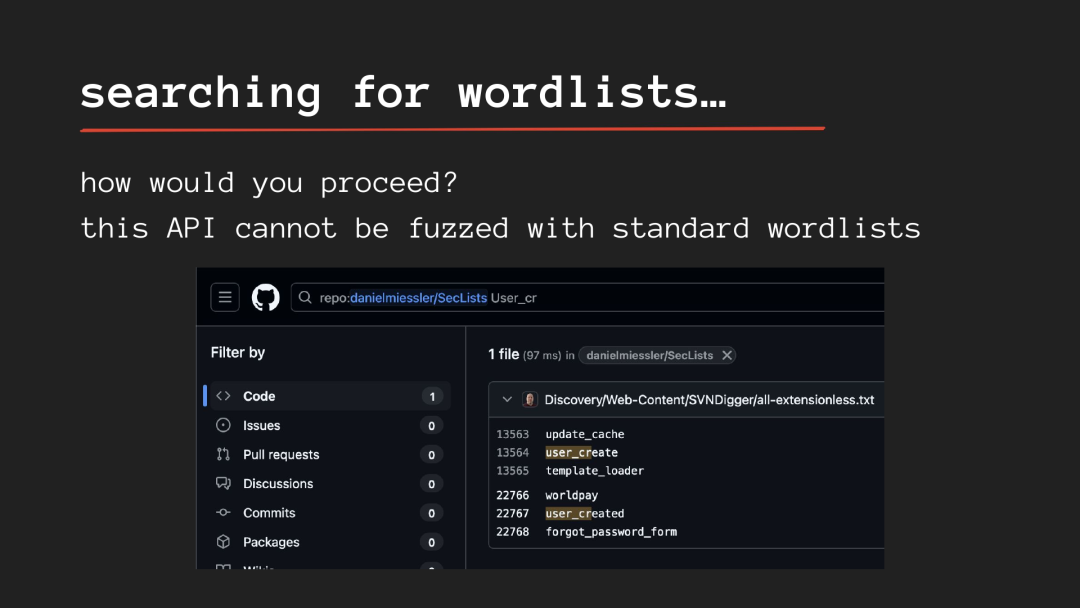
作者去 SecLists 里搜相同模式,只找到 user_create、user_created 一类常见写法,没有目标用的精确缩写组合。
然后作者手工猜了一批:
Usr_dlt
Usr_lst
Usr_prm
Adm_crt
Adm_lst
全是一片"Controller 不存在"。
为什么?人脑通常会先写最自然的 delete、del、dlt;但按作者后续陈述,目标恰好用了 remove 的另一种三字母缩写 rmv。
作者把一个已知接口和自然语言目标"删除用户"交给 ChatGPT,让模型保持原来的大小写、下划线和缩写风格,生成新候选:
/api/Usr_del
/api/Usr_dlt
/api/Usr_rmv
/api/Usr_elm
/api/Usr_destroy
/api/Usr_remove
/api/Usr_rm
/api/Usr_excl
/api/Usr_abort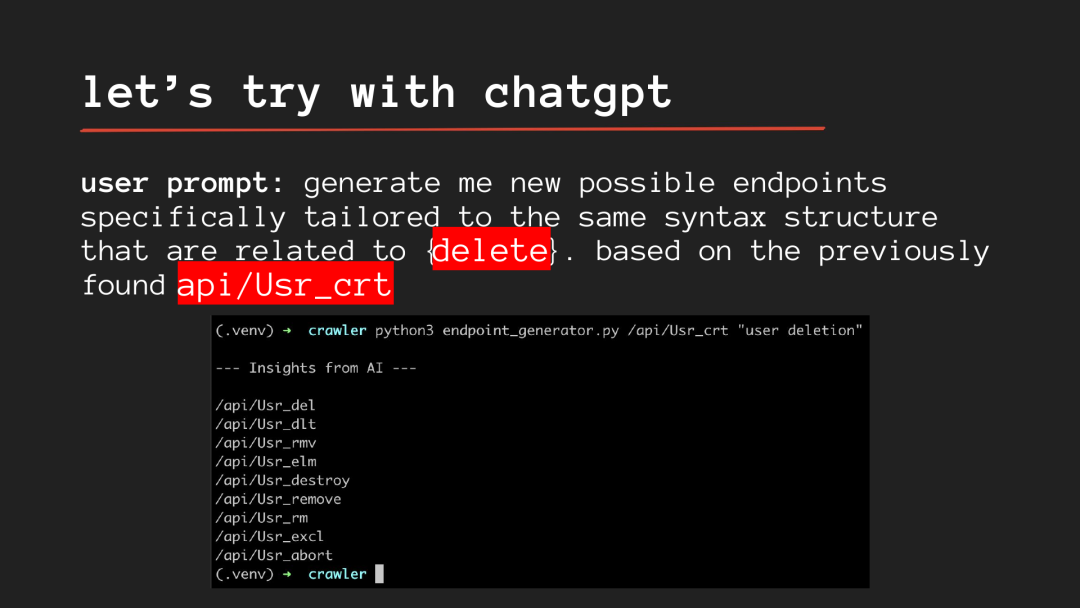
其中 rmv 对应的路由出现了与手工失败候选不同的响应。作者称后续用正确方法验证后发现了带访问控制缺陷的管理功能,拿了 4,000 美元以上赏金。
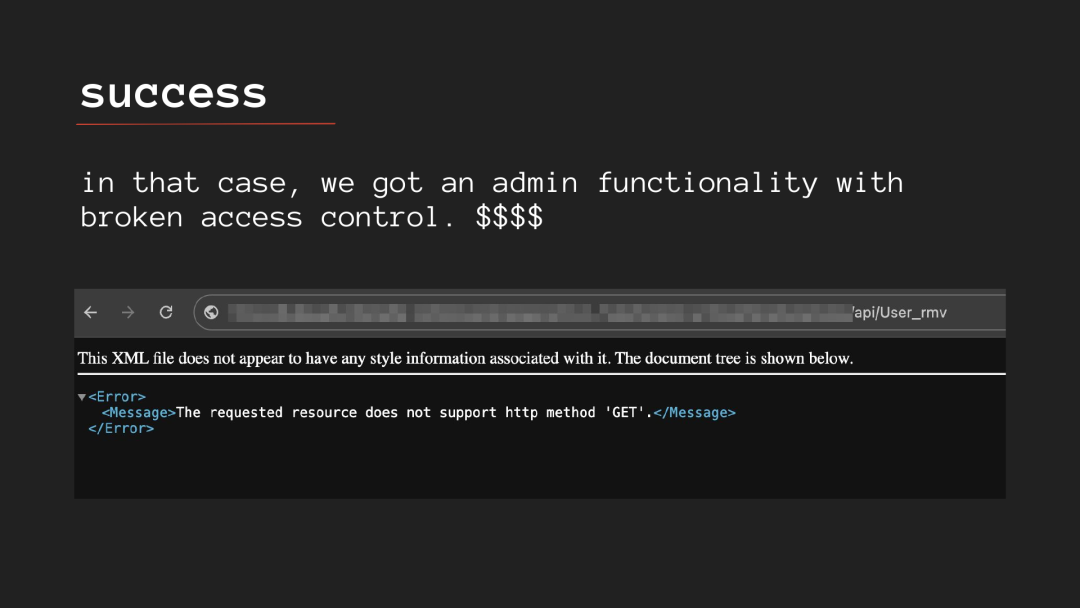
这里得把证据边界说清楚。第一,PPT 截图里的 User 和后续文字、作者网站里的 Usr 不完全一致,报告自身存在拼写差异。第二,"GET 不受支持"最多说明路由可能存在,不等于已证明越权——要确认 Broken Function Level Authorization,至少还需要低权凭据、正确 HTTP 方法、管理员对照请求和状态变化验证。第三,目标已匿名,赏金和漏洞细节目前主要来自演讲者本人,不能写成独立复核过的公开漏洞。
但即便把这些宣传成分全拿掉,这个案例依然能支撑一个很实用的判断:
模型没替作者发现漏洞。它只是把人脑有限的几个猜法,扩写成一组更贴近目标命名风格的候选。真正让候选浮出水面的,是响应差异。
AI 到底多做了哪一层
静态字典保存的是词。
模型试图学习的是词与词之间的关系:什么实体常和什么动作一起出现,版本号通常放哪,目标喜欢大小写还是全小写,环境和地域怎么排列,数字补不补零,动作更常用完整单词还是三字母缩写。
到第 94—95 页的 Agent 演示,作者把示例扩成 /api/v2/Usr_crt。拆开以后暴露了一套小型语法:
base_path    = /api/v2/
entity       = Usr
separator    = _
action       = crt
case_style   = 首字母大写
action_style = 三字母缩写
如果模型结合目标的其他路径推断出 crt → create,它就可以围绕同一语法尝试 lst、upd、del、dlt、rmv,而不是把 delete-user、users/remove、removeUser 等所有互联网常见写法平均扫一遍。
报告用 Transformer 的 self-attention 解释这种能力:模型不只看相邻 token,还能同时关注版本槽位、资源槽位、动作槽位和更远处的结构关系。
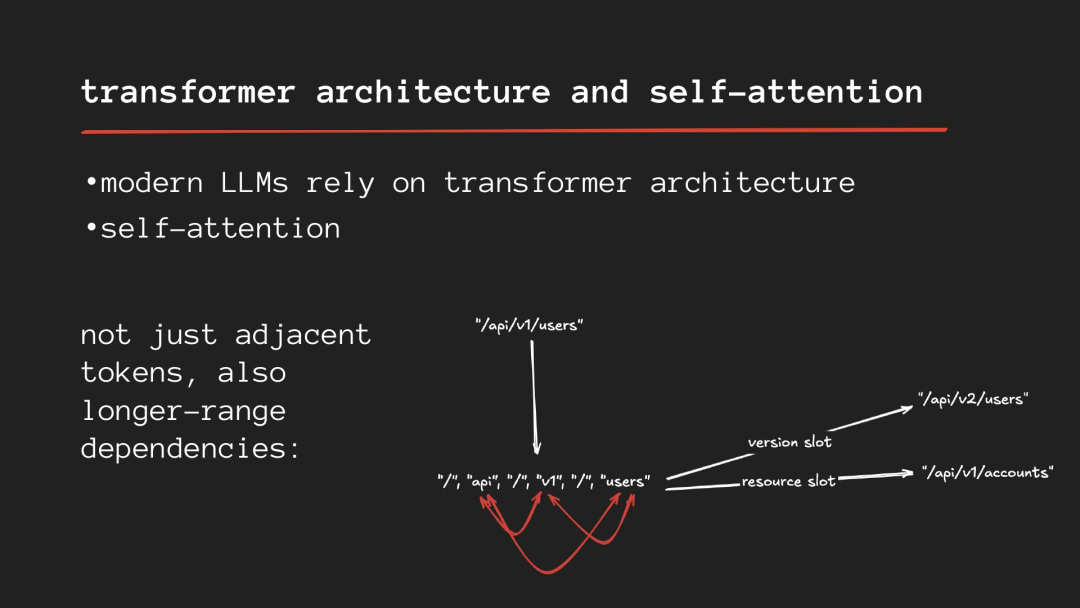
说直白点:AI 不是知道后台在哪。它只是比静态字典更会猜——"如果这个后台存在,开发者可能会怎么给它取名"。
这两句话差别很大。
从 LSTM 到 Qwen3-4B:为什么换了四代模型
报告第 49—72 页不是简单说"上大模型就行",而是一段很典型的试错过程。
第一代:LSTM——能续写编号,听不懂语义
最初方案是 LSTM,逐个处理标签,根据前序序列预测下一个标签。
训练样本里有 student1.apple.com,它可能学会猜 student2.apple.com。但让它从 student 跳到语义相关、字符串不相似的 edu,就难得多。
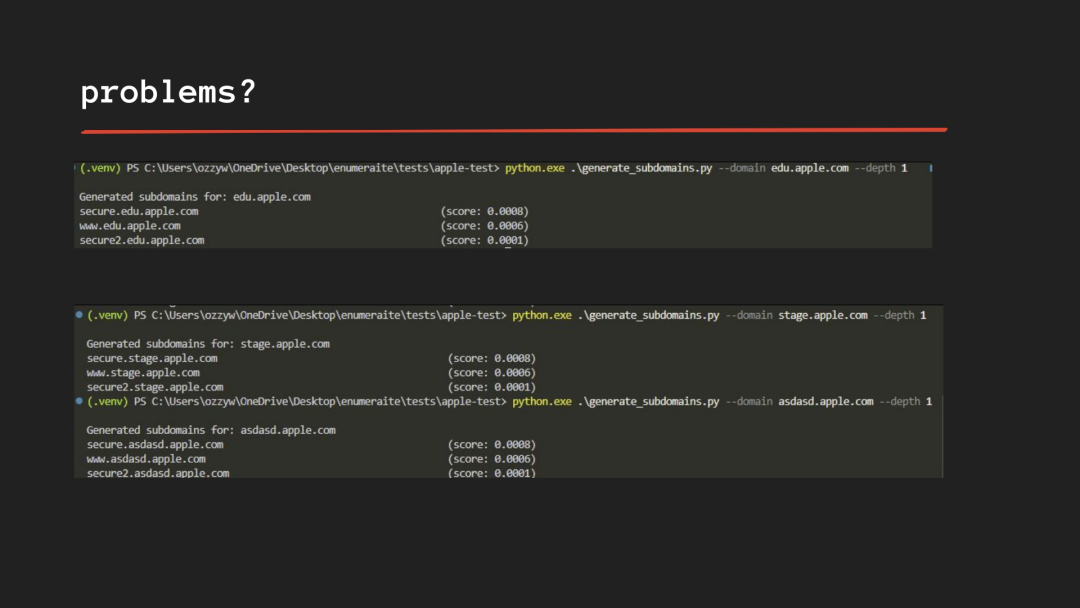
真正暴露问题的是第 57 页。作者把最低词频设为 5,导致 stage 和随机字符串 asdasd 都掉进 unknown token。对模型来说这两个输入变成了同一个东西,于是输出几乎相同的 secure、www、secure2。
作者随后换了更适合连字符结构的 tokenizer,stage 不再和随机字符串一起坍缩成未知词,输出开始出现环境和地点相关候选。
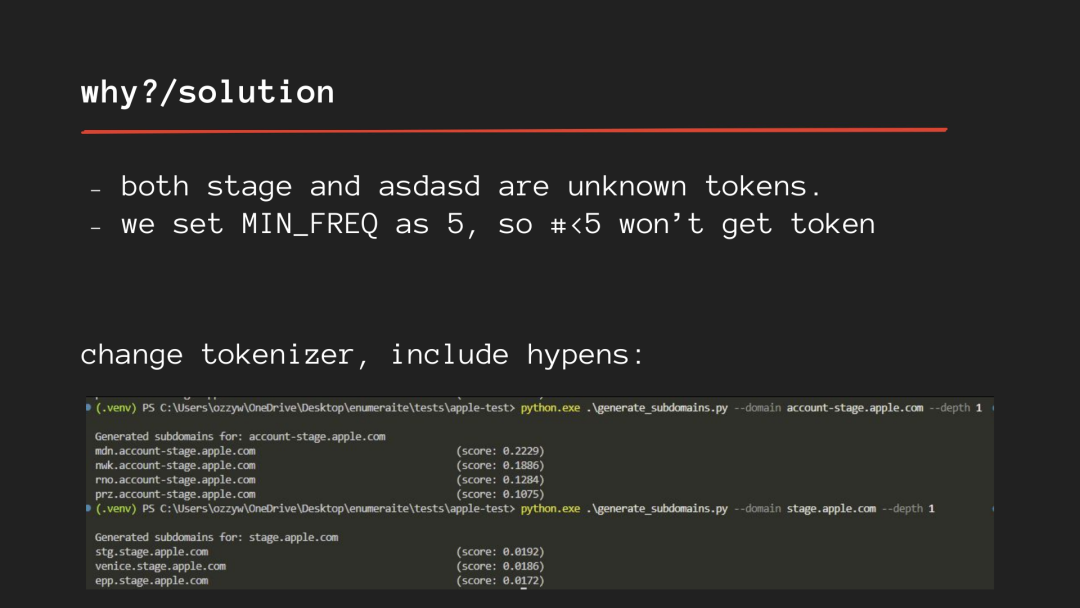
有个细节值得留着:PPT 正文写最终 validation loss 约 1.59,同页训练日志显示的却接近 1.1596。不管哪个数字对,它只是 token 预测损失,不等于 DNS 命中率,更不等于发现漏洞的概率。
第二代:10.6M 参数 nanoGPT——小而快,但容易背题和残缺
作者用 nanoGPT 从头训了一个约 1,060 万参数的企业专用小模型。比 LSTM 更适合同时学服务、环境、地域和编号的组合,可以完全离线跑。但第 63 页的输出里仍然能看到重复、截断和残缺名称,训练损失与验证损失之间也有明显差距。
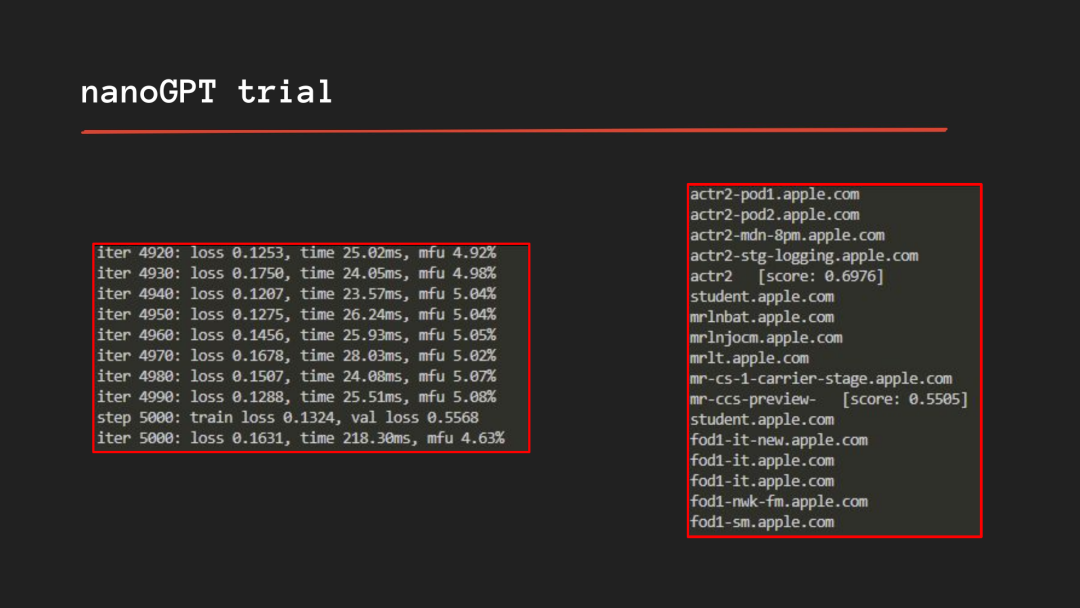
这类模型最适合固定企业、敏感数据不出网、命名规则稳定的场景。它的优势是成本和隐私,不是天然比通用大模型聪明。
第三代:GPT-2 微调——语义更强,但仍可能是背题
PPT 列了 GPT-2 small 约 1.17 亿参数、large 约 7.62 亿参数两档,展示了一次微调实验,但没注明截图实际用的哪一档。预训练让模型先学到通用字符串和语言结构,再用目标数据微调。
输出看起来更像真实企业子域,但报告没证明这些名字是训练集外的新资产,也没展示 DNS 解析率。模型可能是在泛化,也可能在记忆、重组公开数据。"生成得像"只能说明候选质量可能提高,不能证明发现率提高。
第四代:Qwen3-4B——在成本、上下文和本地部署之间折中
最终研究选了 Qwen3-4B。理由是现代 Transformer 架构、32K 上下文,以及性能、成本和部署之间相对均衡。
两个方向分别准备数据:子域模型覆盖 5,000 多个根域、2,200 万以上子域名;路径模型覆盖 63.2 万以上域名/子域名、2,800 万以上路径。
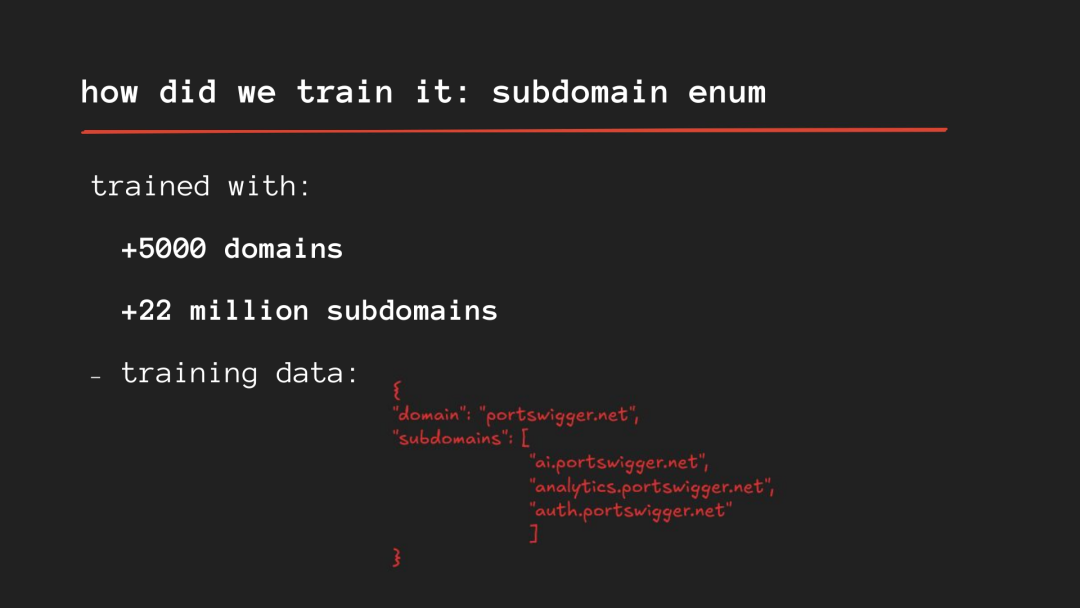
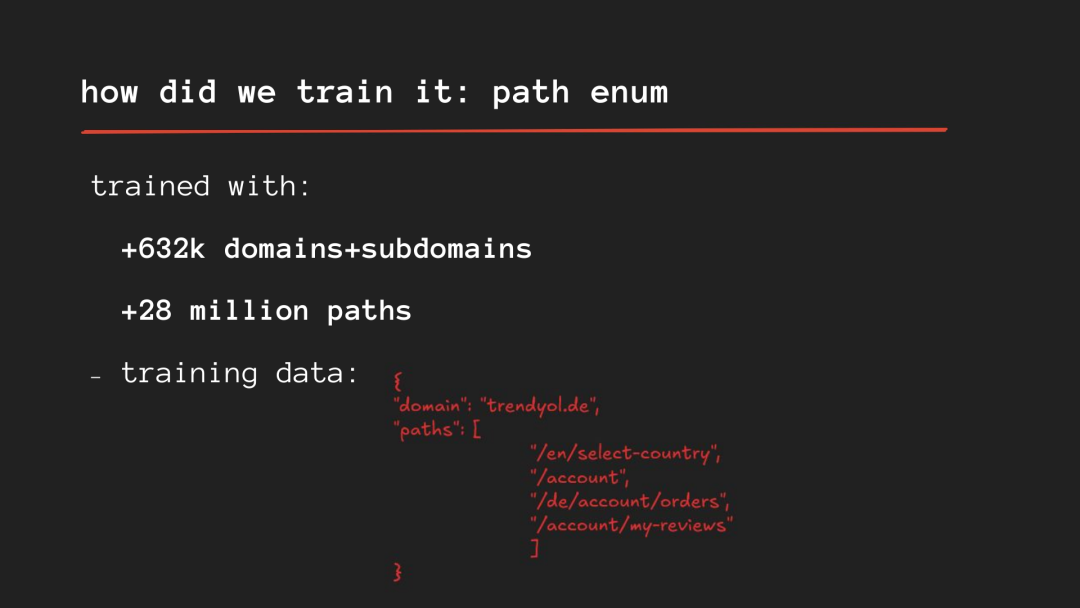
数字看着很大,但 PPT 没交代几个决定可信度的问题:数据从哪来、是否授权、是否去重、怎么排除 wildcard 和历史失效资产、训练集与测试集是否按根域隔离、输出是否只是训练数据复现。最关键的是,报告没给出与 SecLists、ffuf、Amass、Subfinder 等工具在相同请求预算下的正式对照,没有 precision、recall、真实命中率、误报率和成本曲线。
所以这项研究证明了"方法值得继续做",还没证明"这套模型已全面超过传统字典"。
四种模式:从"扩写词表"走向"拆解目标语法"
第 73—99 页是整份材料最适合护网实战理解的部分。
0x0:从已知路径生成同站候选
输入是一组已在目标上观察到的路径,比如 /login、/cart、/checkout、/products/shoes。模型根据训练数据里的共现和结构,生成 /account、/orders、/wishlist 等更可能与它们同时存在的路径。
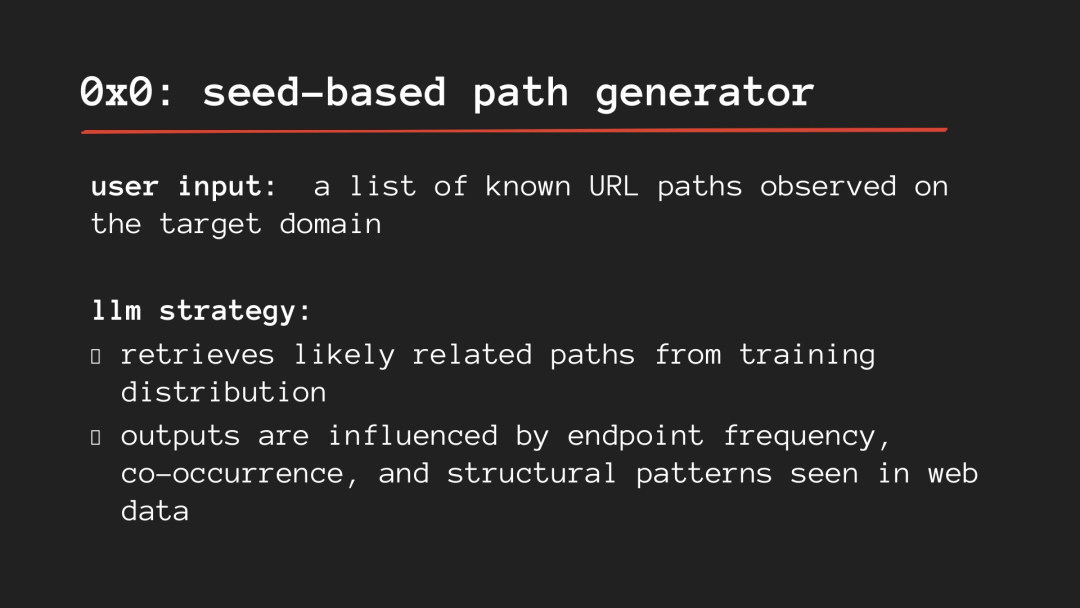
第 78 页的终端实际是内部生成 61 条原始序列,命令参数 -c 10,最终只展示 10 条。多条输出把 defcon33.com 塞进路径,或者重复域名片段——连"格式合理的路径候选"都未必算得上。这比"没命中证据"更能说明:生成数量不等于候选质量。
这一模式适合已经从 JS、Sitemap、OpenAPI 残片或代理历史中拿到一小批真实路径时用。弱点也明显:输入只有通用电商路径的话,模型大概率只会吐出另一批通用电商词。没有目标专属样本,就谈不上目标专属推断。
0x1:从已知子域生成相邻命名
输入是目标的一组已知子域名。原始 Qwen 可能给 admin、blog、mail、support;微调模型会更偏 dev-api、stage、staging.api 等研发环境组合。
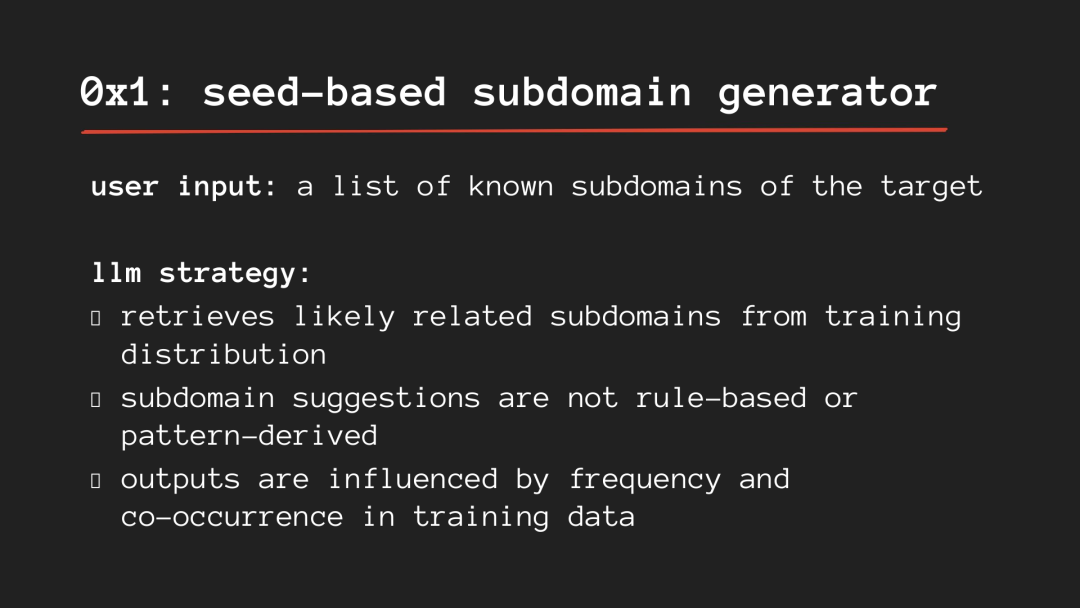
这更像是"依据目标种子做条件化生成和候选排序",不是为每个目标重新训练模型,更不是凭空发现子域。护网时间有限、目标有 DNS 限速或大规模爆破容易出噪声时,先取 Top-K 高相关候选做验证,可能比把整个互联网词表打一遍划算。
0x2:从一个子域名拆出产品、区域和集群槽位
这一段是整份报告里最骚的结构化思路。
输入只有一个真实风格的子域名:
activateiphone-use1-cx02.apple.com
Agent 1 不急着生成,先拆结构:
activate [PRODUCT] - use [REGION_ID] - cx [CLUSTER_ID]Agent 2 再为每个槽位准备候选:产品可以是 mac、ipad、iphone、watch;区域和集群编号按同样格式变化;最后组合成结构一致的新名字。
这种方法特别适合多地域 SaaS、云集群、灾备、测试环境和带编号的历史资产——它不只是在替换单词,而是试图还原基础设施命名模板。
但 Apple 案例仍然只是结构演示。报告第 91 页生成了 200 个组合,没证明其中任何一个在 DNS 中真实存在。流程的最后一步必须回到传统工具:DNS 解析、HTTP 探测和启发式评分。
0x3:从一个 API 反推整套接口族
第四种模式回到同一命名思路,演示中加入版本前缀 /api/v2/Usr_crt。
系统先识别:/api/v2/ 是版本化前缀、Usr 可能是 User、crt 可能是 create、命名样式是 Entity_action、用户想找的是"删除用户"。
Agent 1 把这些推断整理成结构化数据,Agent 2 再生成 Usr_del、Usr_dlt、Adm_rmv、Mem_term 等不同实体和动作组合。
第 98 页设想的 Validator Agent,会尝试不同 HTTP 方法、采集响应与元数据、返回 confidence。
这里有个实战边界必须加粗:POST、PUT、DELETE 可能真实修改数据。 护网或渗透测试中,别因为 Agent 给了一个候选就自动轮询所有状态变更方法。优先用经授权的只读探测;即使是 GET、HEAD、OPTIONS 也不能假定绝对无副作用。涉及写入、删除、批量操作的,只能在明确授权、可回滚和隔离数据条件下验证。
第 99 页终端演示生成了 288 个 API 名称,没展示任何一个真实有效。截图里还出现 v156 到 v200 这类低先验版本号,以及大量实体、动作的机械组合——当前生成器会把"结构一致"误当成"业务上合理"。288 是原始候选数,其中相当一部分甚至不是高质量候选,更不是接口数或漏洞数。
我顺手翻了当前 PoC:离"自动发现"还差五个坑
幻灯片讲的是研究设想,GitHub 上公开的是 proof of concept。两码事。
截至本文整理时,仓库明确写着:这是研究型 PoC,结果可能不一致,生产测试要和传统方法结合;README 对自有本地模型的评价是 Poor / Demo testing only,默认反而推荐商业云模型。
为避免仓库后续更新导致结论漂移,代码核对时间固定为 2026 年 7 月 14 日,当时 main 提交为 9d8f70020b37994b2478e63fd6582f42c0d01068。
翻完代码,发现五个会直接影响结果的问题。
1. DNS 解析成功 ≠ 发现真实子域
dns_validator.py 主要通过系统解析器查 A/AAAA,能解析就把 exists 设为 true。代码没先用随机标签测试 wildcard DNS。如果目标把 *.example.com 全部解析到同一个 IP,AI 生成的每个胡乱候选都会被记成"存在"。
2. 收到 HTTP 响应 ≠ 页面有效
http_validator.py 只验证 DNS 命中子域的根页面,不验证模型生成的 API 或 path。它会分别尝试 HTTPS 与 HTTP,拿到响应就把 accessible 设为 true。404、403、500、统一默认页都可能进入"可访问"结果。默认 verify_ssl=False,同时跟随重定向——所以 accessible=True 既不能证明证书身份,也不能证明最终页面仍属原目标。真正的路径验证必须加入随机基线、正文哈希、长度、标题、重定向链和 soft 404 聚类。
3. 默认并发本身就可能制造护网噪声
核心类构造器默认 DNS 并发 50、HTTP 并发 20,但当前 CLI 实际覆盖为 DNS 20、HTTP 15;HTTP 还会分别尝试 HTTPS 与 HTTP。对公开大站不算夸张,对带速率限制、WAF、脆弱网关或演练白名单的环境,已经够触发封禁和告警了。"AI 生成更少候选"的价值,不能被不受控的并发重新抵消。
4. confidence_score 可能只是模型自嗨
路径分析提示词要求模型在 JSON 里返回 confidence_score,代码直接读取。这个数不是通过 DNS、HTTP 或标注测试算出来的校准概率。模型说自己有 0.92 的信心,不代表候选有 92% 概率存在。
5. 幻灯片里的响应反馈闭环,代码还没完整落地
第 98 页画的是方法探测、行为对比和异常评分;README 仍把 response-aware fuzzing 列在后续改进里。当前 generate path 没有 --validate 或 --check-http,公开的 HTTPValidator 只服务于 DNS 命中子域的根地址,没实现 GET、POST、PUT、DELETE 的完整方法循环、随机基线、异常评分与反馈闭环。
也就是说,目前最成熟的部分是"生成候选",最关键的"根据真实响应持续修正候选"仍然需要测试人员自己补上。
这不是否定项目。恰恰相反,它说明这项研究最有价值的是方法论,不是下载个工具就自动出洞。
护网里怎么把它接进现有打点流程
更稳的落地方式,不是让 Agent 拿着目标域名自由发挥,而是把它夹在"种子收集"和"低噪声验证"之间。
第一步:只收授权范围内的真实种子
来源包括证书透明度、被动 DNS、搜索引擎、公开文档、JS 路由、Sitemap、OpenAPI/Swagger 残片、代理历史和已有资产台账。先去重、确认归属和授权范围——第三方 SaaS、供应商域名和同名品牌资产别因为模型觉得相似就自动纳进来。
第二步:给目标建"命名画像"
别一上来就让模型吐一万个名字。先让它输出可审计的结构:
| 维度 | 要观察的内容 |
|---|---|
| 分隔符 | -、_、.、无分隔 |
| 大小写 | Usr、usr、USER、驼峰 |
| 版本 | /v1/、/v2/、api1、日期版本 |
| 实体 | user、usr、member、account、adm |
| 动作 | create、crt、save、add、rmv、disable |
| 环境 | dev、stage、uat、pre、prod、dr |
| 地域 | cn、sh、bj、use1、euw1、机房简称 |
| 编号 | 是否补零、位数、起始值、集群前缀 |
画像能被人复核,后续候选才知道是怎么来的。
第三步:规则生成和模型生成一起跑
确定性强的交给规则:数字范围、大小写、固定分隔符、已知地域表。需要语义的交给模型:crt 对应的同族动作、内部项目简称、产品和业务实体的邻近关系。
每个候选同时保留理由,比如"同一目标出现过 use1 和 use2""由 Usr_crt 推断 Usr_rmv""来自通用词,不含目标证据"。这样后续可以按证据强弱排序,而不是把所有输出摊平成一份新的大字典。
第四步:先排除假阳性,再谈命中
子域验证至少做:随机不存在标签识别 wildcard DNS、A/AAAA/CNAME 和证书/SNI 对照、HTTP 标题/正文哈希/重定向/默认页聚类、确认 CNAME 指向的第三方服务是否仍在授权范围。
路径验证至少做:随机路径作为 soft 404 基线、状态码/响应长度/正文相似度/框架错误类型对比、405 和 Allow Header 与普通 404 的差异、登录跳转/统一网关页/WAF 拦截页单独聚类、默认先用无副作用方法。
第五步:把真实反馈喂回去,而不是让模型继续脑补
Usr_rmv 与随机路径响应相同 → 降权;返回 405 而随机路径返回 Controller Not Found → 升权;同一词根下多个候选都命中同一套框架错误 → 围绕这个词根扩写下一轮。
完整闭环应该是:
真实种子
  → 命名画像
  → 规则 + AI 生成少量候选
  → DNS / HTTP / 响应差异验证
  → 有效模式回灌
  → 下一轮更窄的候选
真正提高效率的是搜索空间不断收敛,而不是让 AI 无限发散。
蓝队真正要防的,不是"AI 扫描器"四个字
如果一个测试环境只靠名字难猜来隐藏,AI 只是让这种脆弱设计更快暴露。
1. 隐藏后台必须按已暴露资产防护
dev-admin-use1-cx02 再怪,也不能代替身份认证、网络隔离和逐接口授权。管理面、预发、测试、CI/CD、监控和运维接口应进入统一资产台账,放在 VPN、身份代理、独立管理网络或明确访问控制后面。
2. 别让错误页变成路由字典
不存在的路由返回一套正文,存在但方法不对返回另一套详细框架异常——攻击者就能在没权限的情况下判断 Controller 是否存在。外部响应尽量收敛,详细异常留在内部日志;同时保留足够的请求 ID,避免统一错误页以后反而没法排障。
3. 鉴权必须落到每个方法和每个功能
API 网关只验证"已登录"不够。创建、删除、批量导出、管理员查询等动作要做功能级授权,GET、POST、PUT、DELETE 不能因为共用一条路由就共用一套宽松权限。
4. 检测低频、同词根、结构化探测
传统阈值常盯"一个 IP 每分钟打几千次"。目标化候选可能只有几十次,而且故意拉开时间。更有价值的关联特征是:同一客户端围绕 Usr_、Adm_、Acct_ 轮换动作缩写;对同一 URI 依次尝试 HEAD、OPTIONS、GET 等方法;子域只替换 region、environment、cluster 数字段;NXDOMAIN 序列呈现明显的结构化组合;低频请求持续命中同一组 404/405 差异。
5. 蓝队也可以先用同一思路打自己
把公开子域、JS 路由和 API 样本交给内部模型,看它能不能推导出未登记的 dev、stage、admin 和历史版本,再由资产团队验证。AI 辅助枚举对防守方同样适用——在攻击者之前找出那些"名字很怪、但公网确实能访问"的影子资产。
几个容易被夸大的说法
聊到这儿顺便说清楚:
第一,不是"AI 找到了后台"。AI 生成了候选,DNS、HTTP 和权限验证才决定候选是不是资产、接口或漏洞。
第二,不是"通用字典已死"。静态字典便宜、稳定、可复现,仍然适合覆盖高频路径;AI 更适合作为目标化增量层。
第三,Apple 示例里的地点、产品、区域和集群含义大多是模型推断,报告没证明这些解释来自 Apple 官方命名规则。
第四,生成 61 条原始序列、200 个子域组合或 288 个 API 候选,不等于发现相同数量的真实资产——原始序列甚至未必都能通过格式过滤。
第五,2,200 万子域和 2,800 万路径不等于同等数量的唯一、存活、干净训练样本。没来源、去重和测试集隔离信息,就没法判断数据泄漏与记忆程度。
第六,报告没有正式基准证明 Qwen3-4B 在相同请求预算下普遍优于 SecLists、Amass、Subfinder 或 ffuf。
第七,本地 Enumeraite 模型目前仍是实验品,官方仓库自己定位为 Demo/testing only,输出不稳定。
第八,把目标完整资产、内部 URL、客户名和业务接口发给外部商业模型,可能造成数据合规和项目保密风险。敏感目标用脱敏样本或本地模型。
第九,HTTP 200 不等于命中,DNS 可解析也不等于归属。wildcard、CDN 默认页、soft 404 和第三方 CNAME 都会制造假阳性。
第十,自动尝试 PUT、POST、DELETE 可能改生产数据。授权测试也必须限定方法、速率、时间窗和回滚方案。
把这些限制写清楚以后,再回头看这项研究,最值得带进护网的仍然不是某个模型的名字,而是一种新的枚举顺序:
以前是先准备一份全世界通用的字典,再拿目标去碰字典。现在是先观察目标,让目标自己泄露它的"语言",再生成一小批只属于它的候选。
目录扫描器没有错。
它只是不会问:为什么这个系统把 User 写成 Usr,把 create 写成 crt,把 remove 写成 rmv;为什么 use1 后面总跟着补零的 cx02;为什么登录系统叫 login-dev 而静态站叫 about。
这些问题以前靠经验丰富的渗透测试人员盯着资产表手工找规律。现在模型可以把这部分观察力放大。
但最后那一步仍然不能交给幻觉:域名要解析,页面要去重,接口要比响应,权限要做对照,状态变更要可回滚。
所以下一次目录字典全是 404,别急着下结论说"后台不存在"。
后台可能不在字典里。
它只藏在目标自己的命名习惯里。
而 AI 最先学会的,可能不是怎么攻击它——而是怎么把这个名字猜出来。
资料来源
DEF CON 33 原始 Google Slides
DEF CON 33 原始 PDF 导出(105 页)
Recon Village 议题页:enumeraite
DEF CON Conference 官方演讲视频
enumeraite 研究网站
enumeraite 官方 GitHub 仓库
enumeraite Hugging Face 模型与数据集
固定版本:CLI Commands
固定版本:DNS Validator
固定版本:HTTP Validator
固定版本:Path Function Analysis
相关背景论文:Offensive AI: Enhancing Directory Brute-forcing Attack with the Use of Language Models
本文只讨论授权安全测试、攻击面治理与检测方法。文中的域名和接口均来自公开研究材料或抽象示例,不代表对相关企业当前资产状态的确认。
🔚 觉得有用就转给今年负责资产梳理、外网打点、API 安全和护网值守的同事。字典没命中,不代表资产不存在——有时候只是你的字典还不会说目标的方言。