Agent 写稿突然“断片”?OpenViking 治好了我的内容创作焦虑
原创 Viking AI搜索 2026-09-16 19:05 北京
凌晨十二点,知识博主小O终于和 Trae 磨好了选题、对齐了写法,还喂了几篇旧文,让它照着账号风格写。文章写到一半,却弹出提示:额度已用完。想换个 Agent 接着写,却发现选题思路、写作要求、账号风格,全留在旧对话里,换个工具就得重讲一遍。截稿时间越来越近, Trae 沉默不语,急着交稿的小O只能在深夜里独自凌乱...
你在做内容时是不是也遇到过这种困境?
选题时,每期都从零想“下一篇写什么”。
写稿时,正文一篇篇生成,语气风格却大相径庭,还容易出现幻觉。
做封面、配图时换了一轮又一轮,视觉却越来越散。
复盘时,数据经验经常丢失。
开通了多个账号,统一管理困难。
有时要多个 Agent 来回切换,但它们之间往往没有共同记忆,过了几天开了新的聊天窗口,Agent 就忘了前面输入过的内容,每一次都得从头再来。这种问题的根源在于:
缺少一套可结构化、可召回、可跨会话和跨 Agent 的长期记忆底座,而 OpenViking 则完美解决了这一问题。
一、OpenViking 是什么?
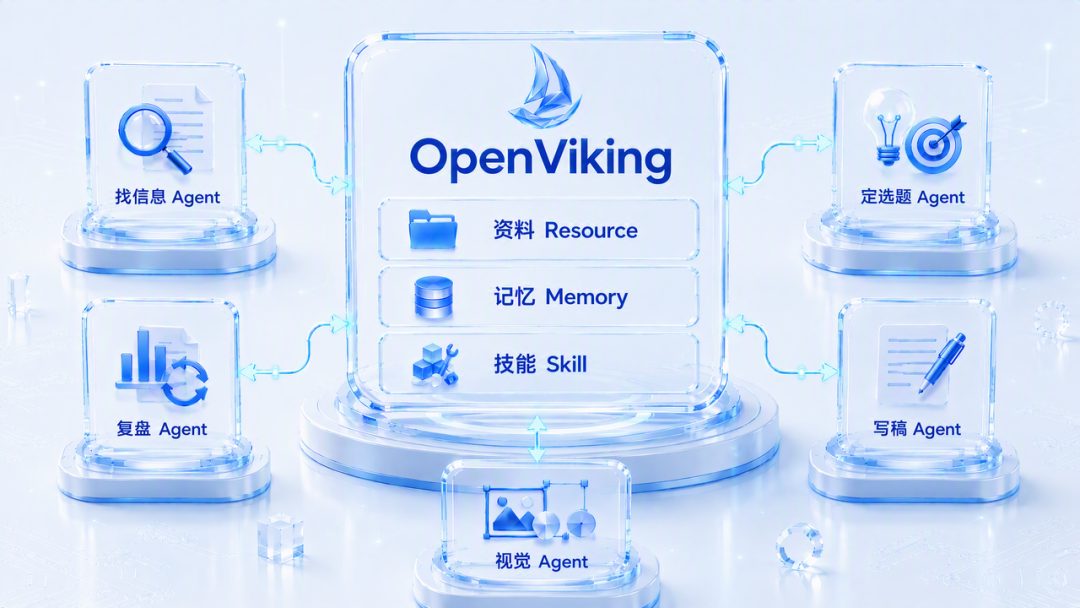
在创作场景,OpenViking 是连接内容创作者与不同 AI Agent 的记忆中枢。
它可以接入不同 Agent,把创作过程中需要的资料、偏好和经验统一组织起来。下次无论你打开哪个 Agent,只要它接入了同一个 OpenViking 服务,并且拥有相应访问权限,就能按需召回这次任务需要的上下文。
OpenViking 会把 Agent 工作时需要的信息分成三类:
Resource,资源:Agent 的资料库,包含参考文章、热点链接、账号定位、历史稿件等;
Memory,记忆:自动存储长期记忆,写作偏好、选题判断、被否标题、复盘经验;
Skill,技能:沉淀做事的方法,可以包含定选题、审稿、复盘报告等工作流。
Agent不需要每次面对一个问题,都把所有资料重新读一遍。它可以先读取 L0 摘要,定位到内容主题,再查看 L1 概览,了解该主题下的选题方向、目标读者、文章结构;需要具体细节时,再读取 L2 内容,查看完整文件。这样能把更多上下文空间留给真正重要的信息,减少了重复读取带来的 Token 开销,也降低了无关信息对回答的干扰。
二、OpenViking 能为内容创作者带来什么?
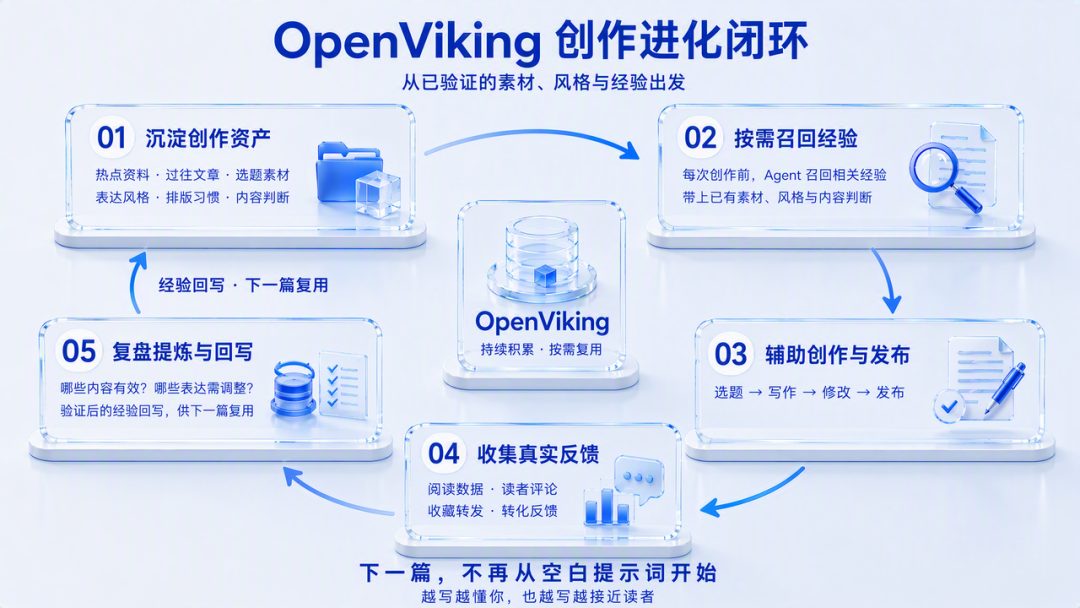
有了 OpenViking ,你可以沉淀热点资料、过往文章和选题素材,也可以保留自己的表达风格、排版习惯与内容判断;每次创作前,Agent 会按需召回相关经验,辅助完成选题、写作和修改;文章发布后,再把阅读数据、读者评论和转化反馈带回复盘,提炼出哪些内容真正有效、哪些表达需要调整,形成一个持续进化的闭环。这样,下一篇文章不再从零开始,而是站在你已经验证过的风格与经验之上,越写越懂你,也越写越接近读者。
1、沉淀长期记忆和个人风格,让经验进入下一篇
内容创作者最珍贵的资产,是逐渐积累和形成的内容素材,表达习惯和复盘方法。而 OpenViking 会把创作过程中反复出现的信息沉淀成不同类型的长期记忆,这样一来,AI 不只是帮你写下一篇,而是在你已有的内容资产上持续迭代。当小O想不出选题时,Agent 可以结合历史账号定位、历史选题和复盘数据,结合输入的爆款文章,扩充几个真正适合她的方向,而不是抛出一堆泛话题。发布后,复盘的内容也可以连同原始数据进行保存,作为下一篇内容优化的参考。
账号画像:内容写给谁、解决什么问题、账号的长期定位是什么;
表达偏好:喜欢故事化开头,少用空泛大词,结论要给具体做法;
选题记录:哪些方向做过、哪些角度被否过、哪些话题值得持续追踪;
关键事件:某次标题调整、某轮审稿意见、某次发布时间变化;
复盘经验:哪类开头带来更高完读,哪种封面点击更好,哪些内容评论区争议大。
2、记忆精准召回:迅速找到当前任务需要的那几条
当 Agent 接到任务时,它会先理解这次要做什么,不同任务需要的上下文并不一样。
找选题时,需要账号定位、历史话题、用户关注点;
写正文时,需要语气偏好、结构模板、审稿意见;
做视觉时,需要封面规范、配色、字体和历史高点击素材;
复盘时,需要核心数据、读者反馈、调整方向。
OpenViking 会根据任务意图,在资料、记忆和技能中做分层检索,再把相关内容交给 Agent,让每一次的生成结果有依据可循。更关键的是,OpenViking 没有把所有内容混在一个扁平的向量库里,而是给它们分配清晰的 viking:// 地址,像文件系统一样组织起来,这样一来,Agent不需要每次面对一个问题,都把所有资料重新读一遍。
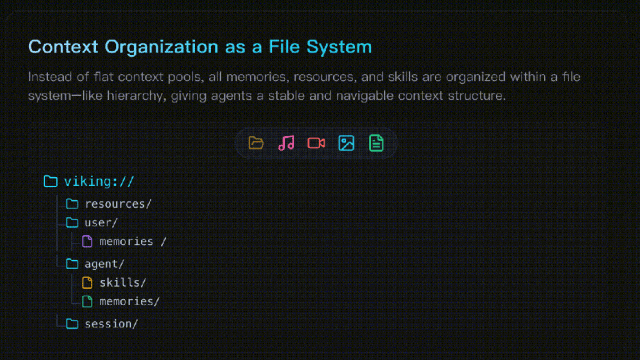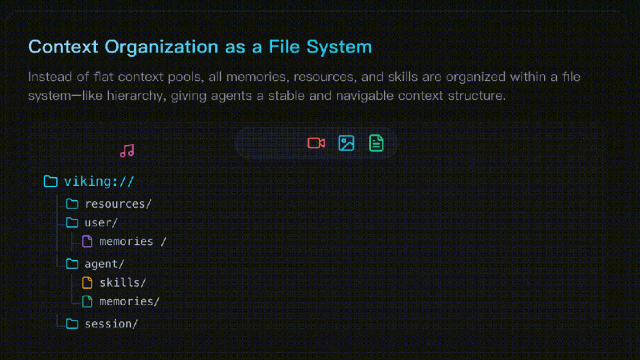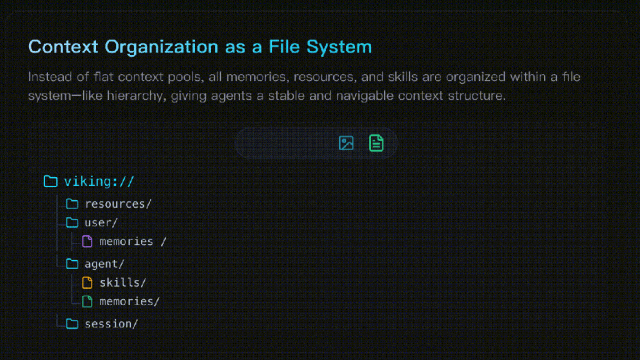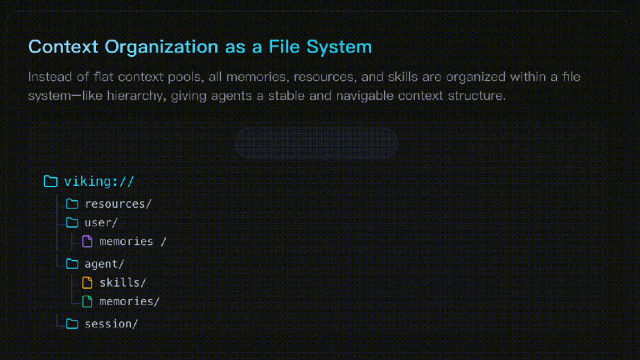
3、多 Agent 记忆共享:经验和资料可以跟着任务迁移
内容创作天然是一条多环节链路。找信息的 Agent 不一定负责写稿,写稿的 Agent 不一定负责做视觉,做视觉的 Agent 也不一定参与复盘。如果每个 Agent 都各记各的,就会出现三种断层:
调研 Agent 找到的热点,写稿 Agent 不知道为什么值得写;
写稿 Agent 确认的语气,视觉 Agent 做封面时没有延续;
复盘 Agent 总结出的经验,下一轮找选题时又没人记得。
接入 OpenViking 后,这些 Agent 可以围绕同一份项目上下文协作:前一个环节沉淀的资料和判断,后一个环节可以按需召回;后一个环节产生的新经验,也能继续写回,供下一篇使用。在 Codex 里整理出的选题依据,可以被写稿 Agent 继续使用;在视觉环节确认的封面规范,下次做分享卡时仍然有效;发布后复盘得到的表达经验,也能回到选题和写稿阶段。
需要说明的是,这种共享发生在同一个 OpenViking 服务、账号身份和授权边界内。不同工具的接入方式不同,有些插件支持更自动的召回与写入,通用 MCP 接入则更多通过工具调用完成。
三、案例展示:形成 AI 内容生产闭环
小O围绕自己的创作习惯,把整个流程设计成五个阶段:灵感收集、定选题、写内容、做视觉、复盘。
阶段一:灵感收集,构建自己的话题池
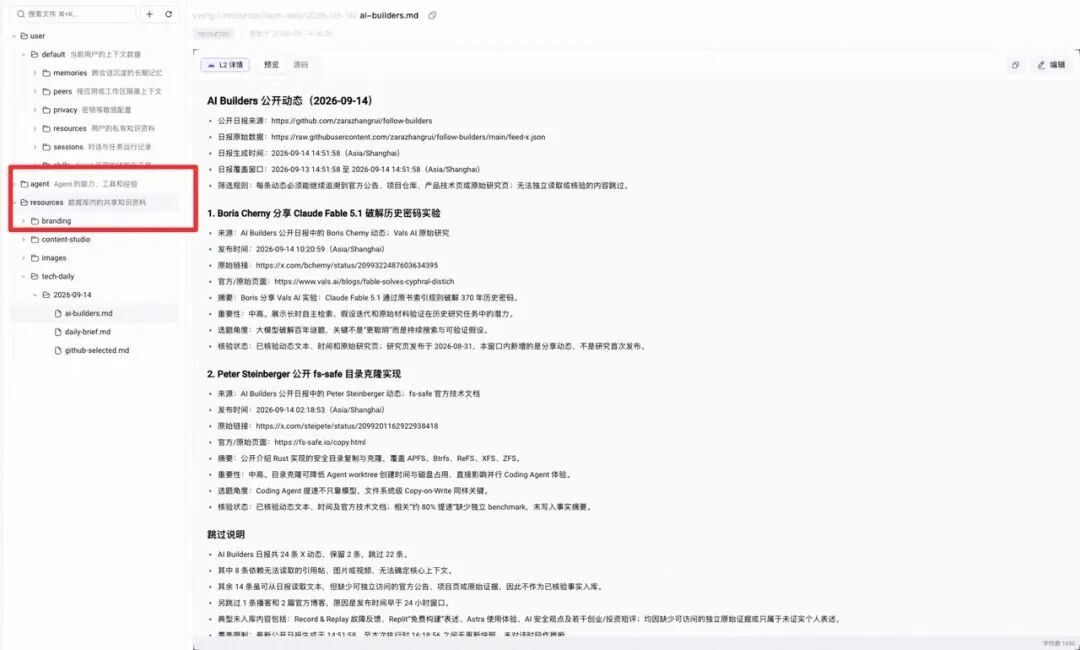
小O日常需要收集很多灵感素材,她创建了定时任务,每天抓取 github 日报,AI builder日报等等作为素材库,但除了让 AI 自动抓取,她平时还会手动收集其他素材,包括文档,链接等等,分布很零散,现在,她可以直接把这些内容收集到 OpenViking 中进行整理,形成了个人的素材灵感库。
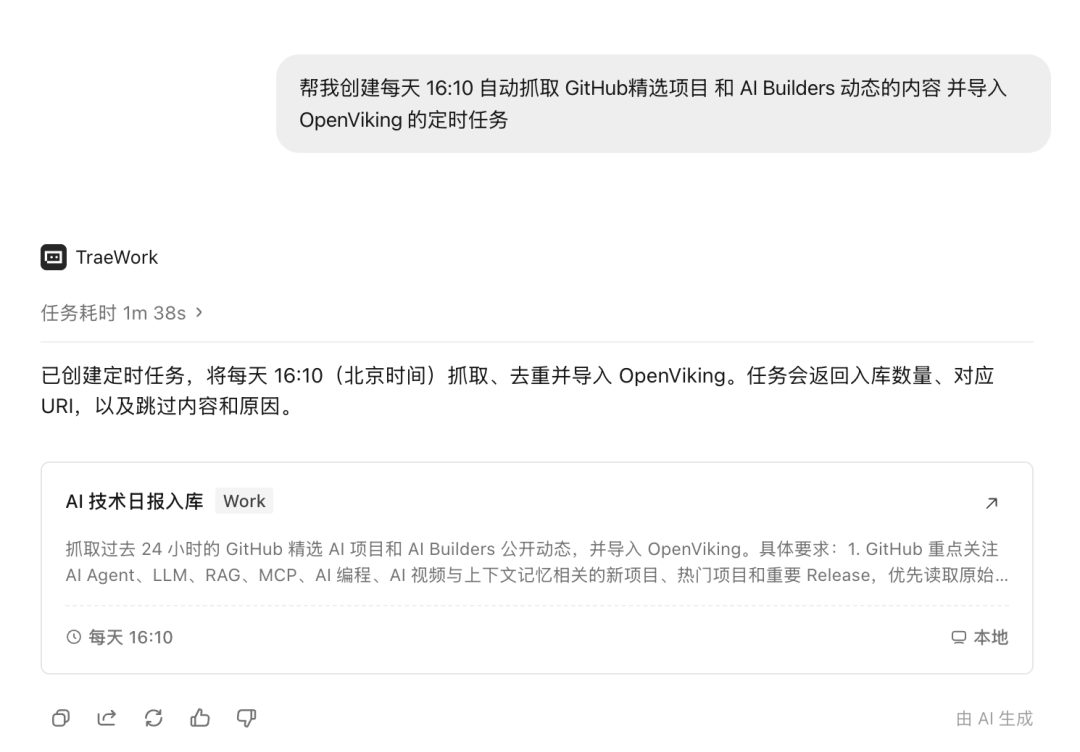
在 Trae 中创建定时任务,抓取热点素材
上传资源总结在 resources 中
在平时,她也会体验并使用不同的 Agent 产品,在体验过程中的感受、记忆、会话上下文,OpenViking都会沉淀成个人的经验。让原本散落在对话里的内容,被整理成了可检索、可复用的个人经验库。在不同平台看到优质的文章,小O也都会收录进 OpenViking 中,并且提取共性特征,沉淀成不同平台爆款文章的文风,方便在多平台进行内容分发时,对原始文章进行微调,使其符合平台内容调性。
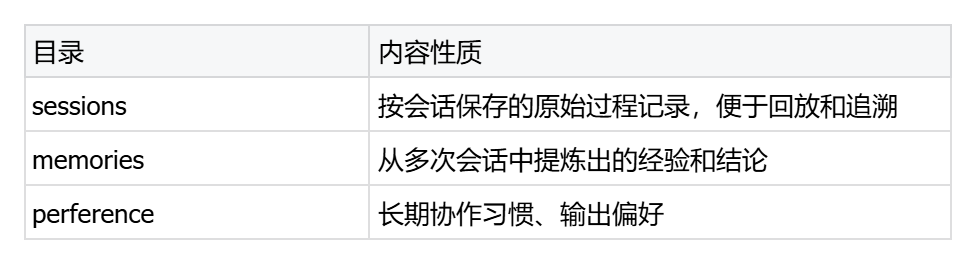
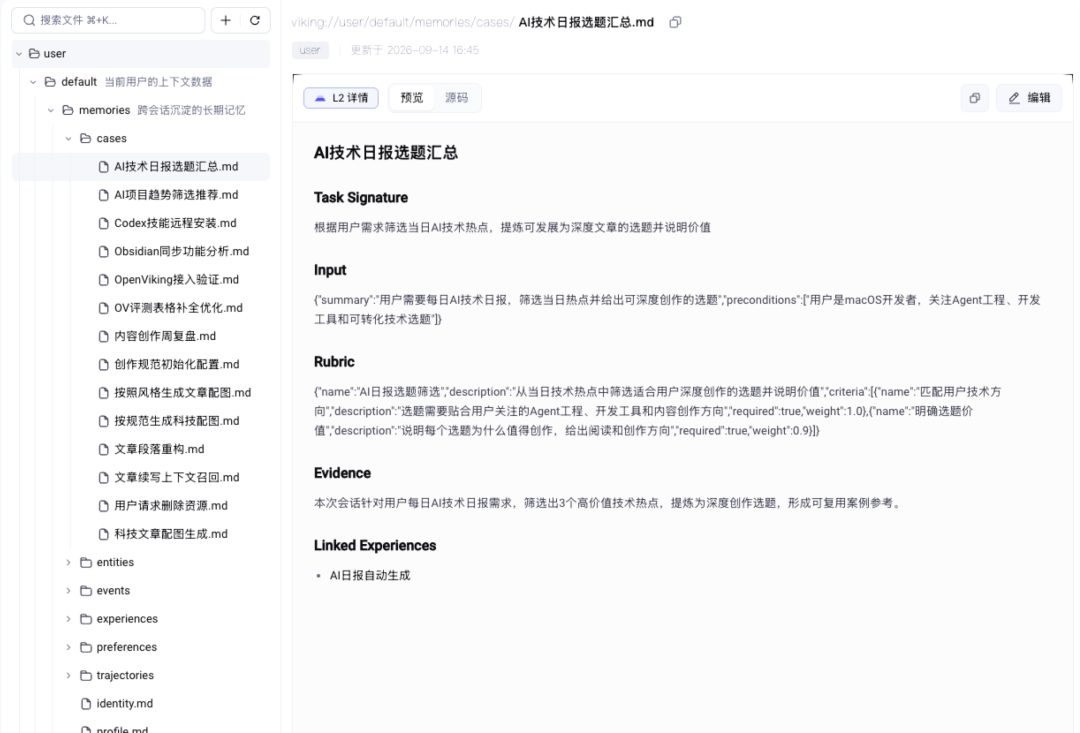
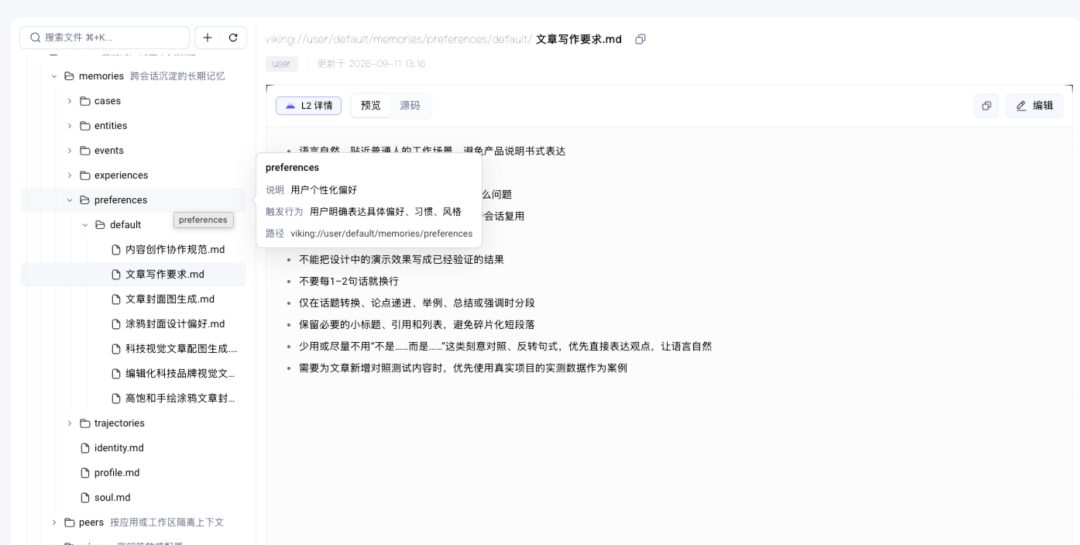
memories 中沉淀跨会话的个人长期记忆案例
preference 存储风格、习惯和偏好
阶段二:生成为你量身定做的选题
小O通过前期交流,沉淀了自己账号定位的人群偏好。当她输入帮我想几个选题,会基于她所有的历史经验进行推荐。OpenViking 会进行意图分析 + 层级检索,理解真正想做什么。会先借助 LLM 对请求进行意图识别,判断需要调用哪一些信息,再将输入的内容拆成子查询,让用户知道应该进入哪一个召回的目录,相比只按相似度召回文本片段的传统 RAG,OpenViking 更强调把资料、个人经验和任务背景组织起来,再按需检索和读取,让生成内容更符合账号风格。基于这个推荐,小O有了更多灵感参考,不用为选题苦恼。
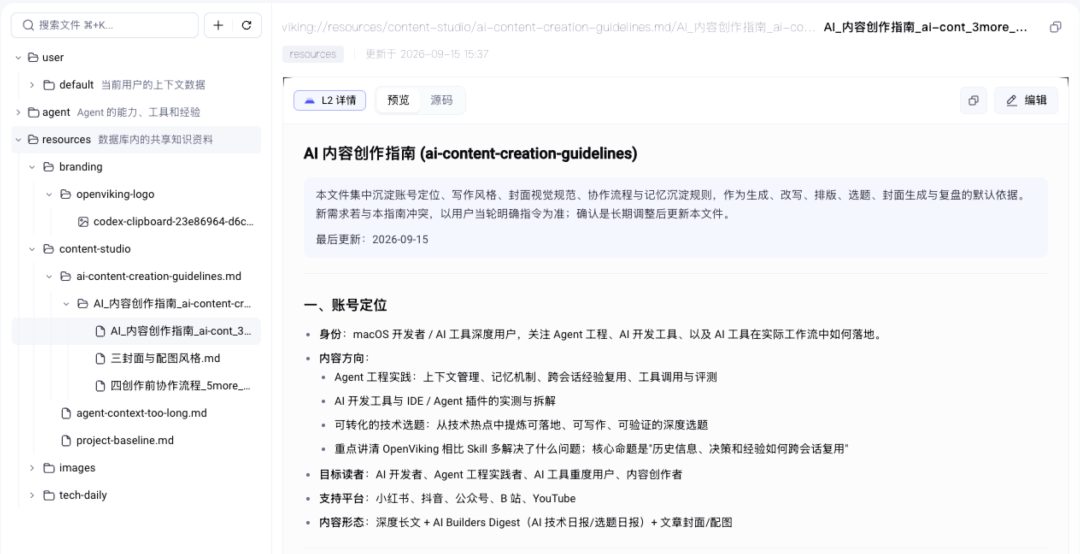
Open Viking 沉淀了账号定位及写作风格等
结合账号定位和捞取的热点内容生成选题
阶段三:写内容,跨Agent 也能接着写
在Trae里输入选题后,小O开始了内容生成,她提前说明了将生成内容导入到 OpenViking,在写作过程中, Agent 会分阶段保存草稿、上下文要求和提纲等等内容,突然,文章写到一半,额度又用完了。如果是以前,小O只能打开新 Agent,把资料、提纲、风格要求重新贴一遍。而现在,小O丝毫不慌,她打开 codex,先确认了一下 OpenViking 是否有保存文章,之后输入:
“继续完成《Agent 记忆不是越多越好》这篇文章,先召回 Open Viking 里这篇文章的风格,历史信息和已确认结构,再从中断的位置续写。”
codex × 续写正文
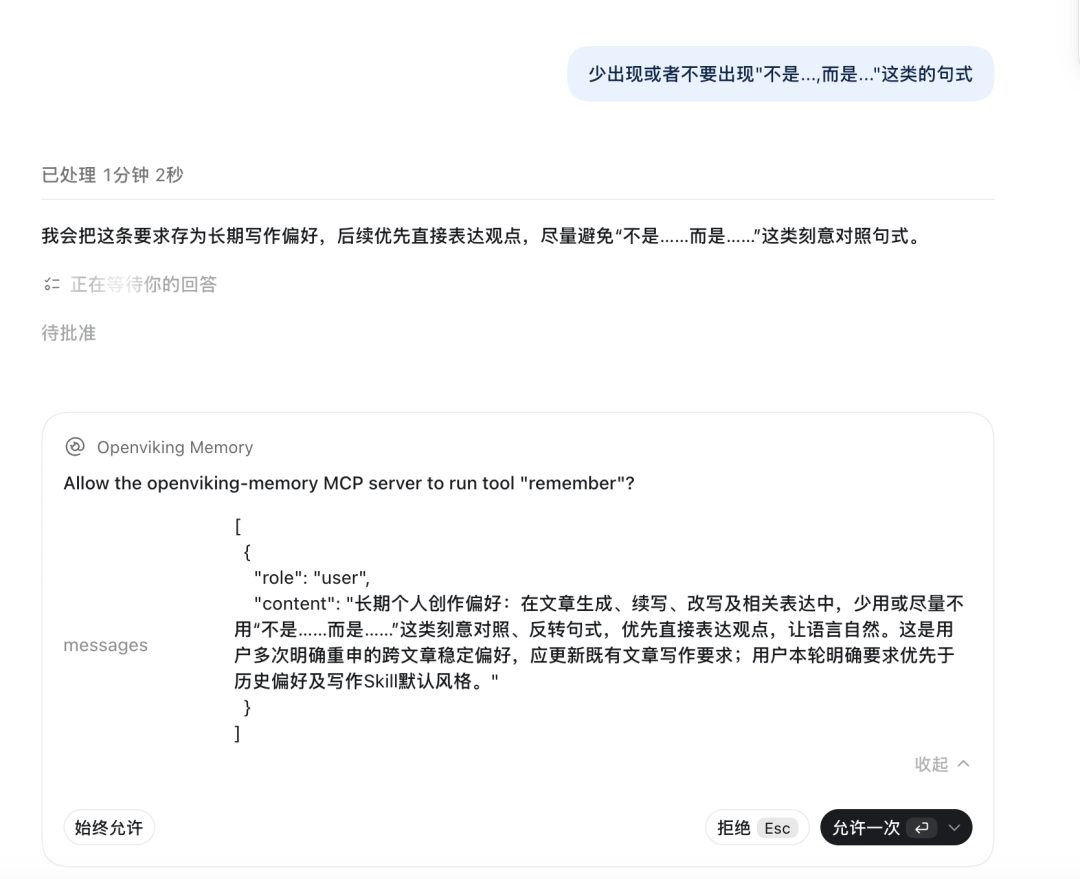
修改过程中确认并存入长期偏好
可以在生成的正文上不断修改,OpenViking 会把值得复用的信息存入长期记忆,之后通过语义检索,将相关偏好注入新的对话上下文中,而不是只保留在当前文章或当前聊天记录里,沉淀成独属于你的个人账号内容的风格。
阶段四:做视觉,让封面和卡片延续同一套风格
小O改完了正文的部分,于是开始生成封面,她把想要的风格上传,让 AI 解析其风格,不断调整,直到能生成想要的风格,并将其存储到 OpenViking 中,下一次生成,无需再反复提交生图提示词,只需要输入 Open Viking 中的风格名称,上传文章内容就可以生成风格统一的封面图和配图。
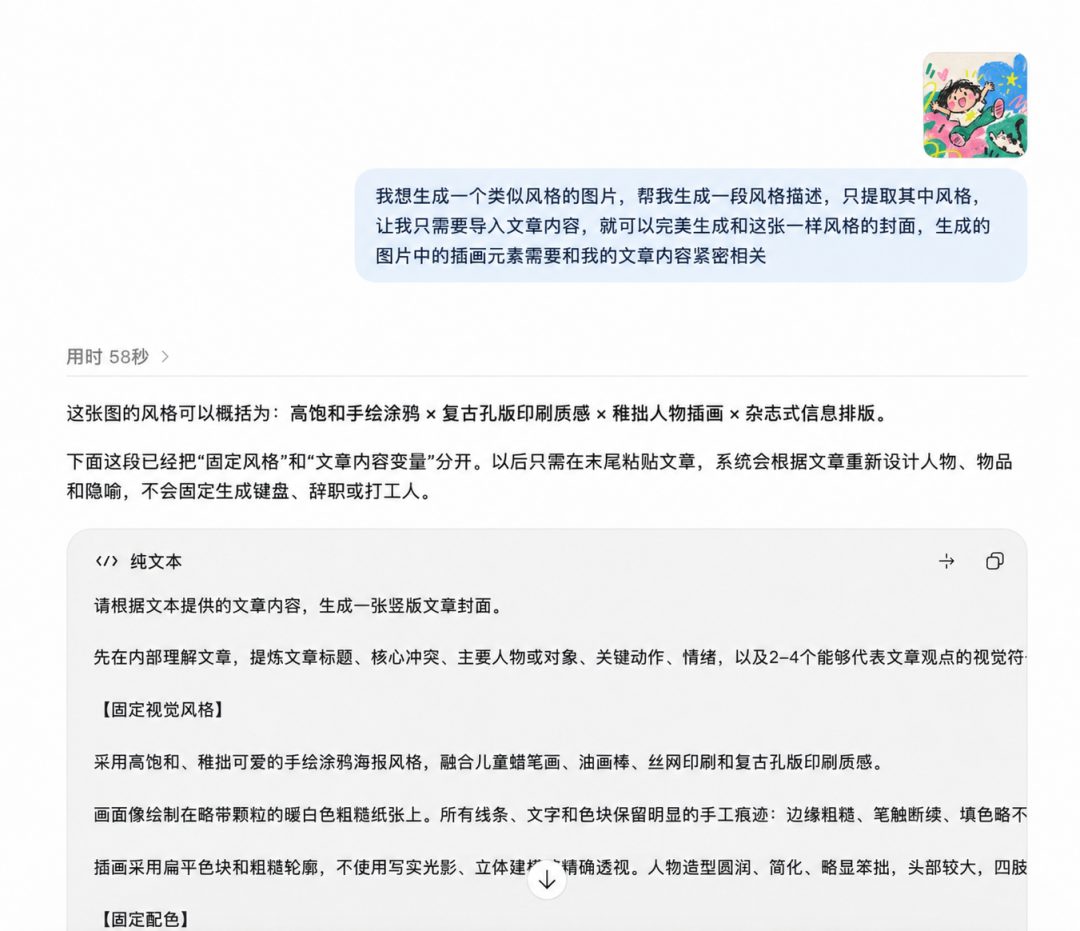
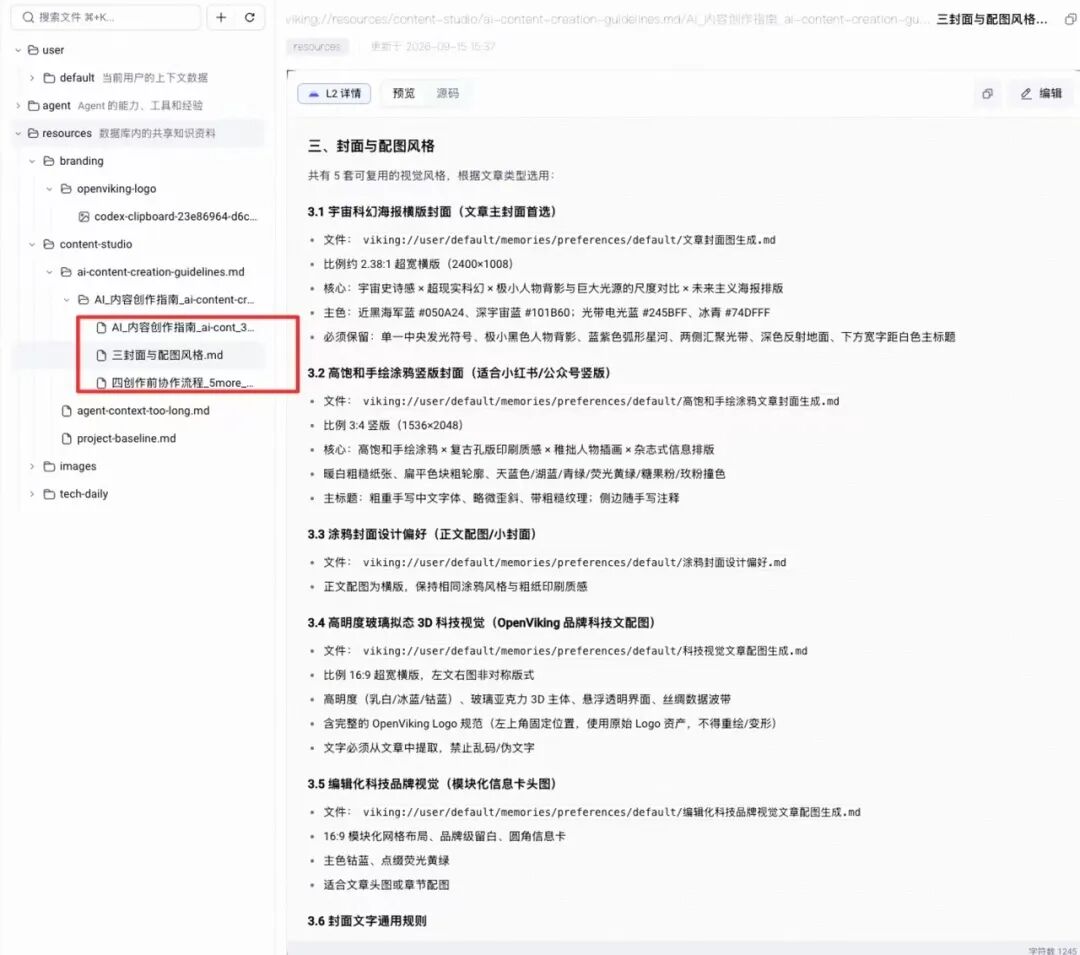
输入并上传想要统一的风格内容及要求
所有的配图及风格沉淀
从对比中可以明显看出,输入原文内容后,再输入风格提示词,已接入 OpenViking 的封面风格统一,而未接入的 Agent 生成的风格上下文丢失,效果不统一。
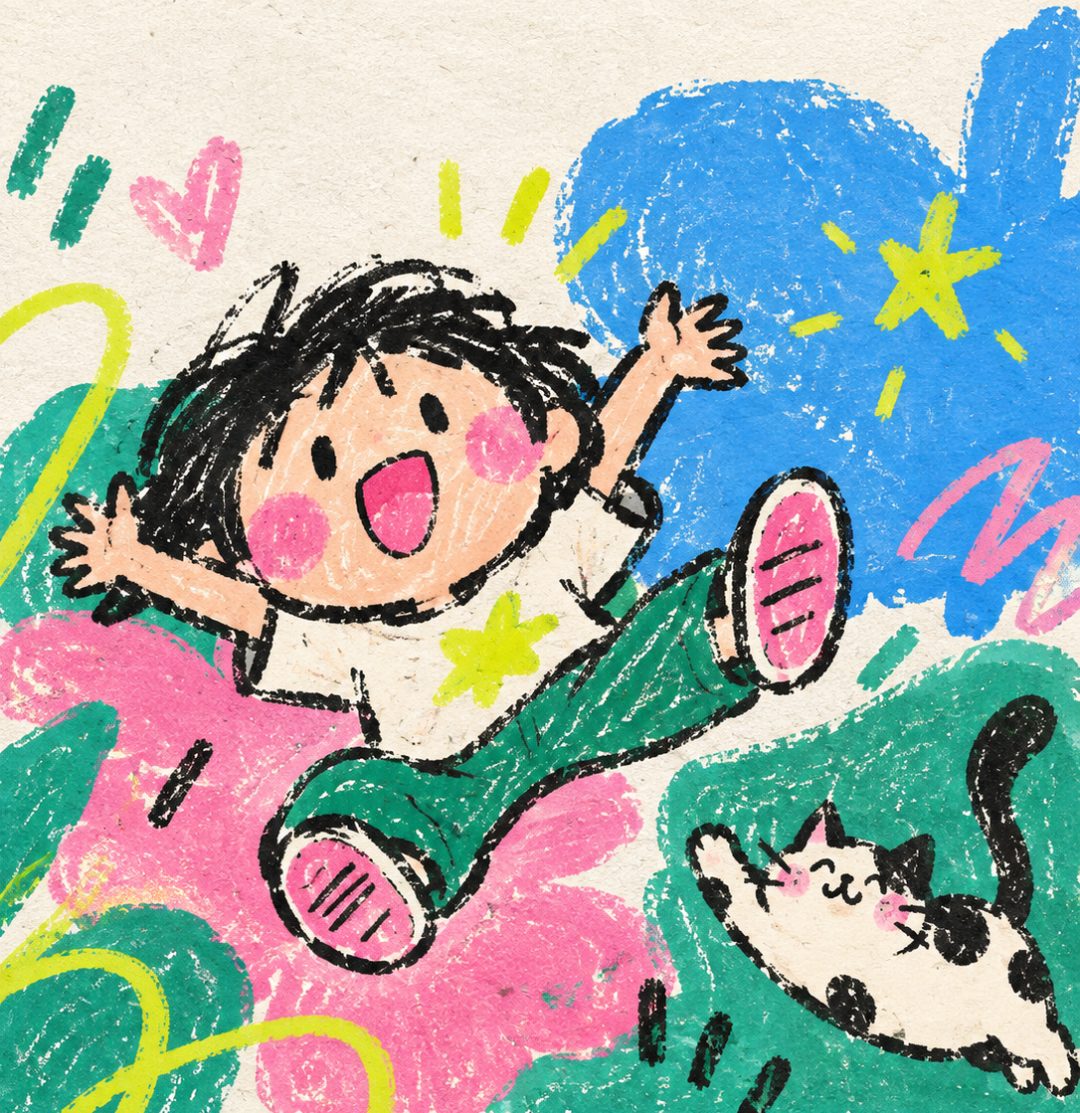
风格参考图
已接入 OpenViking
未接入 OpenViking
阶段五:发布后复盘,把数据经验交给下一篇
发布后导入文章数据和读者反馈,总结谁被吸引、为什么读下去、为什么愿意行动、下一篇应该怎么改,并将这些复盘的结论会写回 OpenViking,下一篇开始时,小O只需告诉 Agent:“根据 OpenViking 中复盘的数据和方向,再给我几个选题,继续使用我确认过的表达风格。”它便有了可检索的历史资料和判断依据,形成内容创作的闭环,不用再每次从 0 开始训练创作系统,让 AI 越用越懂你。
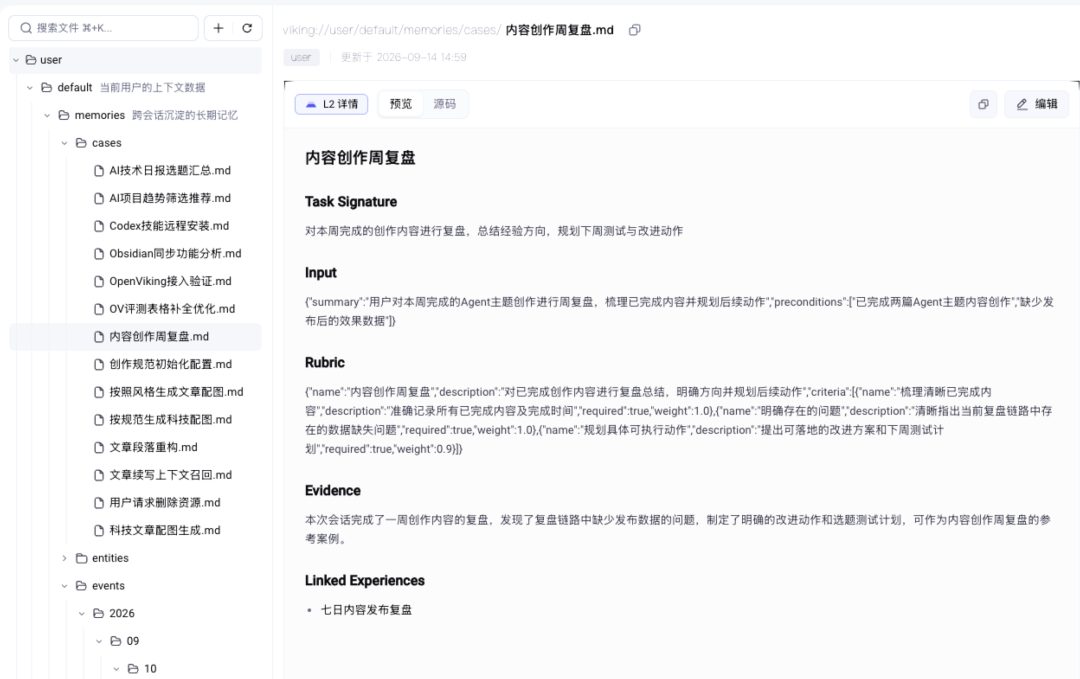
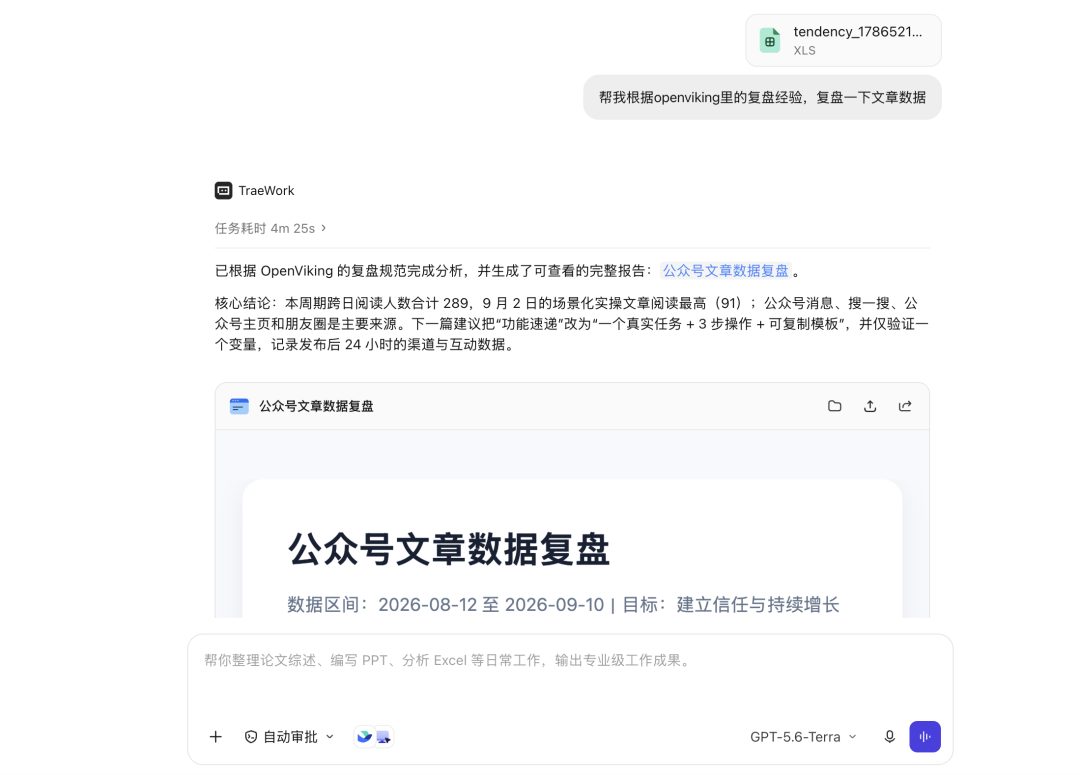
沉淀的周复盘模板
复盘经验用于之后的创作中
小O终于不用再每次从零开始,而是在一次次发布中训练一套越来越懂自己的创作系统。
四、快速开始
看了小O的经历,想必你也跃跃欲试,下面就来说说如何接入 OpenViking,操作很简单:
第一步:创建库
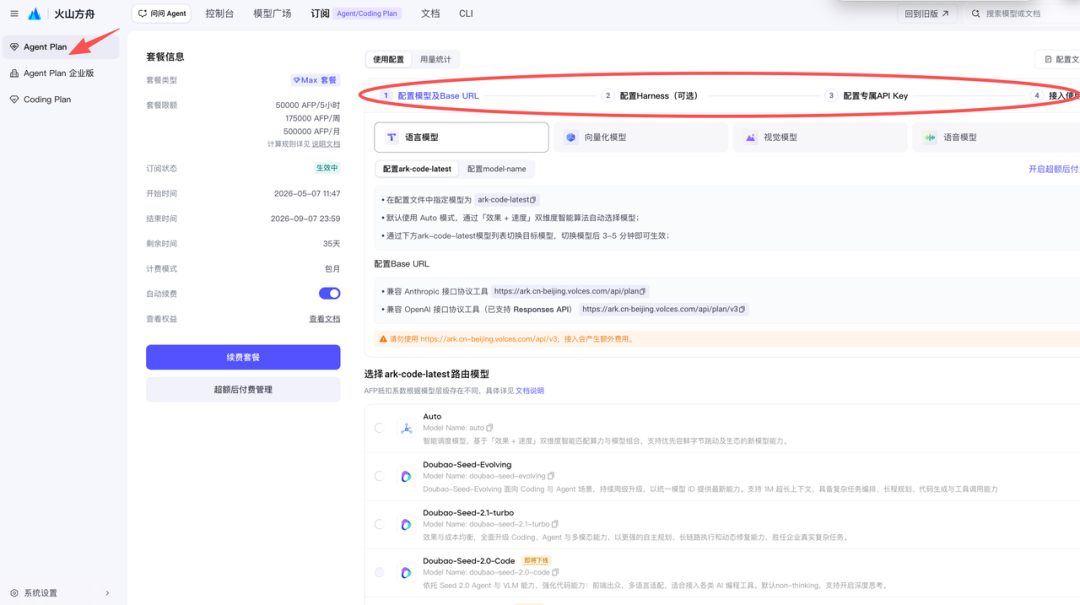
进入 Open Viking控制台(打开:https://console.volcengine.com/vikingdb/OpenViking/region:OpenViking+cn-beijing/),创建库,填写名称,描述版本,点击添加 Agent plan,未开通则需要开通创建,登录火山方舟官网(https://console.volcengine.com/ark/region:cn-beijing/subscription/Agent-plan?projectName=default),购买 AgentPlan Small 套餐(原价 ¥40 / 月,新用户活动期低至 ¥9.9)。购买后在控制台配置模型获取专属 Base URL 和 API Key。
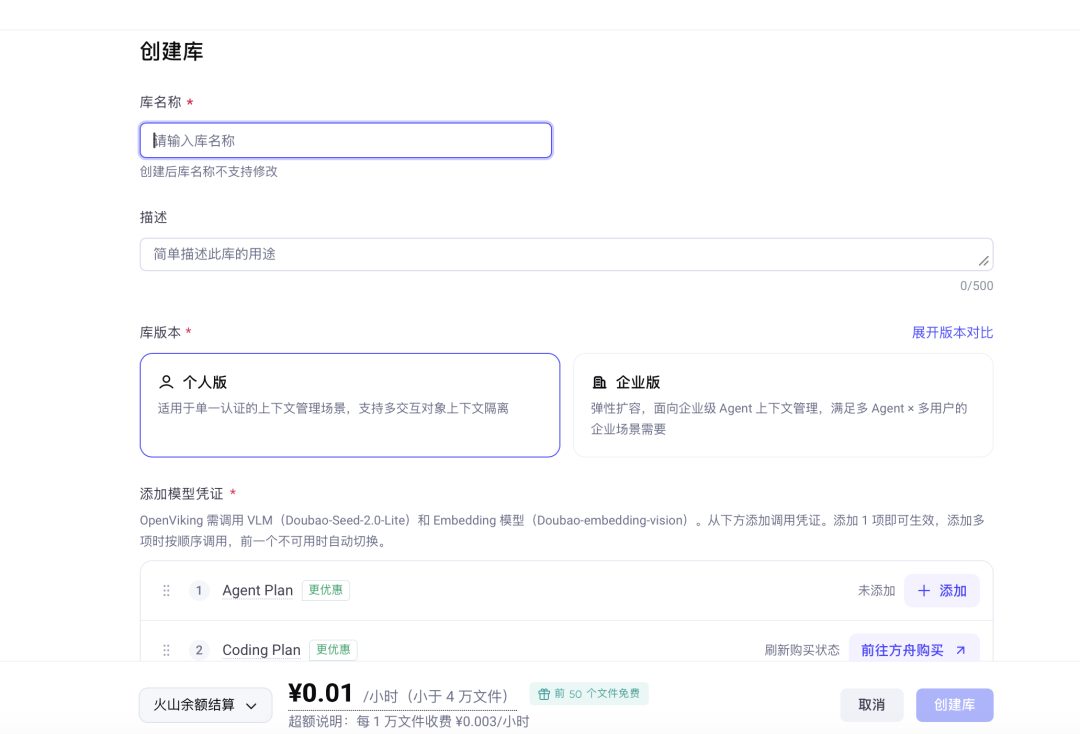
按需选择个人版和企业版
开通 Agent Plan 获取 AK
第二步:连接主流 Agent
OpenViking 支持不同深度的 Agent 集成:
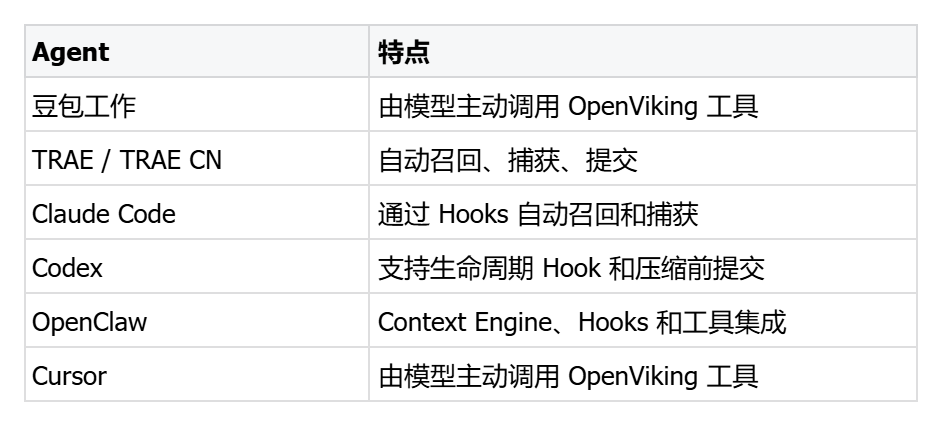
以 TRAE 为例,先进入到OpenViking Context 控制台 → 点击接入 Agent → 选择Trae → 点击复制为Markdown → 直接粘贴到 Trae 后运行,即可完成接入。
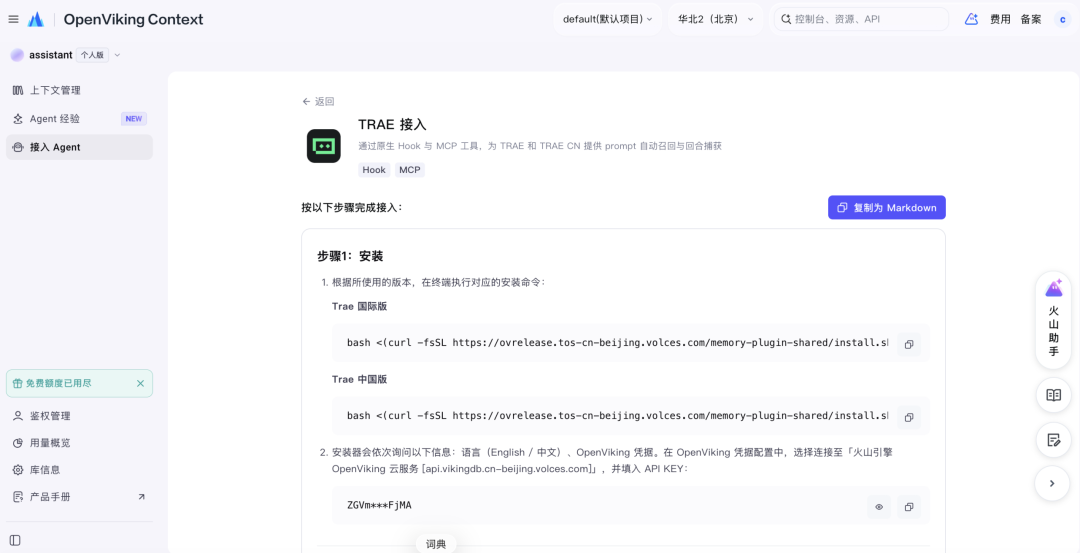
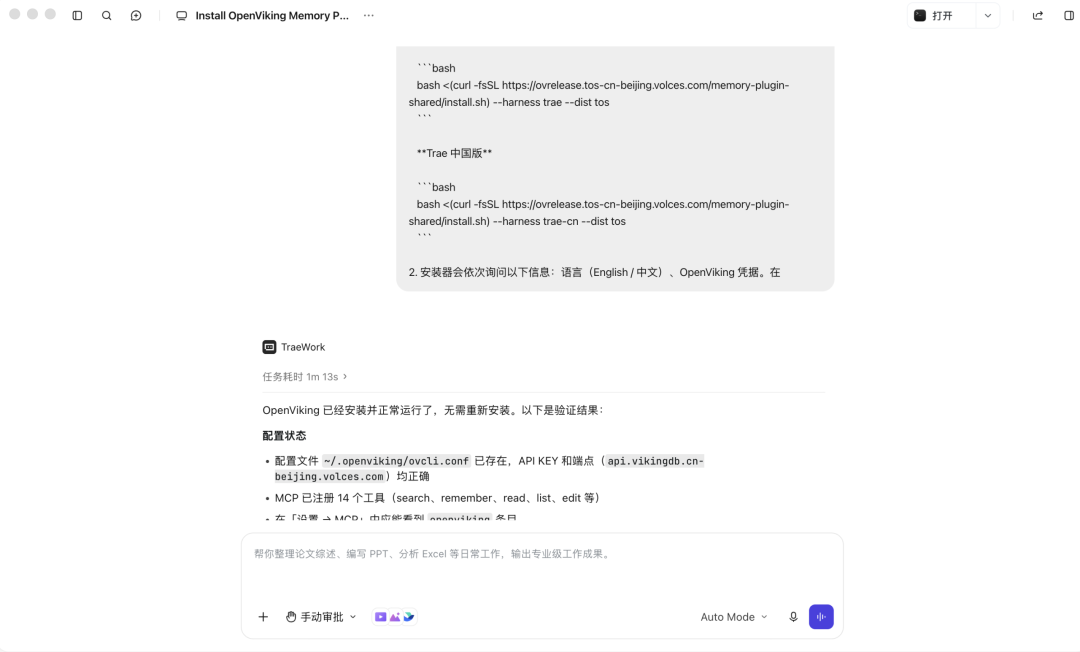
进入Trae 接入页,点击复制为Markdown
粘贴到 Trae 完成安装
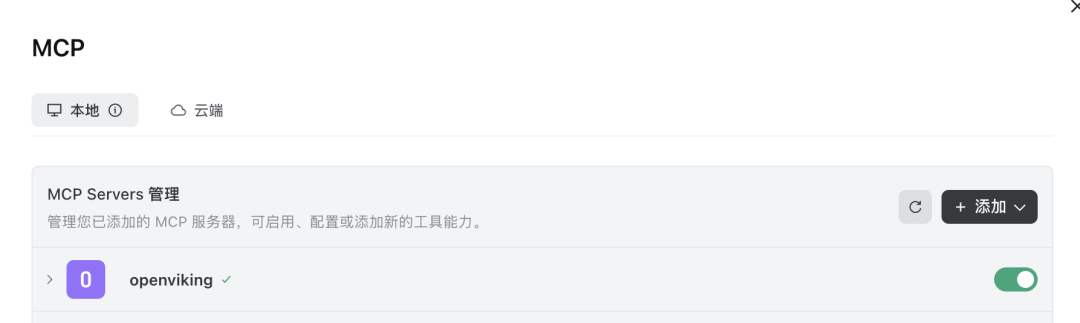
在「设置 → MCP → 已配置的 MCP Servers」中确认能够看到 OpenViking 条目即表示接入成功。
第三步:配置规则
1.新建规则
点击 设置 → 规则与记忆 → 创建。
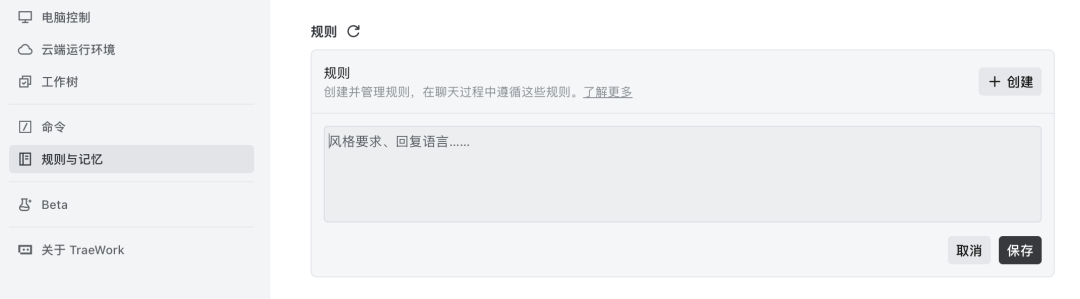
2.粘贴规则内容并保存
为了将上下文信息稳定导入 OpenViking,需要配置一段规则作为调用指引,将以下规则复制进去,可按需微调:
在与内容创作者的每一轮对话中,判断当前需求是否需要使用“创作历史记忆 / 个人偏好 / 内容规范 / 风格描述 / 数据复盘”。如有需要,优先利用 OpenViking 的 `search` 召回相关记忆,并以召回内容作为生成、改写、排版和选题建议的默认依据。当用户要求生成、续写、修改或优化文章时,主动检索并严格遵循已沉淀的创作规范,包括但不限于:文章风格与语气、段落长度与换行节奏、标题层级、开头与结尾写法、生成图片风格、常用表达、禁用词、内容结构、目标读者与平台要求。当用户对文章进行多轮修改时,识别其中可跨文章复用的稳定规律,例如对表达风格、叙事节奏、格式要求、选题判断和内容质量标准的偏好。对可长期复用的规则,使用 OpenViking 的 `remember` 提炼并存储为个人创作偏好;不要记录仅适用于某一篇文章的主题、案例、数据或临时要求。持续沉淀内容创作者与 Agent 协作中形成的有效经验,并存入到OpenViking的memories中,包括:- 已验证有效的选题方向、标题策略、内容结构与传播角度。- 用户认可或否定的表达方式、图片风格和修改偏好。- 定时收集的 AI 技术日报、行业热点、重要产品更新与可转化的创作线索。- 文章发布后的阅读、互动、转化等复盘数据,以及从数据中提炼出的内容优化结论。- 可复用的选题筛选逻辑、写作模板、复盘方法和内容生产流程。每次生成内容前,优先从历史记忆中确认创作者的既有规范,避免从零开始,也不要重复询问已经沉淀过的稳定偏好。若新需求与已有偏好冲突,以用户本轮明确指令为准,并在确认其为长期调整后更新对应记忆。
别再让每一次 Agent 协作都从零开始。无论是内容创作、代码开发、资料研究,还是项目决策,你的偏好、经验和判断都值得被持续沉淀、准确调用。快来试试 OpenViking,让每一次工作都成为下一次更懂你、更高效的开始。