安全运营中的 AI,为何总是看上去不太可信?
原创 创新研究院 2026-08-10 18:00 北京
AI安全运营的不可信,本质源于告警研判长期依赖有限条件下的合理推断。真正的智能化不应止于告警解释,而应让AI在受控权限下持续调查资产、身份、终端、网络与业务链路,形成可验证的根因结论,并沉淀为可复用的运营能力。
一、前言
安全运营中的 AI,经常给人一种“不太可信”的感觉。它能解释告警,能总结日志,能给出处置建议,也能把判断依据写得很完整。但到了真实运营现场,安全人员往往还是会追问一句:它凭什么这么判断?
这个问题不能简单归因于模型幻觉,也不能简单归因于提示词不好。更深层的原因在于,安全运营本身就不是一个证据天然完整的任务。大量告警研判,从来不是严格意义上的事实判断,而是在有限条件下做出的合理推断。
一条告警来了,分析师看到源IP、目的IP、端口、请求体、设备动作、资产信息和历史行为,然后判断它是误报、攻击尝试、攻击失败、攻击成功,还是需要进一步确认。表面看,这是分析师的专业能力;更本质地看,这是在信息不完整的情况下,做出一个当前看来相对合理的判断。
问题正在于,“合理”不是一个稳定边界。不同分析师、不同客户、不同业务系统、不同时间点,对同一类异常的解释都可能不同。所以,AI安全运营之所以看上去不可信,首先不是因为AI不会判断,而是因为它面对的本来就不是一个容易被证实的问题。
二、告警只是线索:安全运营为什么天然依赖“有限条件下的合理推断”
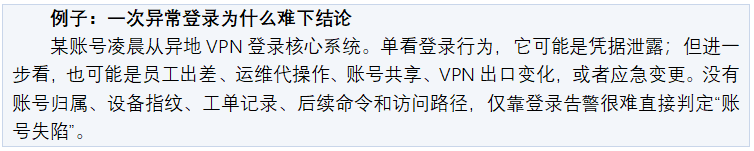
告警不是事实结论,而是风险线索。一次外联告警,只能说明某个实体访问了某个外部地址,不能直接证明它就是恶意C2;一次异常登录,只能说明登录行为偏离了某些规则或基线,不能直接证明账号已经失陷;一次文件外发,只能说明数据发生了流转,不能直接证明它就是泄露。
外部告警尤其如此。安全团队能看到的是攻击流量进入边界设备、WAF、NDR、EDR、SOC之后留下的局部痕迹,但很难彻底确认攻击者是谁、攻击意图是什么、背后是否还有其他基础设施、攻击链是否仍在继续。
内部告警也并不天然清楚。内部环境看似是自己的主场,但资产台账可能不准,账号可能共用,终端日志可能缺失,网络流量可能没有全量留存,业务行为也未必有标准解释。
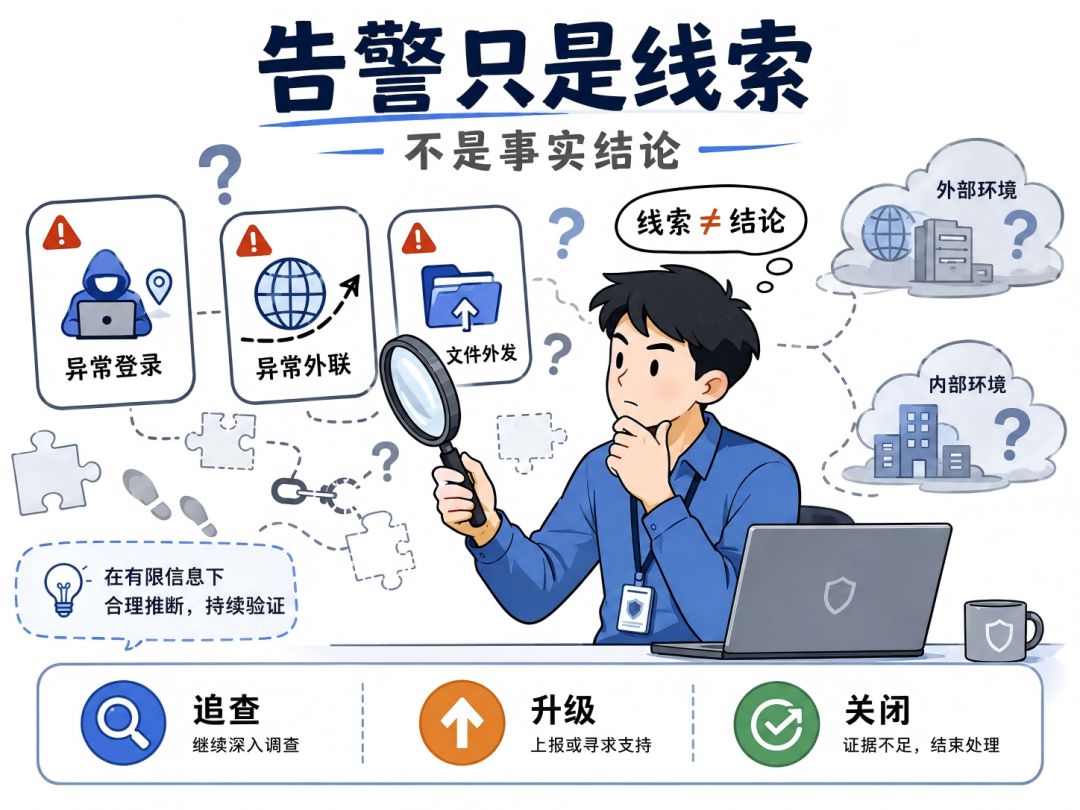
因此,安全运营不是简单的告警分类,而是在有限日志、有限上下文、有限时间、有限人力和有限系统开放度下,判断一条线索是否需要继续追查、是否需要升级、是否可以关闭。
这就是“有限条件下的合理推断”。它支撑了过去很多年的安全运营,但也正是AI安全运营今天看上去不可信的根源之一。
三、“合理”为什么难工程化:LLM不能只是自动化人的模糊判断
如果一个安全场景的判断边界足够清晰,就不需要大模型。IP明确命中黑名单,规则即可;文件哈希明确命中恶意样本,规则即可;离职账号仍然登录,策略即可;漏洞利用请求和成功响应都明确,关联规则或固定剧本即可。
真正需要AI的,是边界不清晰的问题。也就是那些“看起来有风险,但证据不完整”的场景。例如异常外联、可疑登录、脚本执行、横向访问、文件外发、账号行为异常等。这些问题不能只看单点特征,还要结合资产、账号、业务、历史行为、时间窗口和客户风险偏好。
这就形成了AI安全运营的基本矛盾:边界清晰的问题,规则已经足够;边界不清晰的问题,才需要AI,但这部分恰恰最主观、最依赖上下文、最难工程化。
因此,如果只是让LLM输入一条告警,拼接一些上下文,然后输出“是否攻击、攻击类型、判断依据、处置建议”,它并没有改变安全运营的底层逻辑。它只是把人的模糊判断自动化了。
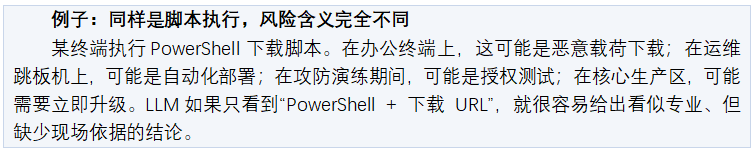
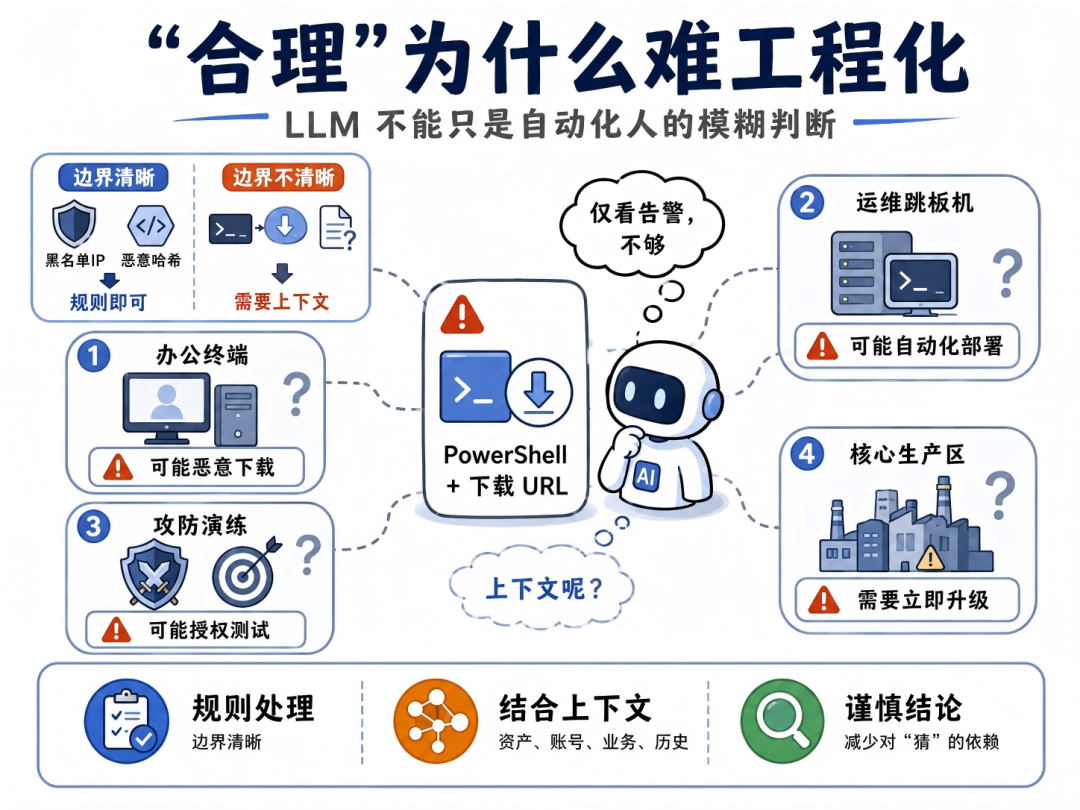
过去是分析师说“我感觉问题不大”。现在变成模型说“综合判断风险较低”。表达更完整,但问题没有消失。信息不完整时,模型说得越流畅,反而越容易掩盖证据不足;判断边界没有定义清楚时,模型也无法稳定知道什么情况下该关闭、什么情况下该升级、什么情况下必须继续调查。
所以,LLM的价值不应是替人继续“猜得合理”。AI安全运营真正要解决的,不是让模型把结论说得更像专家,而是让系统减少对“猜”的依赖。
四、传统运营的妥协:高调查成本,低经验复用
传统安全运营为什么长期停留在“有限条件下的合理推断”?不是因为这种方式最优,而是因为过去没有条件对每一条线索彻底调查。
分析师如果真要查清一条告警,往往要跨多个系统:SOC、EDR、NDR、IAM、CMDB、日志平台、工单系统、业务系统。要查资产、查账号、查进程、查流量、查历史、查处置结果,每一步都需要时间。
更关键的是,即使一条线索被查清,经验也很难完整复用。一个优秀分析师查清一条告警,真正有价值的不是最后一句“误报”或“攻击失败”,而是中间的调查路径、证据组合、判断前提和排除逻辑。
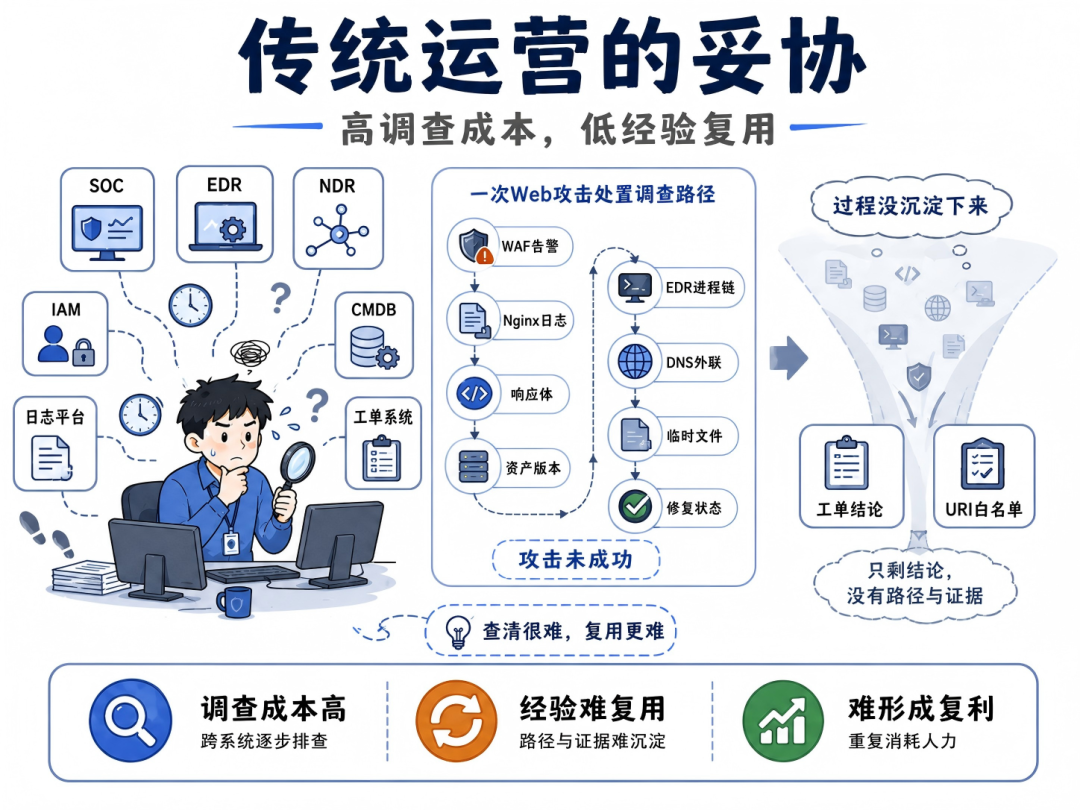
而简单规则很难表达复杂判断。规则太宽,会带来误报;规则太窄,复用率很低;规则过度依赖客户现场,又难以跨环境复制;规则无法表达完整推理过程,后续也难以复盘。
于是,传统运营形成了一个长期困境:调查一条线索的成本很高,但调查结果对未来研判的提升有限;经验很宝贵,但经验很难结构化、自动化、规模化复用。
从这个角度看,传统安全运营的问题不只是“查不清”,更是“查清之后沉淀不下来”。如果调查不能变成可复用资产,安全运营就只能反复消耗人力,而难以形成能力复利。
五、从告警解释到根因追溯:AI安全运营必须获得真实调查权
可信的AI安全运营,不能停留在告警解释。今天很多 AI告警研判,本质上仍然站在告警列表后面做解释。它看到告警字段、规则名称、部分上下文,然后输出一个看起来合理的结论。但它并没有真正进入系统现场,没有足够权限查资产、查身份、查终端、查流量、查业务调用、查变更记录、查处置反馈。
因此,它的结论仍然是有限条件下的合理推断。要让 AI安全运营真正可信,关键不是让模型说得更像专家,而是让AI获得受控的真实调查权。
所谓真实调查权,不是无限制放权,也不是让AI随意操作生产系统,而是在明确权限、审计和边界控制下,让AI能围绕一条线索持续调用运营系统,查清异常发生的上下文。
它要能查资产归属,知道这台机器属于哪个业务、是否核心、是否暴露公网、是否近期变更;要能查账号关系,知道这个账号属于谁、权限是什么、是否共享、是否离职;要能查终端现场,看到进程链、命令行、文件行为、网络连接和计划任务;还要能理解业务链路,知道什么是正常调用、什么是正常运维、什么是正常数据流转。
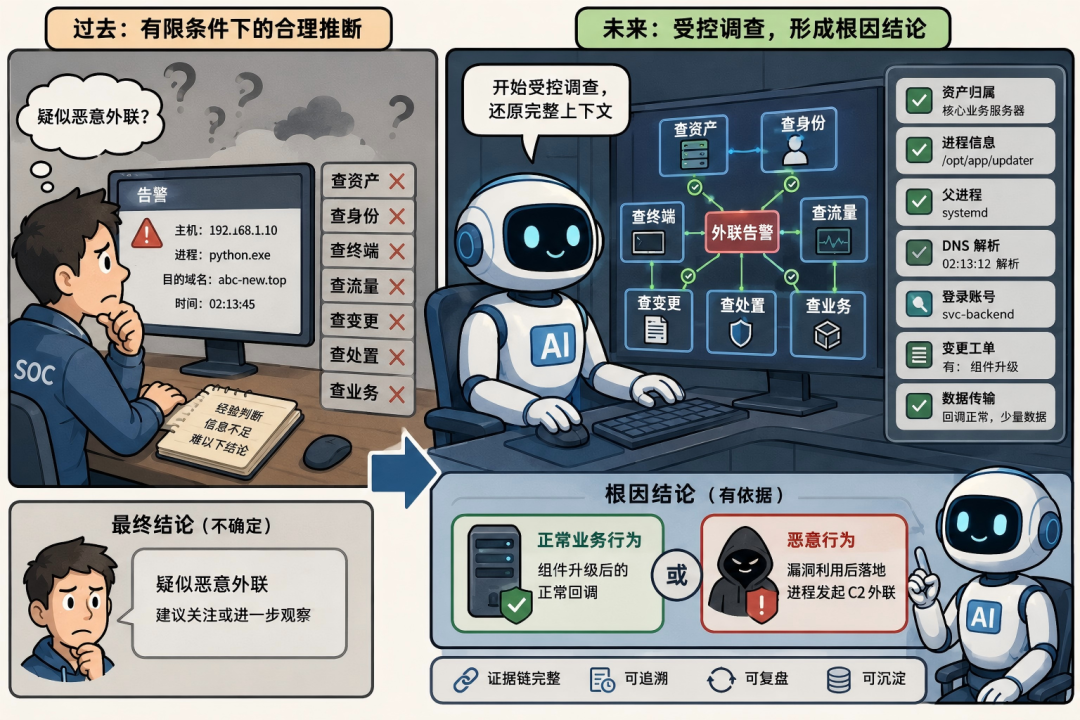
根因分析不是多查几条日志,而是把异常放回系统和业务运行链路中解释。一次异常登录,要追到登录后的命令;一次命令执行,要追到进程和文件;一次外联,要追到访问路径和数据行为;一次横向连接,要追到凭据来源和权限变化。
过去,AI是告警解释器。未来,AI应该成为受控的调查者。过去,AI根据有限输入给出合理推断。未来,AI 应该沿着线索持续追溯,直到形成有依据的根因结论,或者明确说明还缺少哪些关键条件。
安全运营要从系统边缘走向业务现场。只有当AI能够受控进入资产、身份、终端、网络和业务链路,沿着线索持续追溯,安全判断才可能从“有限条件下的合理推断”,走向更有依据的根因结论。现有的AI技术,只有在目标足够清晰的场景下,才能真正发挥其“智能化”的优势。
六、刨根问底之后,新的难题才刚开始
方向清楚,并不意味着问题已经解决。
如果每一条线索都要调查,成本如何控制?哪些告警值得深挖,哪些可以快速关闭,哪些需要挂起观察?基线应该如何构建,是静态画像、动态画像,还是面向账号、资产、网络和业务链路的组合基线?Agent 自主调查又如何防止过度探索、重复查询和资源浪费?
同时,调查过程如何沉淀为可复用知识,也仍然是难题。哪些经验可以跨客户复用,哪些只能在本地生效?哪些可以转化为规则,哪些只能作为判例参考?这些问题不会因为引入大模型而自动消失。
智能安全运营不是简单的模型调用,也不是给 SOC 增加一个 AI 问答入口。它涉及安全工程、数据工程、运营工程、智能体工程和信任工程的系统性重构。
围绕海量线索调查成本、基线构建、自主调查边界、知识自动化沉淀、证据闭合和效果验证等问题,行业还将面对大量具体挑战。绿盟科技将继续立足真实安全运营实践,攻克一个个难题,与客户和行业伙伴共同探索、共同进步。
内容编辑:舒 展
责任编辑:舒 展
参考文献
[1] Stefan Axelsson, “The Base-Rate Fallacy and the Difficulty of Intrusion Detection”, ACM Transactions on Information and System Security, 2000. https://dl.acm.org/doi/10.1145/357830.357849
[2] NIST Special Publication 800-61 Revision 3, “Incident Response Recommendations and Considerations for Cybersecurity Risk Management”, 2025. https://csrc.nist.gov/pubs/sp/800/61/r3/final
[3] MITRE ATT&CK, “Globally-accessible knowledge base of adversary tactics and techniques based on real-world observations”. https://attack.mitre.org/
本公众号原创文章仅代表作者观点,不代表绿盟科技立场。所有原创内容版权均属绿盟科技研究通讯。未经授权,严禁任何媒体以及微信公众号复制、转载、摘编或以其他方式使用,转载须注明来自绿盟科技研究通讯并附上本文链接。
关于我们
绿盟科技研究通讯由绿盟科技创新研究院负责运营,绿盟科技创新研究院是绿盟科技的前沿技术研究部门,包括星云实验室、天枢实验室和孵化中心。团队成员由来自清华、北大、哈工大、中科院、北邮等多所重点院校的博士和硕士组成。
绿盟科技创新研究院作为“中关村科技园区海淀园博士后工作站分站”的重要培养单位之一,与清华大学进行博士后联合培养,科研成果已涵盖各类国家课题项目、国家专利、国家标准、高水平学术论文、出版专业书籍等。
我们持续探索信息安全领域的前沿学术方向,从实践出发,结合公司资源和先进技术,实现概念级的原型系统,进而交付产品线孵化产品并创造巨大的经济价值。
长按上方二维码,即可关注我