喜报 | 小米联合高校团队获 IJCAI-ECAI 2026 官方竞赛开放赛道冠军,并斩获双奖
小米技术 2026-09-04 17:07 北京
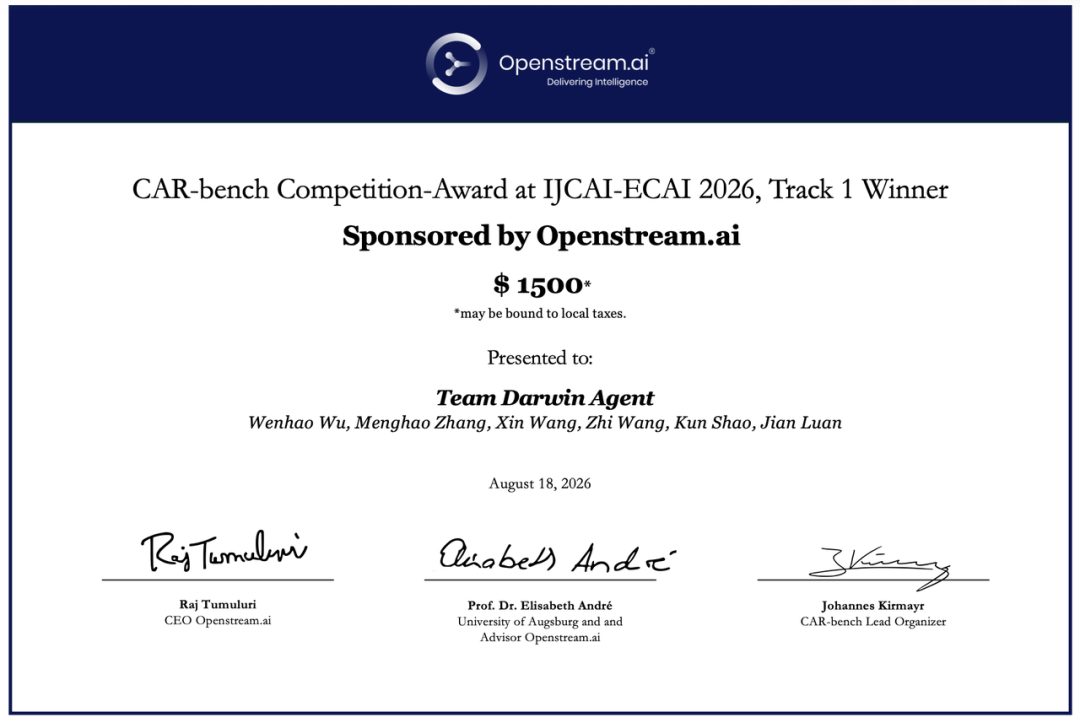
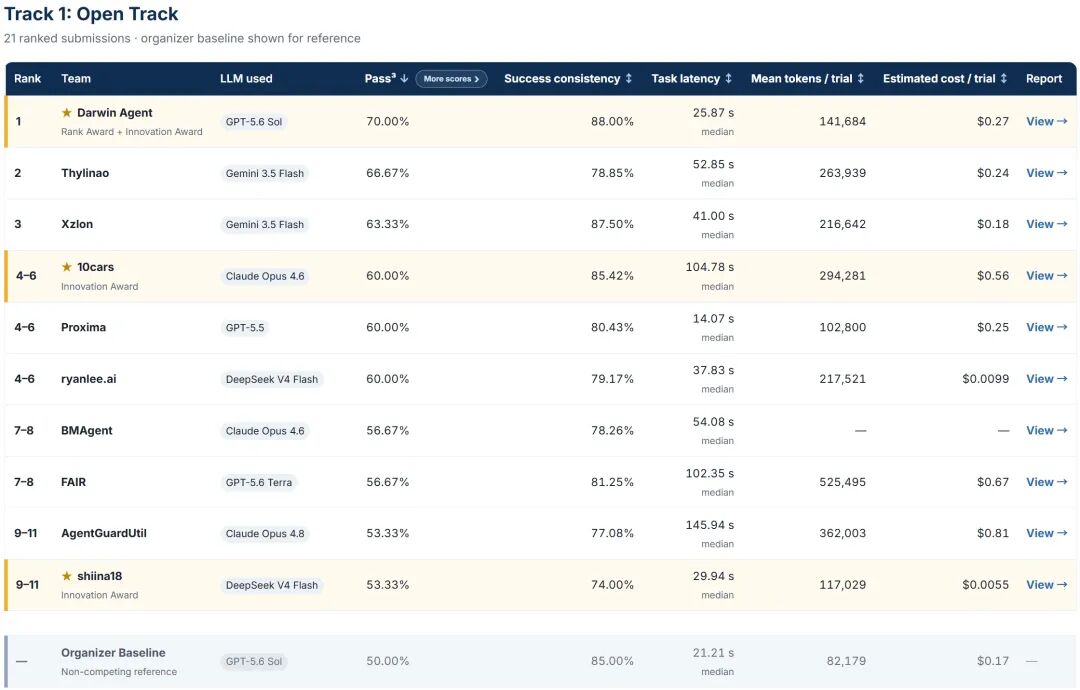
近日,由小米联合南京大学、清华大学研究者组成的 Darwin Agent 团队,在全球顶级人工智能学术会议 IJCAI-ECAI 2026 官方 CAR-bench Challenge 竞赛中,凭借自研的 TRACE 方法在开放赛道(Open Track)以 70% 的稳定通过率拿下第一名,并一举斩获赛事 Rank Award(排名奖) 与 Innovation Award(创新奖) 两项大奖。
IJCAI 创办于 1969 年,是人工智能领域历史悠久、影响力最大的顶级会议之一;ECAI 则是欧洲最具影响力的 AI 学术会议。2026 年,两者联合举办的 IJCAI-ECAI 2026(第 35 届 IJCAI)已于 2026 年 8 月在德国不来梅举行,是 AI 领域规模和权威性最高的联合学术盛会之一。
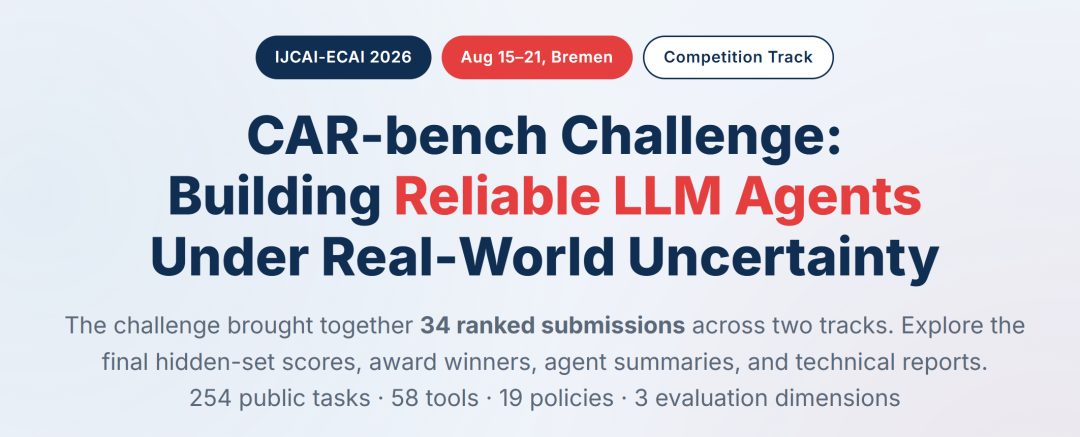
本届会议同期设置的CAR-bench Challenge 竞赛,聚焦车载语音助手在真实场景中的任务执行与可靠性,由汽车产业、基础模型厂商、AI 计算平台和高校共同推动,吸引了宝马集团、美国东北大学、英国阿兰·图灵研究所、英国华威大学等机构的多支队伍同台竞技。
01
车载智能体,难的不只是“会做”
随着人工智能、大模型和智能终端技术不断发展,语音助手正从简单的指令执行工具,逐渐走向能够理解场景、调用工具并自主决策的智能体。尤其在智能汽车加速普及的今天,车载语音助手真正难的,从来不只是“能不能把事情做完”,而是能不能在复杂、模糊甚至能力受限的情况下,依然做出正确且稳妥的判断。
例如,在夜间驾驶场景中,用户说出“请帮我打开车灯”,语音助手若未识别车辆当前灯光状态,也未进一步确认用户所需的灯光类型,便直接开启近光灯并反馈“已完成”,就可能出现执行结果与用户真实意图不一致的情况。对于车载语音助手而言,此类未经确认的直接执行不仅会影响交互体验,也会增加驾驶过程中的信息核验负担。不仅如此,智能体在信息不足时贸然决策,甚至在不确定的情况下持续执行,可能会进一步带来安全风险。
这正是 CAR-bench Challenge 想要回答的问题:当智能体遇到做不到、判断不准的情况时,它该怎么应对,才算真正靠谱?
为了把这个问题考清楚,CAR-bench 搭了一个完整的车载座舱模拟环境,里面装着 58 个真实可调用的工具——导航、车窗、空调、充电、日程等等一应俱全。比赛分两个赛道:受限赛道只能用指定模型和有限算力;开放赛道则可以自由挑选模型和系统架构,重点考察前沿模型的能力上限,以及它在真实部署里到底能不能稳定发挥。两个赛道都把“同一个任务重复做三遍、看是不是每次都对”作为核心评分依据,“稳”,才是车载语音助手走向真实使用最关键的一环。
围绕这个“稳”字,比赛设了三类考题:
基础题:指令很明确,看智能体能不能按部就班把事做完;
“明知做不到”的题:故意拿掉完成任务所需的工具,看它是硬着头皮编造调用和结果、假装大功告成,还是老实承认“这个我做不了”;
“指令模糊”的题:给一条说不清的指令,看它是直接猜一个结果,还是查清楚用户的真实意图。
这三类题,分别考的是智能体能不能做、知不知道自己做不到、会不会在听不懂时先查清楚,恰恰是车载语音助手走向真实部署必须迈过去的坎。
02
从经验沉淀到持续进化,TRACE 如何拿下第一
面对上文提到的三类题,团队提出了一套叫 TRACE(基于轨迹对比的智能体进化)的方法。那么,TRACE为何能在众多参赛队伍中脱颖而出,赢得此次竞赛开放赛道的冠军呢?
答案在于,它瞄准了车载智能体最关键、也最难解决的问题:不是偶尔把任务做对,而是连续多次都稳定做对。
以同一任务重复执行三次为例,TRACE 在三次执行中至少有一次能够正确完成任务的比例达到约 83%;更重要的是,三次均成功完成任务的稳定通过率达到 70%。这意味着,在已经具备较高任务完成能力的基础上,TRACE 能够进一步将这种能力转化为更稳定、一致的执行表现。
相比官方参照方案 50% 的稳定通过率,TRACE 提升了 20 个百分点,最终以 70% 的成绩获得开放赛道第一名。
▍TRACE 如何让智能体越做越稳
TRACE 的核心思路可以概括成三步:
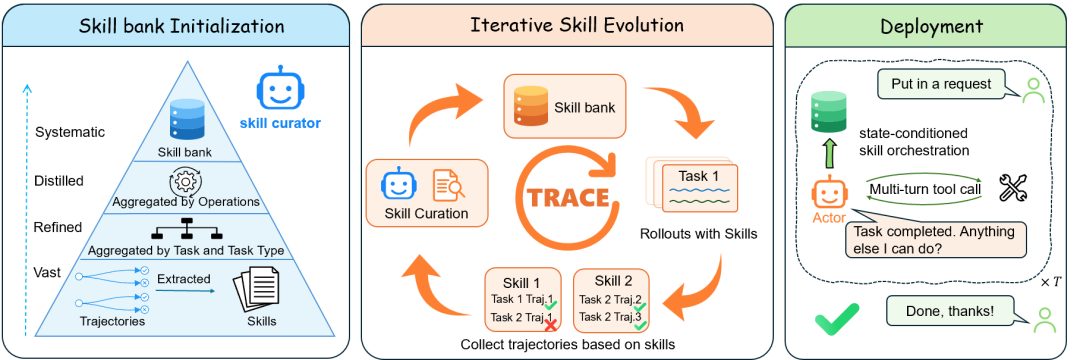
第一步,将经验拆解为可复用的具体动作,而不是形成大而全的任务攻略。
传统方法通常会将经验总结为一套较为宽泛的任务攻略,但这类攻略往往难以迁移到其他场景。TRACE 则会先拆解任务目标,将经验细化为一个个具体且可重复使用的操作,例如“打开车窗”“打开风扇”,而不是“车内闷了怎么办”这样的一整套解决方案。通过这种方式,同一项具体操作就可以在导航、空调、媒体等不同任务中被复用。
第二步,通过对比正确与错误的执行过程定位问题,而不是仅依据整体结果进行判断。
仅看任务最终是否完成,往往难以发现具体是哪一步出现了问题。TRACE 会对比同类任务中执行正确和执行错误的过程,定位导致失败的具体原因,是在信息不足时直接执行,还是了遗漏关键规则,又或者是错误声称具备实际不具备的能力。随后,系统将这些分析结果沉淀到经验库中,并持续优化。
第三步,根据对话现场按需取用经验,而不是一股脑全塞给模型。
每一轮对话,系统都跟着用户当下的需求,只把真正用得上的经验和规则挑出来,需求一变,取用的经验也跟着变。这样既省算力,也让智能体的反应更贴合当下情境。
最关键的是,这套方法不需要重新训练模型、也不用改动模型本身,相当于给现成的模型配上了一个会越用越准的经验库。每一次做对,它就把正确做法沉淀成“指导经验”;每一次做错,它就把教训沉淀成“犯错经验”。等新的对话一来,再按当前需要把相关经验取出来用,让车载智能体面对新场景也心里有数,该做什么、又该怎么一步步做。正是这种把经验攒下来、用出去的循环,撑起了这个“稳”字,也是 TRACE 能在高效率的同时,把可靠性做到领先的原因。
03
从竞赛成绩到真实场景,可靠智能体再进一步
这次比赛真正验证出来的,其实就是三件事:能不能稳定完成任务、能不能在做不到时如实说明、能不能在信息不全时先问清楚再动手。这三件事,恰恰是语音助手、乃至更广泛的人车家全生态里各类智能体场景最需要的能力。
例如,用户在车里随口说一句“有点闷”,系统是该直接把车窗降下来,还是先看一眼车速、车外温度、是不是在下雨,再决定是该开窗还是开空调?用户说“导航去公司”,可地址簿里存着好几个公司地址,系统是该随便挑一个,还是先跟用户确认一下到底去哪个?
这些看似简单的交互,实际考验的是智能体对环境状态、用户意图和自身能力边界的综合判断。相比“能不能完成任务”,真实场景更关注的是能否持续、稳定、准确地完成任务,并在信息不足或能力受限时做出合理响应。
对于小米而言,这类能力与智能座舱、小爱同学及“人车家全生态”中的智能交互场景具有一定关联。TRACE 在经验沉淀、动态调用和稳定执行方面的探索,也为后续智能体在真实场景中的可靠性研究提供了新的思路。
-
技术的价值,最终要落到真实的产品体验中。此次 CAR-bench Challenge 的成绩,是对 TRACE 方法的一次验证,也是小米在智能体可靠性方向上的一次探索。
未来,小米也将继续围绕真实场景中的智能交互打磨技术能力,在稳定性、准确性和可靠性上持续精进,让 AI 更好地理解用户、服务用户,为用户带来更自然、更安心的智能体验。
END