让 AI Agent 跑得更快:Memfit 速度优化
原创 Yakit 2026-08-21 17:00 四川
四个方向,同一件事:做减法
一、背景:Agent 到底慢在哪
Memfit①的递归式双引擎架构中,ReAct 循环是核心执行单元。Plan-Execute 负责拆解目标,ReAct 负责逐个执行——而每一轮 ReAct 迭代,都要经历以下几个步骤:
注①:Memfit是万径安全旗下Yaklang 研发的面向长程渗透测试、漏洞挖掘、应急响应等全链路攻防任务的生产级安全领域Agent系统。
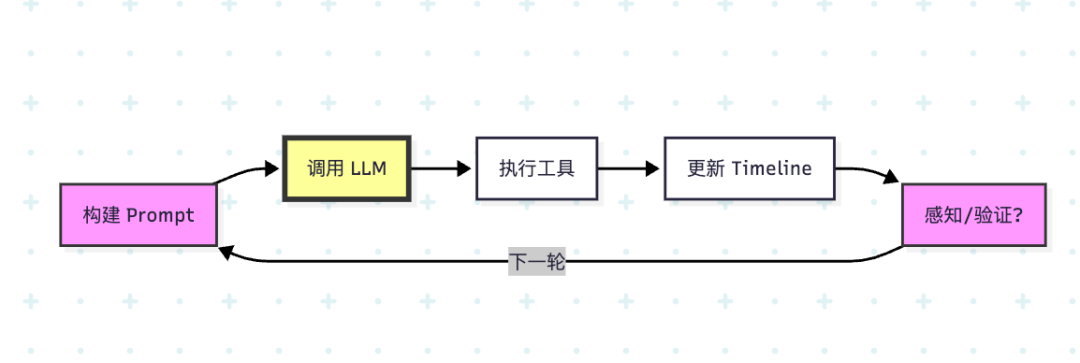
构建 Prompt:拼装 frozen/semi-dynamic/dynamic 各段,做 token 统计、observation 构建——这块有 ~235ms 的纯计算耗时
调用 LLM:最贵的一步,每次都是一次网络往返 + 推理,延迟在秒级
执行工具:HTTP 请求、文件读取、端口扫描等 I/O 操作
感知/验证:可能额外触发 1-2 次 LLM 调用(感知 AI call + 验证 AI call)
一个典型的安全测试任务会跑 10-20 轮这样的迭代。乍一看,最显眼的瓶颈当然是"调用 LLM"——延迟在秒级,又是按 token 计费,自然觉得优化这里收益最大。但真正排查下来,发现情况没那么简单。
二、单轮墙钟时间:Observation 异步化
回头看 ReAct 循环的四个步骤——构建 Prompt、调用 LLM、执行工具、感知/验证——每一步都可能有性能问题。我们先从"构建 Prompt"这一步开始。
顺着 generateLoopPrompt 的代码读下来,发现每轮 prompt 拼装完之后还有一段 observation 逻辑,稳定占用 ~235ms。这个开销不是偶发的,而是每轮迭代都在。
把 generateLoopPrompt 的调用链展开,这 235ms 花在了这里:
BuildPromptObservation → 遍历所有 prompt section,统计 bytes/tokens/linesBuildStatus → 构建 UI 面板用的状态对象emitPromptObservation → 推送给前端的 prompt profile 面板ytoken.CalcTokenCount → 完整的 Qwen BPE 编码,逐段算精确 token 数contentHash8 → 对每个 section 做 sha1 取前 8 字节
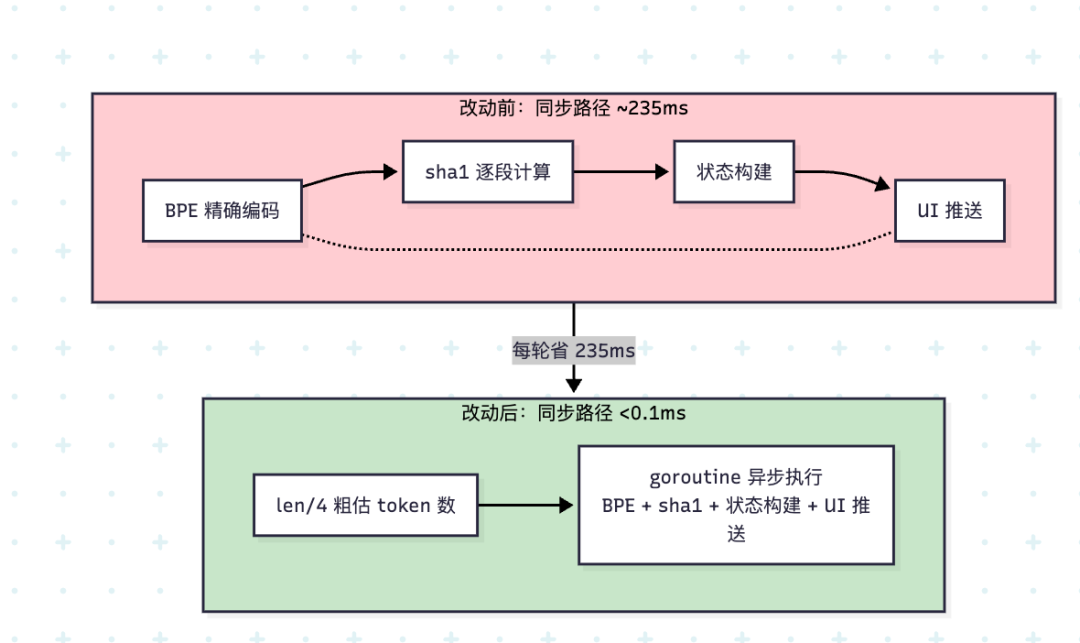
这看起来都是必要的工作——token 统计、状态构建、UI 推送。但仔细一看,这整套计算只服务于 UI 的 prompt profile 面板。Agent 真正调 LLM 用的是拼装好的 result.Prompt 字符串,跟 observation 没有关系。235ms 是纯给前端看的。
问题就清楚了。唯一真正卡在同步路径上的,是 verification gate(验证门)要用的 prompt token 数——验证门靠它判断"上下文涨了多少 token,要不要触发验证"。但验证门的阈值在 10K/20K 量级,这种粗粒度根本不需要 BPE 精确编码,len/4 就够了:
// 改动前:完整 BPE 编码,~235ms_promptTokens := estimateTokenCount(result.Prompt)// 改动后:len/4 粗估,<0.1ms// verification gate 的 token 门阈值为 10K/20K 量级,粗估 len/4 即可_promptTokens := len(result.Prompt) / 4r.SetLastPromptToken(_promptTokens)
同步只留这行 len/4,完整的 observation 构建全部交给一个 fire-and-forget goroutine:
r.observationInflight.Add(1)go func() {defer r.observationInflight.Done()defer func() {if rec := recover(); rec != nil {log.Warnf("async observation build panic recovered: %v", rec)}}()observation := BuildPromptObservation(_loopName, _nonce, _promptCopy, _asyncSections)status := observation.BuildStatus(0)r.SetLastPromptObservation(observation)r.SetLastPromptObservationStatus(status)if _emitter != nil {_emitter.EmitPromptProfile(status)}}()
另外还发现一个细节:contentHash8 会对每个 prompt section 做 sha1,同一 section 内容跨迭代不变,但之前每轮都重算。加了一个 512 entry 的 LRU cache:
funccachedContentHash8(content string) string {contentHash8CacheMu.RLock()if h, ok := contentHash8Cache[content]; ok {contentHash8CacheMu.RUnlock()return h}contentHash8CacheMu.RUnlock()h := contentHash8(content)contentHash8CacheMu.Lock()if len(contentHash8Cache) > 512 {contentHash8Cache = map[string]string{} // 超过 512 条直接清空,简单粗暴}contentHash8Cache[content] = hcontentHash8CacheMu.Unlock()return h}
改完之后,每轮迭代的同步路径减少 ~235ms。一个跑 20 轮的任务,光这一项就省了将近 5 秒。而 UI 面板最多延迟几百毫秒看到 observation 数据——用户完全感知不到。
三、LLM 调用次数:移除无用调用与降频(-57%)
单轮的墙钟时间优化之后,注意力自然转向第二个步骤——"调用 LLM"。这一步本身是必要的,每轮的主循环决策必须经过 LLM。但问题在于,主循环之外还设计了不少"附加 LLM 调用":感知、验证、记忆 triage、意图识别。这些机制在各自的场景下都有价值,但随着系统演进,有些调用的触发频率偏高,有些的结果已经不再被下游消费。10 轮迭代里额外跑 5-7 次附加调用,累积起来开销不小。
于是我们逐个审视这些附加调用:触发频率是否还匹配当前场景?有没有更轻量的替代方案?能不能延后到真正需要时再触发?
YAK
3.1 isDone 时的 SearchMemory:结果已无人消费
先看到的是任务完成(isDone)时的 SearchMemory 调用。这个机制最初设计时,意图是在任务收尾时检索一下相关记忆,供后续场景参考:
if isDone && !task.IsAsyncMode() {searchResult, err := r.memoryTriage.SearchMemory(task.GetUserInput(), 4096)// ...if len(searchResult.Memories) > 0 {log.Infof("found %d relevant memories for completed task %s (total: %d tokens)",len(searchResult.Memories), task.GetId(), searchResult.ContentTokens)}}
但随着系统演进,这个调用的结果已经不再被任何下游逻辑消费——只写了一行 log。保留它意味着每次任务完成都多一次 G3 tag-selection LLM 调用。移除之后,行为无变化,零副作用。
YAK
3.2 记忆 flush 间隔:3→6,攒够了再处理
顺着记忆系统继续看,MemoryFlushBuffer 负责攒够一定量再触发 HandleMemory(含 G1 memory-triage LLM 调用)。原来的阈值是每 3 轮迭代 flush 一次,在早期任务规模较小时是合理的:
// 改动前:每 3 轮就 flush 一次MaxPendingIterations: 3,// 改动后:每 6 轮才 flush 一次// 记忆写入仍异步不阻塞主循环,task done 时仍会 flush 不会丢失记忆MaxPendingIterations: 6,
但任务变长后,3 轮一次的频率偏密:一个 10 轮任务会产生 iter 3/6/9 + done = 4 次 flush。调整为 6 轮一次后降到 2 次(iter 6 + done)。记忆写入是异步 fire-and-forget,延迟 flush 不阻塞主循环,任务结束时还会强制 flush,不会丢数据。
YAK
3.3 感知和验证:频率瘦身
前两项是比较直接的裁剪。感知和验证这两个机制本身都有价值——感知负责检测意图漂移、验证负责沉淀证据——但它们的触发频率在早期设得偏高,在任务变长后累积成了主要的附加开销。
Agent 每做一次 action 后,可能触发一次"意图感知"AI call。早期设计了三个触发入口:post_action、afterVerification、SPIN,最小间隔 120s,每 4 轮 iter 就可能触发一次。这在短任务里感知灵敏是好事,但任务变长后频次过高:
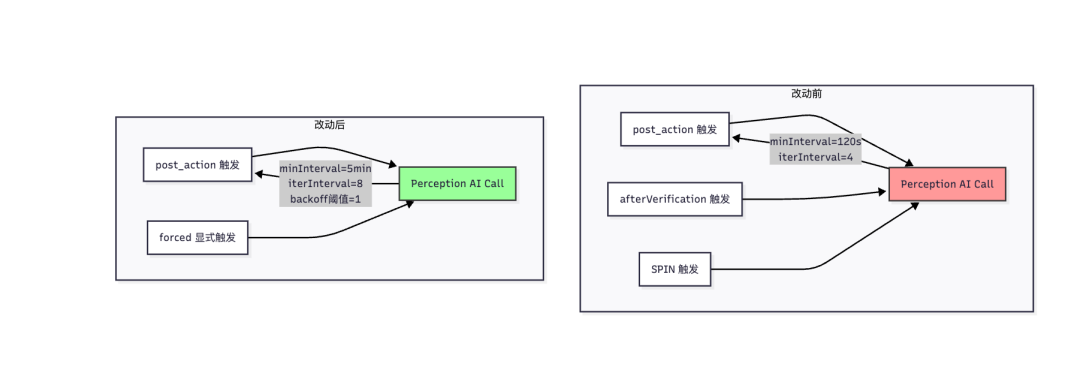
我们对触发入口做了裁剪:afterVerification 触发源移除——验证本身已经是对结果的判定了,再触发一次感知信息重叠较多。同时把间隔拉长:最小间隔 120s→5min,最大间隔 5min→15min,迭代间隔 4→8,指数退避阈值 2→1(首次无变化就翻倍,更快爬到上限)。
验证机制的频率也做了类似调整。Agent 会定期触发"用户满意度验证"AI call,早期几乎每 6-7 轮就触发一次,在短任务里能及时收尾,但任务变长后打断过于频繁。我们把阈值逐个调高:
参数 | 改动前 | 改动后 | 说明 |
时间门 | 180s | 1800s(30min) | 距上次验证多久才强制再跑 |
iter 门 | 6 | 20 | 每 N 轮才触发 |
首次触发 | 3 轮 | 10 轮 | 不再过早触发 |
软 token 门 | 1500 | 10K | 上下文增长多少才触发 |
硬 token 门 | 5000 | 20K | 超大增长才豁免冷静期 |
验证的定位也做了调整:从"高频满意度判定"转为"evidence 沉淀",由 Agent 主循环通过 save_evidence action 主动沉淀证据,自动验证仅作最终兜底,不需要高频打断。
YAK
3.4 意图识别:从多轮 ReAct 精简为单次 AI call
最后看的是意图识别。早期设计时,意图识别本身也是一个完整的 ReAct 子循环——query_capabilities → finalize_enrichment + LiteForge fallback,可能跑好几轮迭代。这在初期能力丰富、匹配逻辑复杂时是合理的,但随着搜索机制成熟,可以用更轻量的方式替代:
改造后变成一个纯 init 流程:
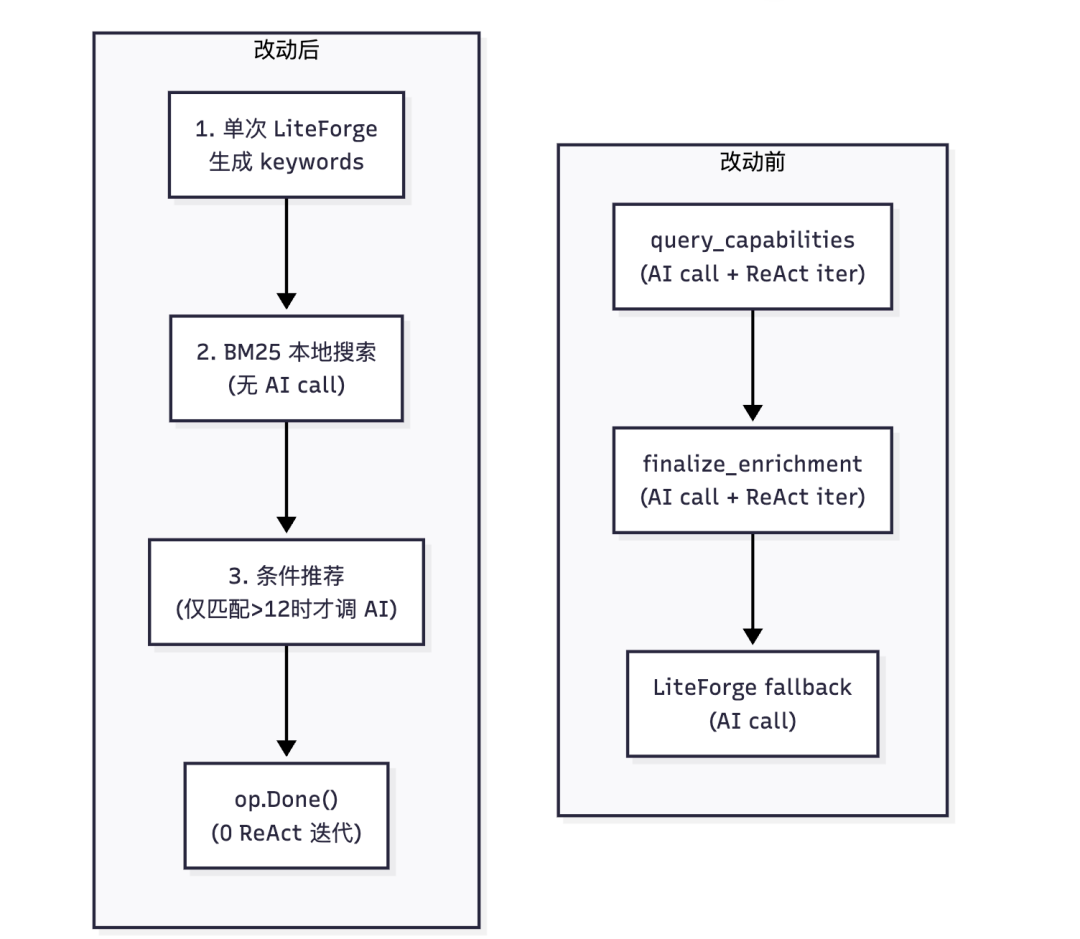
BM25 搜索是纯本地计算,不调 LLM。只有匹配结果超过 12 条时才触发第二次 AI call 做推荐。简单场景一次 AI call 就够了。
YAK
3.5 效果汇总
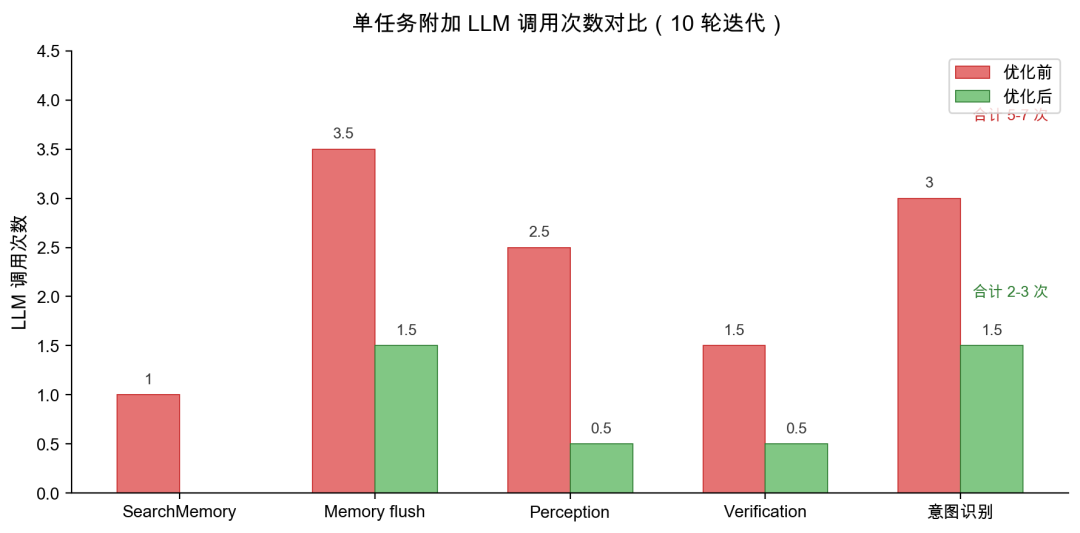
一个 10 轮迭代的单任务,额外的 LLM 调用从 5-7 次降到 2-3 次,减少 57%。
LLM 调用来源 | 改动前 | 改动后 |
isDone SearchMemory | 1 次 | 0 次 |
Memory flush (G1 triage) | 3-4 次 | 1-2 次 |
Perception | 2-3 次 | 0-1 次 |
Verification | 1-2 次 | 0-1 次 |
意图识别 | 2-4 次 | 1-2 次 |
合计 | 5-7 次 | 2-3 次 |
四、迭代预算:有效迭代次数重定义
单轮耗时和 LLM 调用次数都优化了,但还有一个不太显眼的问题:Agent 有时候并没有"慢",而是被迭代上限提前截断了——明明还在推进任务,却因为"轮次用完了"而退出。
这个问题的根源在于,迭代上限的计数方式有问题。
YAK
4.1 每一轮都算数,公平吗
原来的逻辑很简单:主循环每跑一圈,iterationCount 加一,到了 maxIterations 就停。这听起来合理,但实际跑起来会发现一个问题——不是每一轮都在推进任务。
Agent 在执行过程中会出现"空转轮":AI 调了一个工具但没改动任何 TODO,或者向用户请求了一次澄清但没有产生新的行动。这些轮次消耗了一次迭代预算,但实际上什么也没推进。
举个具体的例子:Agent 有 3 个 TODO 要完成,maxIterations 设为 20。前 5 轮顺利完成了第一个 TODO,但第 6 轮 AI 调了一个工具发现需要更多信息,第 7 轮请求用户澄清,第 8 轮根据回复重新调了工具——这 3 轮都是空转,没动任何 TODO,但 iterationCount 已经涨到了 8。如果类似的情况多出现几次,Agent 可能在完成 2 个 TODO 后就因为"轮次用完"退出,第三个 TODO 没机会做。
这本质上是把"思考次数"和"推进次数"混为一谈了。
YAK
4.2 什么算"有效推进"
我们引入了一个新的计数器 effectiveIterationCount,和原始的 iterationCount 并行运行。判定标准很简单:
func(r *ReActLoop) advanceEffectiveIteration(task aicommon.AIStatefulTask, delta *aicommon.TodoDelta) {scope := aicommon.BuildVerificationTodoScope(task)hasActiveTodo := falseif r.config != nil {active := r.config.ActiveVerificationTodoItemsByScope(scope)hasActiveTodo = len(active) > 0}progressed := delta != nil && delta.HasChanges()if !hasActiveTodo || progressed {r.effectiveIterationCount++}}
一轮算不算有效,取决于两个条件:
1.本轮的 action 携带了 todo_delta 且有实际变更(新增、完成或切换了 TODO)→ 有效
2.当前没有活跃的 TODO(处于规划或侦察阶段,还没有拆解出具体任务)→ 有效
反过来,如果当前有活跃的 TODO 但本轮没有 todo_delta 变更,这就是一个空转轮——不计入 effectiveIterationCount。
YAK
4.3 只改判断标准,不改其他逻辑
一个重要的细节是:原始的 iterationCount 并没有被删除。它仍然用于 prompt 构建、goal-mode 门控、timeline、心跳等所有需要"第几轮"信息的地方。改动只影响迭代上限的判断:
// 改动前:原始循环圈数if iterationCount > maxIterations {// 到达上限,退出}// 改动后:有效推进轮数if r.effectiveIterationCount > maxIterations {// 到达上限,退出}
这样空转轮不再消耗迭代预算。同样是 maxIterations=20,现在 Agent 可以经历 30 轮甚至 40 轮的循环,只要其中有 20 轮是真正推进了 TODO 的,就不会被提前截断。
YAK
4.4 效果
这个改动的影响不是"快了多少毫秒",而是"能不能完成任务"。之前可能跑 20 轮就因为空转耗尽预算而退出,现在同样的预算能覆盖更多的实际工作量。对于需要频繁试探、澄清、重试的安全测试场景,这意味着 Agent 不会在中途因为"轮次用完"而放弃未完成的任务。
五、主循环轮次:Action 数组并发工具调用
前面三块分别优化了构建 Prompt、调用 LLM 和迭代预算,但回头看"执行工具"这一步,还有一个更根本的效率瓶颈——不是算得慢,不是调得多了,而是明明可以一次做完的事,非要拆成好几轮。
ReAct Agent 原来的规则是:一轮迭代输出一个 Action,一个 Action 只表达一个工具调用。这意味着即使 AI 已经明确知道要读 3 个互不相关的文件,也必须串行跑 3 轮:
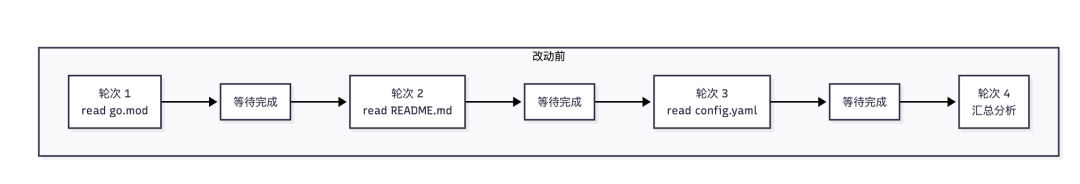
这带来四类成本:用户等待时间变长(独立 I/O 被人为串行化)、模型调用次数增加(每个工具之间都多一次主循环决策)、上下文噪声增加(每轮都要重新携带完整 Prompt 和 Timeline)、业务吞吐下降(文件读取、独立搜索无法利用天然并行性)。
YAK
5.1 让一个 Action 承载多个独立调用
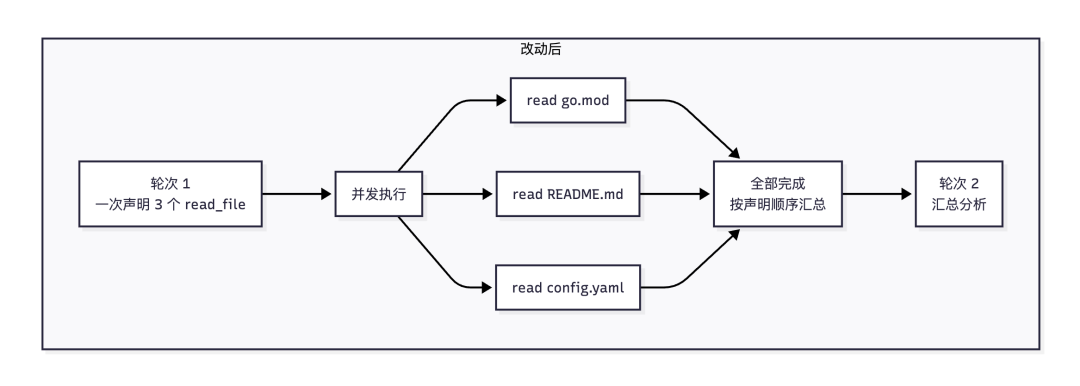
核心改动:在原有 Action 协议上增加数组字段 directly_call_tool_calls(参数已知)和 tool_require_calls(参数待生成),让 AI 在一轮里声明 2-8 个独立调用,运行时真正并发执行。
{"@action": "directly_call_tool","identifier": "parallel_project_reads","directly_call_tool_calls": [{"tool_name": "read_file","params": {"path": "/workspace/go.mod"},"identifier": "read_go_mod"},{"tool_name": "read_file","params": {"path": "/workspace/README.md"},"identifier": "read_readme"}]}
改造后的流程:
YAK
5.2 并发执行的内部机制
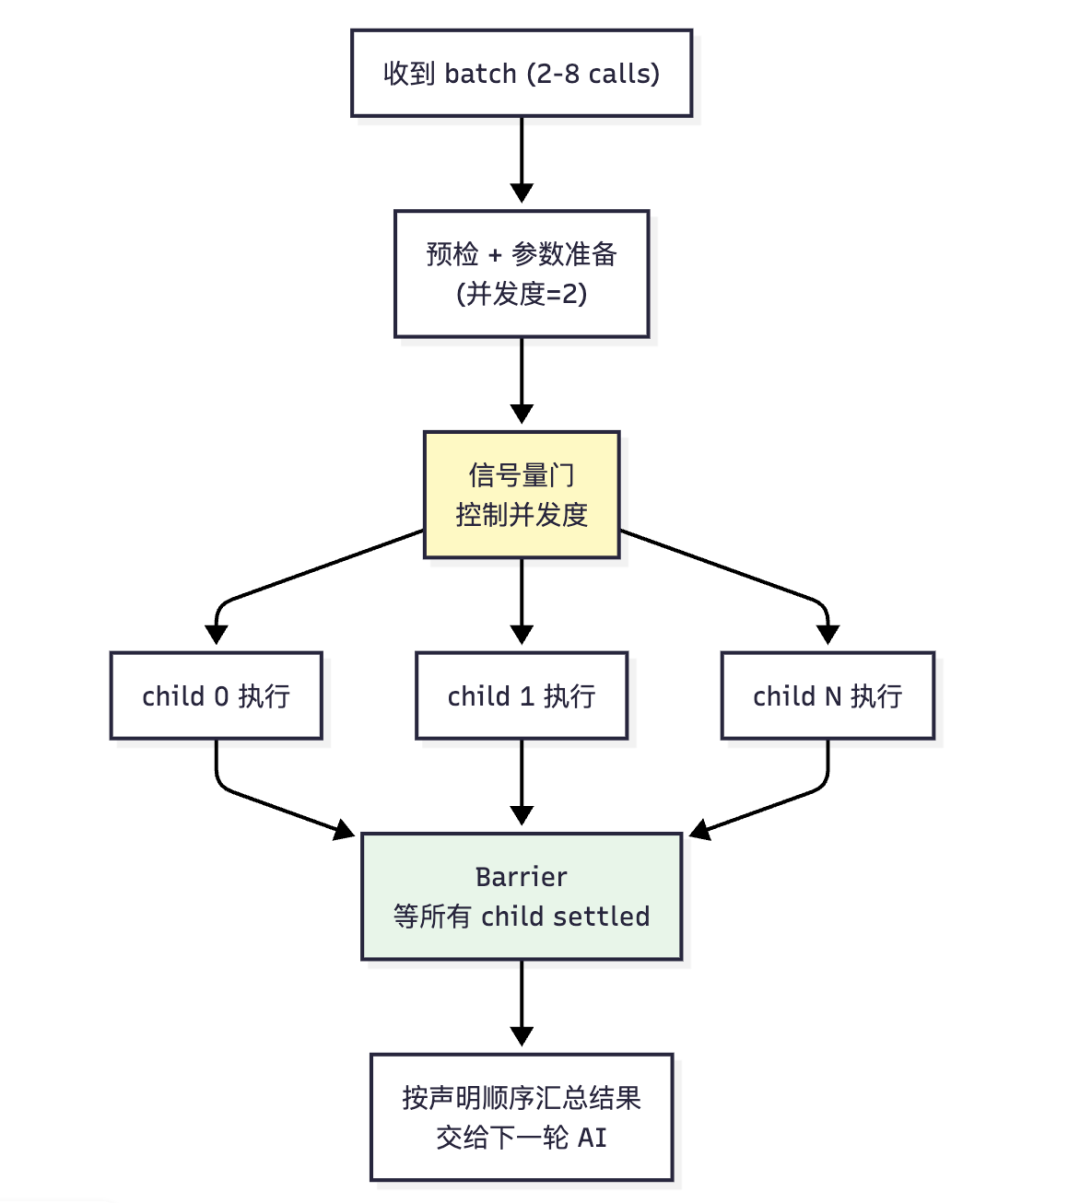
运行时收到一个 batch 后,为每个 child call 创建独立的 ToolCaller 管线,通过信号量门(semaphore gate)控制并发度,用 barrier 保证所有 child 都 settled 后才进入下一轮:
YAK
5.3 对速度的影响
这个改动对速度的影响是多层面的:
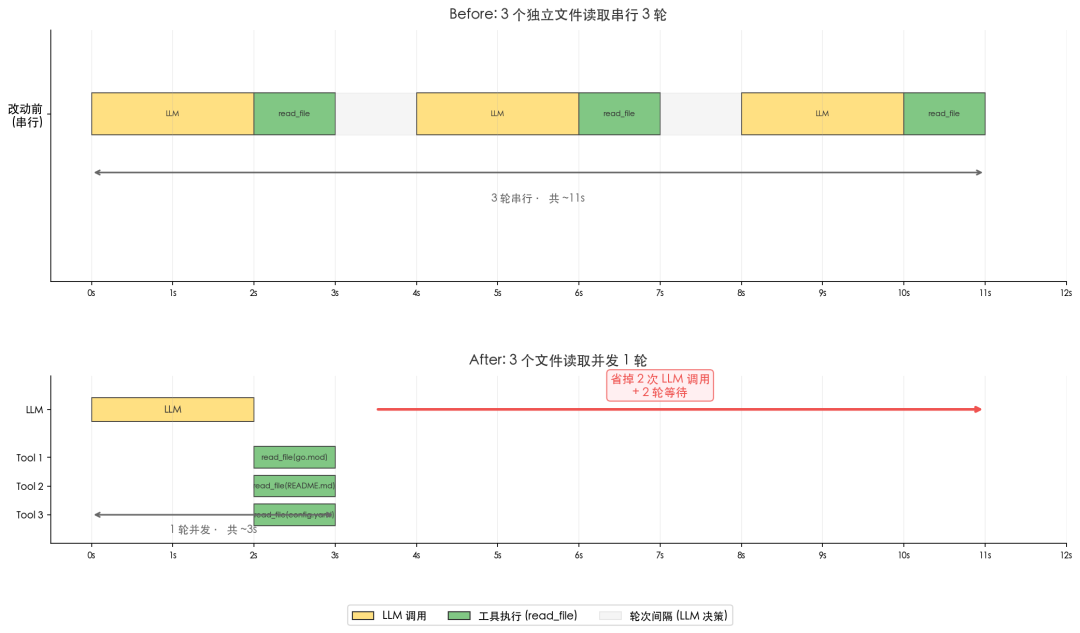
1.减少主循环轮次:3 个独立读取从 3 轮变 1 轮,少 2 次 LLM call + 2 次 prompt 构建
2. I/O 并行:3 个文件读取同时进行,墙钟时间从 3 倍变 1 倍
3.上下文更紧凑:少 2 轮中间结果进 Timeline,后续每轮 prompt 更短
4.减少后续开销:少几轮迭代意味着少几次 prompt 构建和 LLM 调用
Prompt 层面也做了配套:frozen-block 段的工具调用模式说明里增加了并发批次的决策指导,教 AI "已有 2-8 个无依赖调用时优先走并发批次,不得仅为沿用单工具而拆成多轮"。
六、四个优化的关系
这四个优化分别作用于 Agent 运行的不同环节,但彼此有协同:
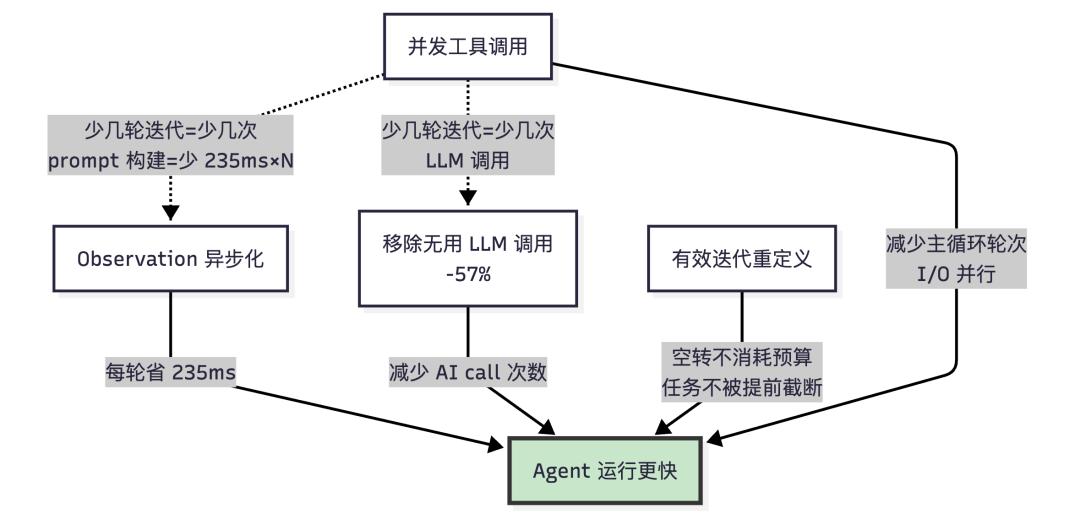
Observation 异步化解决的是单轮的墙钟时间——把不参与 AI 调用的计算挪到异步
移除无用调用与降频解决的是 LLM 调用次数——移除无用的、降低高频的
有效迭代重定义解决的是迭代预算——空转轮不计入有效迭代,Agent 不会因为试错和澄清消耗掉全部预算
并发工具调用解决的是主循环轮次——该并行的并行,不为独立操作浪费轮次
并发工具调用会同时放大前两个优化的效果:更少的轮次意味着更少的 prompt 构建(Observation 异步化省的 235ms×N)、更少的 LLM 调用(降频省的调用次数×N)。这是做性能优化时常见的现象——你以为是在优化一个点,实际打通了几条线的联动。
七、写在最后
做 Agent 性能优化和做传统软件性能优化不太一样。传统优化看的是 CPU Profile、内存分配、锁竞争;Agent 优化看的是 LLM 调用次数、prompt 稳定性、token 预算、I/O 并行度。最大的开销不在机器侧,而在模型侧。
这篇文章里的四个方向的优化,没有一个是什么高深的算法。它们的核心都是同一件事:搞清楚什么东西是真正需要的,然后去掉不需要的。
observation 不参与 AI 调用?异步。
SearchMemory 结果没人用?删掉。
空转轮和推进轮平等计费?分开计数。
3个独立读取非要串行3轮?让它并行。
END
YAK官方资源
Yakit官网下载地址:
Github地址:
https://github.com/yaklang/yakit
Yakit 视频教程:
https://space.bilibili.com/437503777
Memfit下载地址:
IRify下载地址: