蚂蚁灵波开源1.3B世界模型,⼀张消费级显卡,也能实时⽣成⼀个世界
原创 夕小瑶编辑部 2026-09-10 11:25 北京
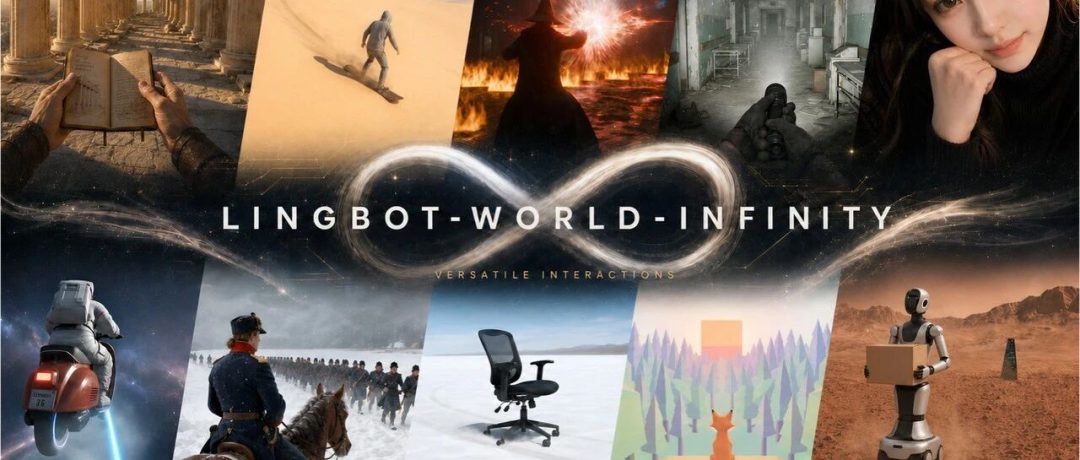
家人们,我最近看到一个AI玩法,第一反应是:这个得拉个朋友一起玩得老好玩了!
两个人控制同一个场景,一个负责往前探索,另一个负责安排接下来发生什么。人在走廊里走,怪物就被安排上了。
一个当玩家,一个当导演,AI根据两个人的操作,把接下来的画面实时生成出来。
你一边探索,朋友一边加剧情,眼前的世界就这样不断往下生成。
最让我心动的是,玩到一半,还能临时改主意。
看见一条小巷,就想拐进去看看;觉得晴天没意思,就试着让场景里下场雪。你随时提出新想法,AI接着当前的场景往下生成。
这种一边接收操作、一边生成后续画面的能力,就是今天要聊的世界模型在探索的方向。
世界模型这个概念,并不是最近才冒出来的。
2018年,David Ha和Jürgen Schmidhuber的《World Models》就是一项代表性研究:让智能体学习环境如何变化,再到模型模拟的环境里练习。
这几年,李飞飞联合创办的World Labs在探索空间智能,Google DeepMind也推出了可以实时交互的Genie 3。
路线各有侧重,但是基本上都是尝试让AI更好地理解、生成和模拟世界。
但心动归心动,我马上想到一个现实问题:
毕竟,如果打开后,发现入场玩家必须先凑一套多卡服务器,那我的参与方式还是:点开视频,全屏观看。。。和传统的生成视频没有什么本质的区别。
今天,我刷到蚂蚁灵波给自己做模型LingBot-World 2.0做了一波更新,重点之一就是开源了面向消费级单卡GPU的1.3B小模型。
现在,一张消费级显卡,也能实时⽣成⼀个可交互世界了。
我对世界交互模型一直都兴致满满,在正式进入技术分析之前,我们先来看看它生成的世界,有什么值得玩。
先看这段巫师施法的官方演示。
第一眼:挺炫。
再看一遍,我注意到的是,巫师施法的时候,周围环境也在跟着变化。
巫师抬手、转身,释放不同的魔法;绿色魔法出现时,附近的雾气和路面也会染上绿色。
这就需要把人物动作、魔法效果和环境光影一起联动、配合处理,让人觉得这道魔法确实发生在这条街上。
而且,可以看到镜头移动的过程,商店、路面和楼体随着视角展开,巫师仍然处在这条街道里。至少在这段展示中,没有每放一次技能,就顺手把背景也换了。。。
用户不断加动作,模型还得照顾前面已经生成的内容。
再看另一段滑翔伞的。
随着视角转动,你会看向山坡、天空,也会俯视下面的村落。
这段没有施法那么热闹,但很适合看空间感。
近处的双腿和绳索、下面的山坡、远处的雪山,都是参照物。镜头一动,它们之间的相对位置也得合理变化。
如果只是把整张风景图左右平移,或者近景和远景各动各的,就很容易露馅。
在这段演示中,身体和装备持续提供着第一人称参照,外面的景观则随着视角展开。所以会有一种“我还坐在这里,只是在看向不同方向”的感觉。
我最近看了电影《奥德赛》特别沉迷,我试了一个特洛伊木马场景:
画面在变,但得整体的空间的延续性和丝滑的场景衔接,让我感觉像自己真的在这个场景里往前走。
只要试过一个场景,就会想继续折腾。这也是本轮小模型开源最实际的意义:让更多人有条件自己跑、自己改、自己验证。
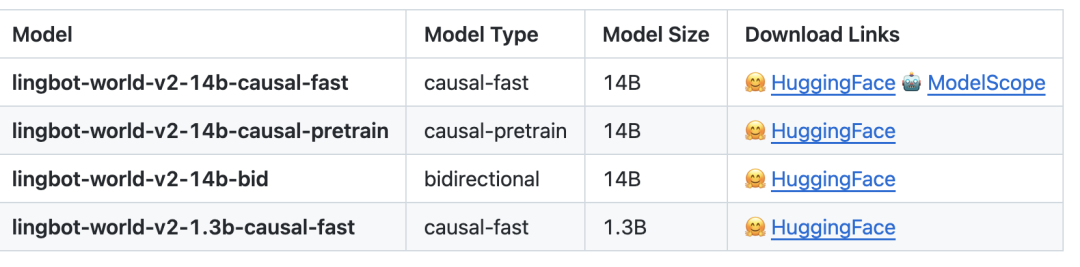
我看了下官方的材料:相比此前的14B主模型,这次开源的1.3B版本面向消费级单卡GPU,支持本地实时生成。
以前,体验这类世界模型往往依靠公开视频、在线Demo,能试哪些操作、能运行多久、能调整什么,往往取决于展示和产品开放了哪些功能。
现在,终于有机会先在本地跑起来,模型到了自己手里,就有机会自己出题、自己验证了。
这给了很多小型团队、个人开发者、高校使带来机会,让更多人先进入实验过程。
如果是个人开发者,可以先改交互:比如,给镜头控制加上手柄操作,看看哪一种更顺手。模型负责生成,开发者围绕它设计玩法。
高校实验室可以把它用作研究工具,反馈延迟多大时,用户会觉得不跟手?文字和按键分别适合什么操作?场景偶尔出现不合理变化,会怎样影响用户的判断?
这些研究需要控制实验条件、记录输入和输出,也需要反复修改界面。本地部署让这些工作更容易展开。
如果是小团队,则可以先做应用原型。
比如互动展览,观众走到某个位置,或者作出一个选择,画面就继续生成。先做一个短流程,看看观众能不能理解操作、愿不愿意继续探索,再考虑扩展内容。
而参与者变多以后,开源的作用才会继续显现。世界模型等了很久的LLaMA时刻,可能要来了。
当然,虽然消费级单卡能实时生成,具体画质还得看算力和配置。
我也试了下1.3B版本的单卡效果:
镜头移动时,场景能跟着变化,但清晰度和高配版相比,还是能看出差距。
此外,这次还同步开源了可以用于后续训练的Causal Pretrain和 Bidirectional :
Causal Pretrain可以支持后续训练和场景适配,给想深入研究的人提供了训练基础。
Bidirectional 可以用来蒸馏,帮助研究者用更少的计算保留生成效果。
这两项工作虽然还需要数据和算力,但有了已有模型作为巨人肩膀的起点,就不必全部从头做起。
传送门:
官网:
https://technology.robbyant.com/lingbot-world-v2
模型:
https://huggingface.co/collections/robbyant/lingbot-world-v2
代码:
https://github.com/robbyant/lingbot-world-v2
论文:
那它是怎么接住操作、保持画面稳定,又把生成速度提上来的?咱们接着看论文。
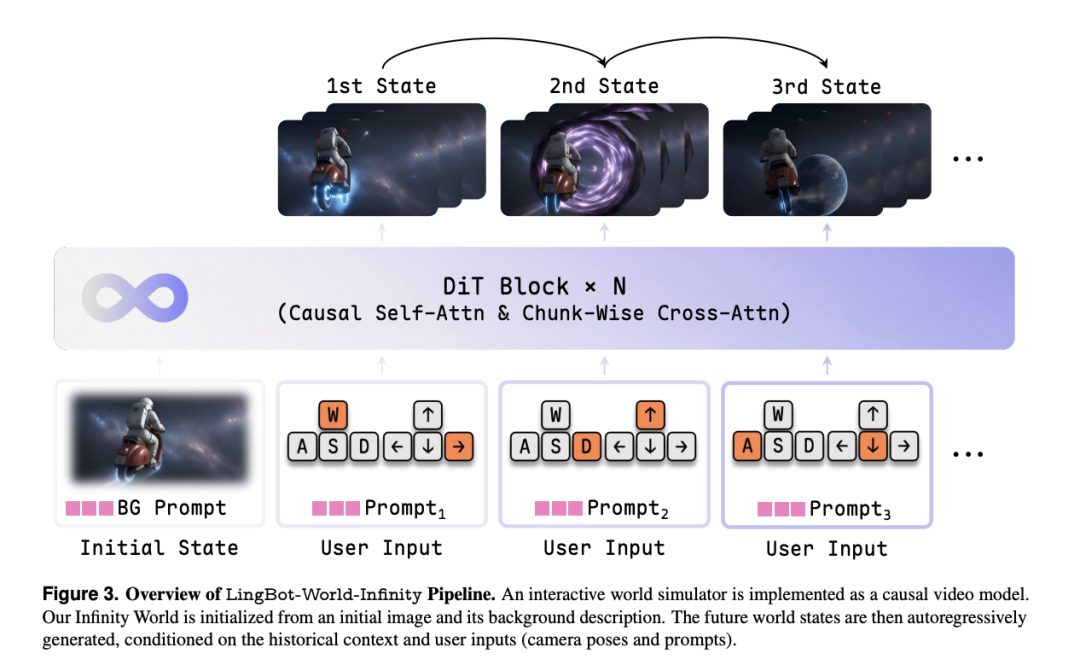
我翻了一下论文,它接收的控制信息主要有两类:相机位姿和文本指令。
传送门:
相机位姿,就是告诉模型“从哪里看、朝哪里看”。
论文用Plücker编码,把每个像素对应的观察射线表示成六维坐标,再通过自适应层归一化,也就是AdaLN,调整生成网络内部的特征,让画面生成参考这些空间信息。
对应到滑翔伞那段,就是你转动视角,模型得根据新的观察方向,补出接下来的景物。
文本指令,负责告诉模型“接下来发生什么”。
它给不同的视频片段配置对应的提示词,再通过交叉注意力,把文字要求和正在生成的画面联系起来。
比如前一段还在正常走路,下一段才要求施法,动作就应该在对应的位置出现。这样,剧情可以在生成过程中不断更新。
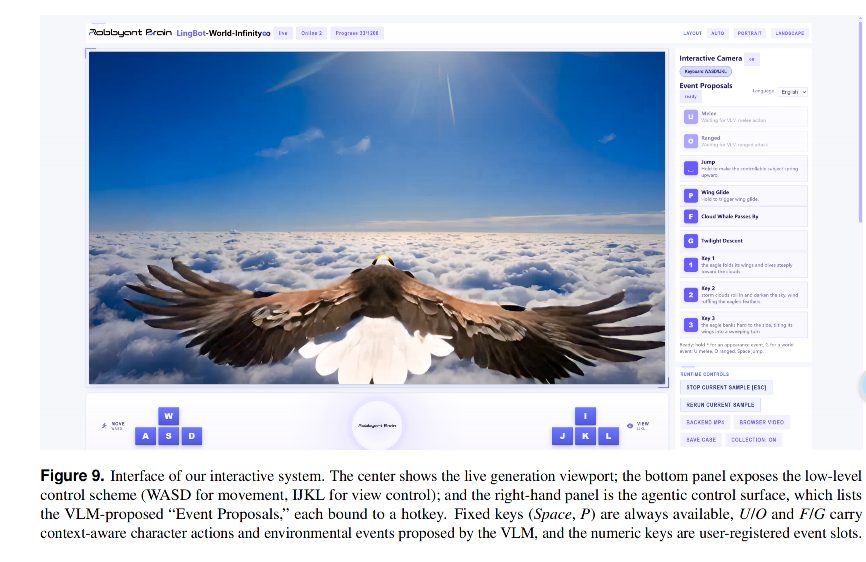
为了让系统主动安排事件,团队还接了一套“导演—执行”框架:
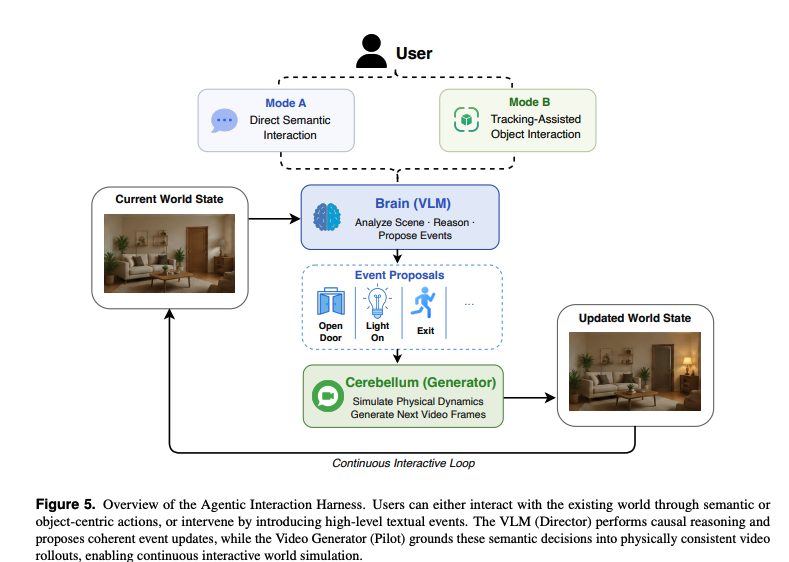
视觉语言模型充当“导演”,观察当前场景、提出事件;视频模型负责生成后续画面。生成结果再交回“导演”观察,继续决定下一步。
需要操作具体物体时,还可以借助基于SAM的分割与跟踪。比如开门,先找准你选中的是哪扇门,再围绕这个对象生成变化。
这就把看场景、安排事件、生成画面接成了一个循环。
我还关心另一件事:一直生成下去,画面会不会越来越离谱?
前面有一点变形,后面又把它当成依据,偏差就可能越积越多。
论文从预训练和后训练两个阶段来处理。
预训练时,常见做法是给模型提供正确的历史画面,让它学习生成后续内容,叫Teacher Forcing。
团队发现,历史内容越长,模型可能越依赖现成的上下文,出现过拟合和画质下降。因此,他们设计了MoBA混合注意力掩码。
它把两种训练方式结合起来:自回归部分练习根据过去生成后续,双向注意力部分则允许训练片段内部充分交流信息,帮助保留视觉生成能力,缓解单纯Teacher Forcing带来的过拟合。
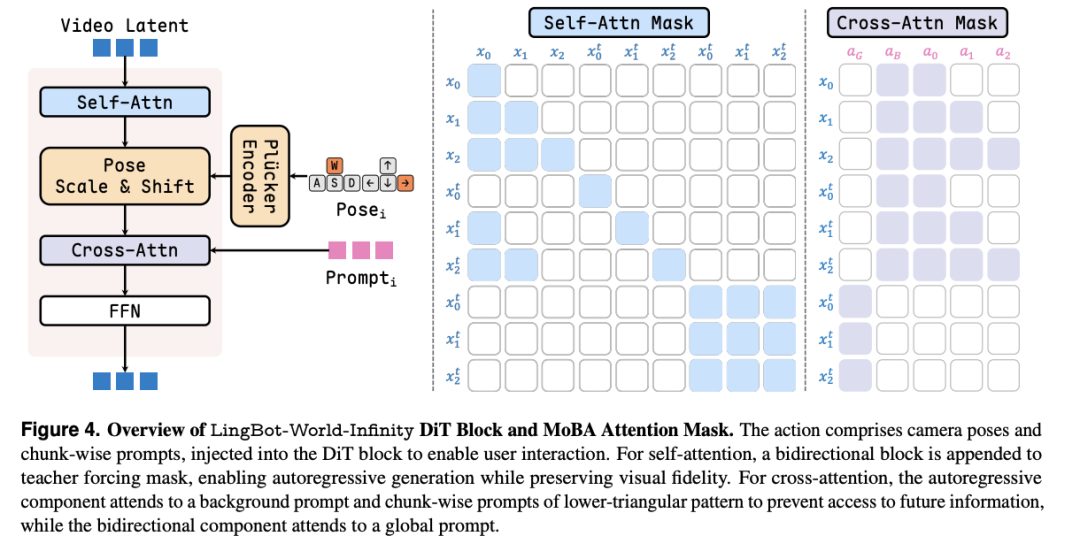
文本也有对应的限制:自回归分支只能读取背景描述、当前和过去的指令,不能提前看到未来要求。
你后面才说“开始下雪”,它不能训练时就偷看答案。
到了后训练阶段,还得把生成速度提上来。
原来的Teacher需要多次去噪,逐步得到画面。团队先做一致性蒸馏,让Student学习用更少的步骤,逼近Teacher多步生成的结果。
但步骤少了,画质和长时稳定性可能受影响,所以接着做分布匹配蒸馏,也就是DMD,让生成结果的分布更接近真实数据分布:
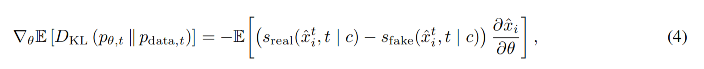
这里最关键的细节,是DMD训练用到了Student自己连续生成的长序列。
如果训练时一直参考正确画面,实际运行时却要接着自己的输出往下画,两种情况就有落差。让它在训练时也面对自己生成的上下文,就是提前适应真实运行中可能遇到的偏差。
前面是自己生成的,后面也得学会接住。
当然,生成得快,还要让用户及时看到。
论文把生成、解码和传输做成了可以同时推进的流水线:模型生成下一段压缩表示时,VAE负责把上一段还原成画面;已经解码好的内容,再逐步传给用户。
这样就不用每个环节都等上一步全部完成,能缩短用户看到反馈的等待时间。
那持续生成的表现怎么样?
论文展示了一次60分钟的连续生成过程,从中选取20个场景:从水乡、城市街道,到温室、雪地码头,再到太空视角。
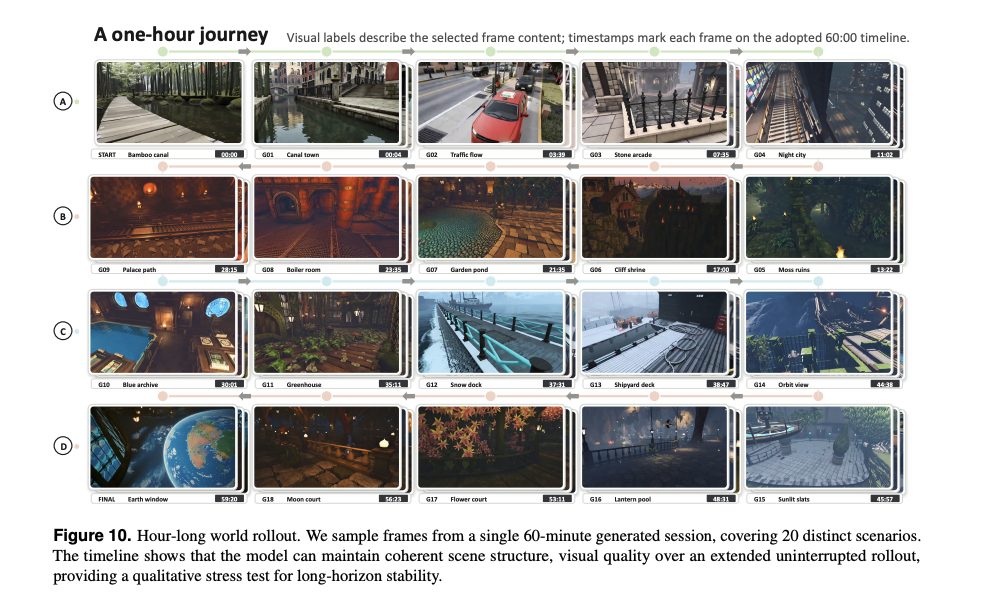
大家可以重点看后半程。运行到三四十分钟以后,建筑、植物和船坞等场景仍有清楚的轮廓与细节;接近一小时时,展示的画面也没有明显的整体画质崩坏。它在经历多个场景后,仍然保持了较好的视觉质量。
再看横向对比。论文把不同模型在灭火器、水上摩托两个场景中的结果,从5秒排到60秒。
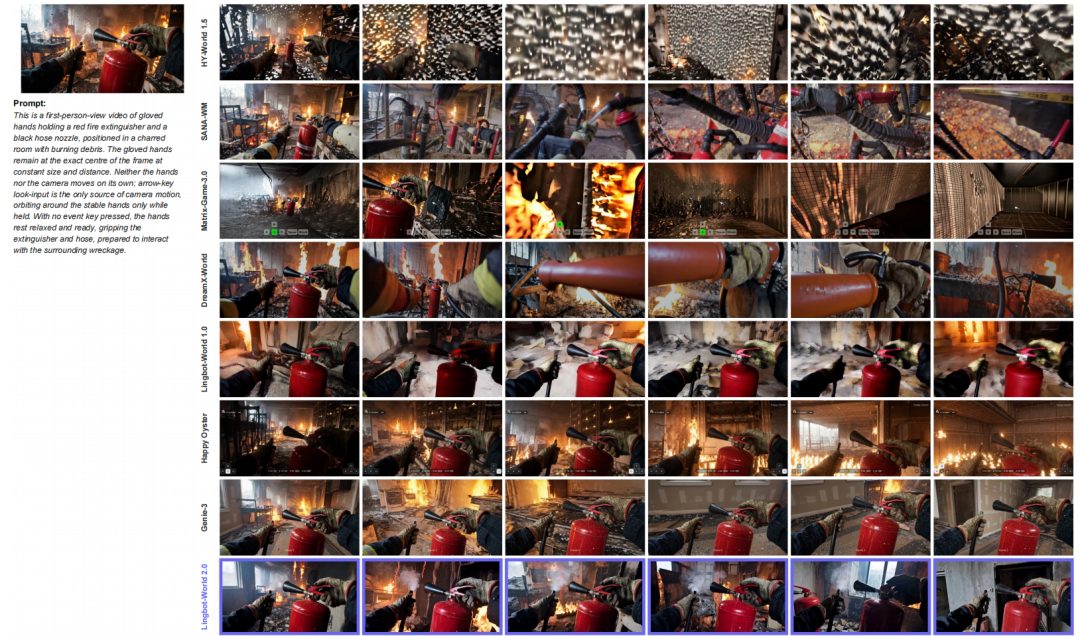
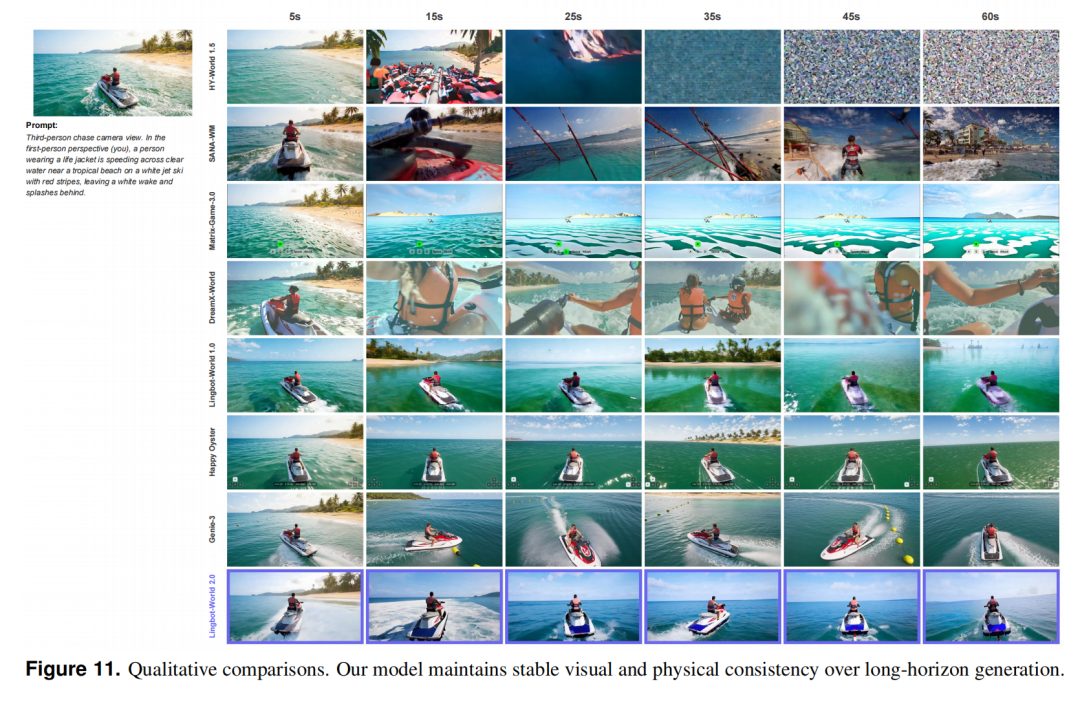
这张图可以先横着看,同一个模型随时间的变化,再竖着比较不同模型。
以水上摩托为例,部分对照结果随着时间推进,逐渐出现噪点、变形或内容偏移。LingBot-World 2.0这一行,到后面的时间点,骑手、艇身和水面的关系仍然比较清楚。
◈结语
我觉得,一个能玩的世界交互模型,难就难在:你随时可以改主意,它还得接得下去。
你转动镜头,它要补出新的景物;你要求施法,人物和环境要一起响应;玩得久了,画面也不能越来越乱。前面那些技术设计,都是在解决这些具体问题。
而LingBot-World 2.0这轮更新,又把自己动手的门槛往下降了一步。
1.3B小模型,让更多人有机会在自己的机器上尝试;同时开放的Causal Pretrain和Bidirectional,则给进一步开发提供了基础—可以继续训练,让模型适应自己的场景,也可以研究怎样通过蒸馏,让生成更快、成本更低。
以前我们只能跟着视频往下看。现在,我们开始有机会自己决定:拐进去看看,再给里面安排一点故事。
这些想法能做到什么程度,还得真正跑起来才知道。但有了自己尝试和修改的条件,才有机会把【看着挺好玩】变成【我也做了一个】。
感兴趣的家人可以上手盘起来了!如果跑出来什么有意思的,欢迎评论区和我们分享~