2B参数跑通多Agent协作?MiniCPM5-2B杀进4B档,训练体系同步开源
原创 让你更懂AI的 2026-09-08 12:06 北京
端侧Agent雏形初现
2B 模型能做到什么程度?MiniCPM5-2B 这次给出的答案,已经不只停留在聊天和基础问答。
今天的大模型世界,很容易让人产生一种错觉:参数越少,能力空间就越有限。
前沿模型还在不断做大,数百 B 乃至 T 级 MoE 已经出现,推理越来越深,Agent 能做的任务也越来越复杂。
到了端侧,能力只是其中一面。有限的算力和内存之外,响应速度、运行成本,以及很多任务能不能直接在本地完成,都会直接影响实际体验。
而当端侧模型还要承担 Agent 任务,要求就更高了。既要足够轻,还得有能力接手任务,把事情做完。
面壁智能最新开源的 MiniCPM5-2B,也把这条「高智能密度」路线带到了新的节点。
从 2024 年第一代 MiniCPM 开源至今,MiniCPM 一直在尝试把更强的能力装进端侧模型里。这一次,一个 2B 模型已经开始尝试承担更复杂的 Agent 任务。
现在不少基础模型的开源,依然主要集中在模型权重。
MiniCPM5-2B 这次除了模型算法和权重,还同步开放了部分训练 recipe、RL 框架,以及覆盖 Code、Agent SFT、RL 和预训练数据精炼的一系列数据成果。
对开发者来说,能研究和复现的内容明显更多了。
2B 参数,能力不止一档
模型做到 2B,难的从来不只是把参数量砍下来。
参数越少,知识、推理、代码这些基础能力越容易一起缩水。到了 Agent 场景,模型还要理解指令、处理长上下文、调用工具,并在多轮执行中根据环境反馈继续推进任务。
MiniCPM5-2B 给出的结果,已经不太像一款传统意义上的 2B 端侧模型。
在覆盖代码、数学、知识、指令遵循、长文本和多类 Agent 任务的综合评测中,MiniCPM5-2B 平均分达到 53.9,超过 Qwen3.5-4B 的 51.1 和 Granite 4.2-3B 的 42.7,同时具备思考、多语言等能力。
其中,代码推理 5 项全部拿到全场最高,工具调用和搜索 Agent 分别 3 项全胜。通用 Agent 的 4 项评测中有 3 项第一,SWE-bench Verified 和 NoLiMa 长文本同样拿下最高成绩。
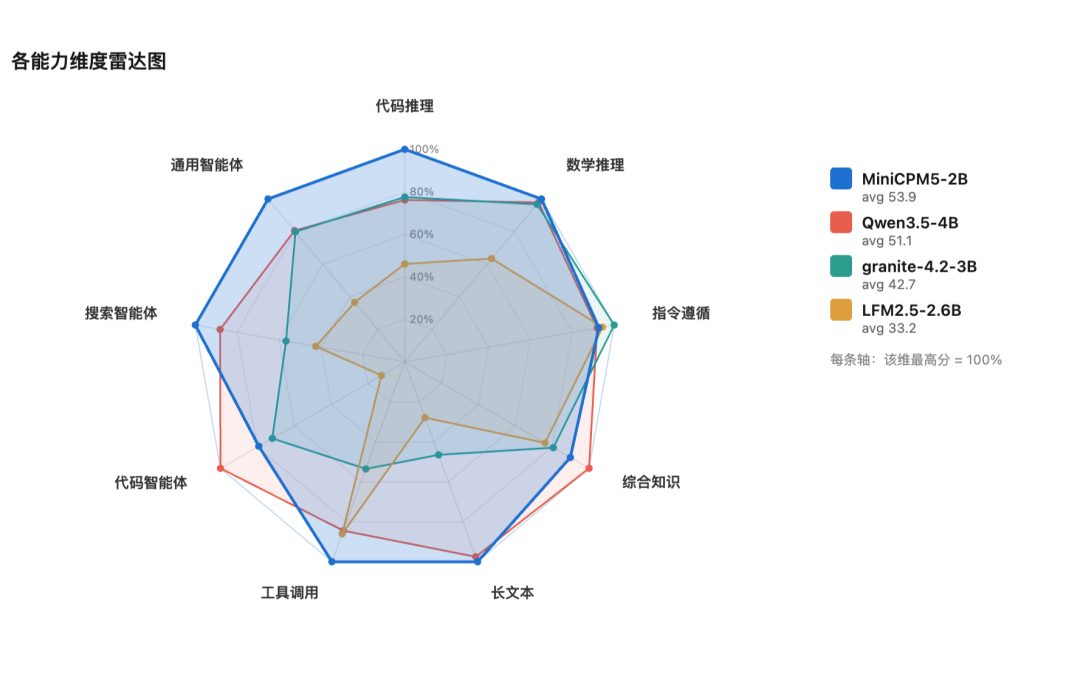
〓MiniCPM5-2B 与同档模型的能力维度对比
在 Artificial Analysis Intelligence Index 上,MiniCPM5-2B 以 23 分拿下全球 4B 以下模型第一,表现甚至超过了 Qwen3.5-9B。
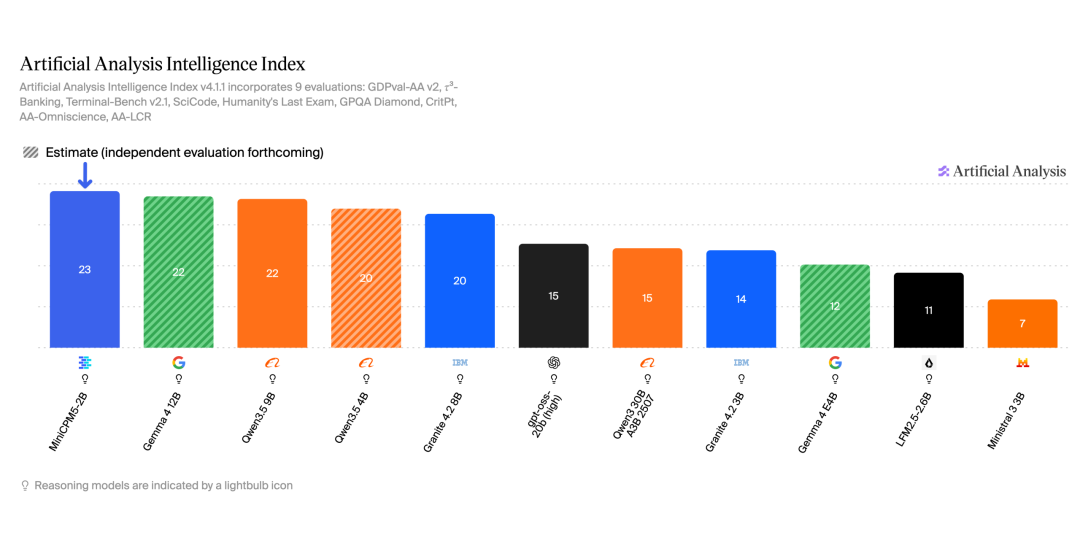
〓 MiniCPM5-2B 登顶全球 4B 以下模型
参数量与 Intelligence Index 的对比更直观,MiniCPM5-2B 已经站到了端侧模型的 Pareto 前沿。
这也延续了面壁过去几年对密度定律的持续研究:在相近的参数预算下,模型能够承载的智能还在继续增加。
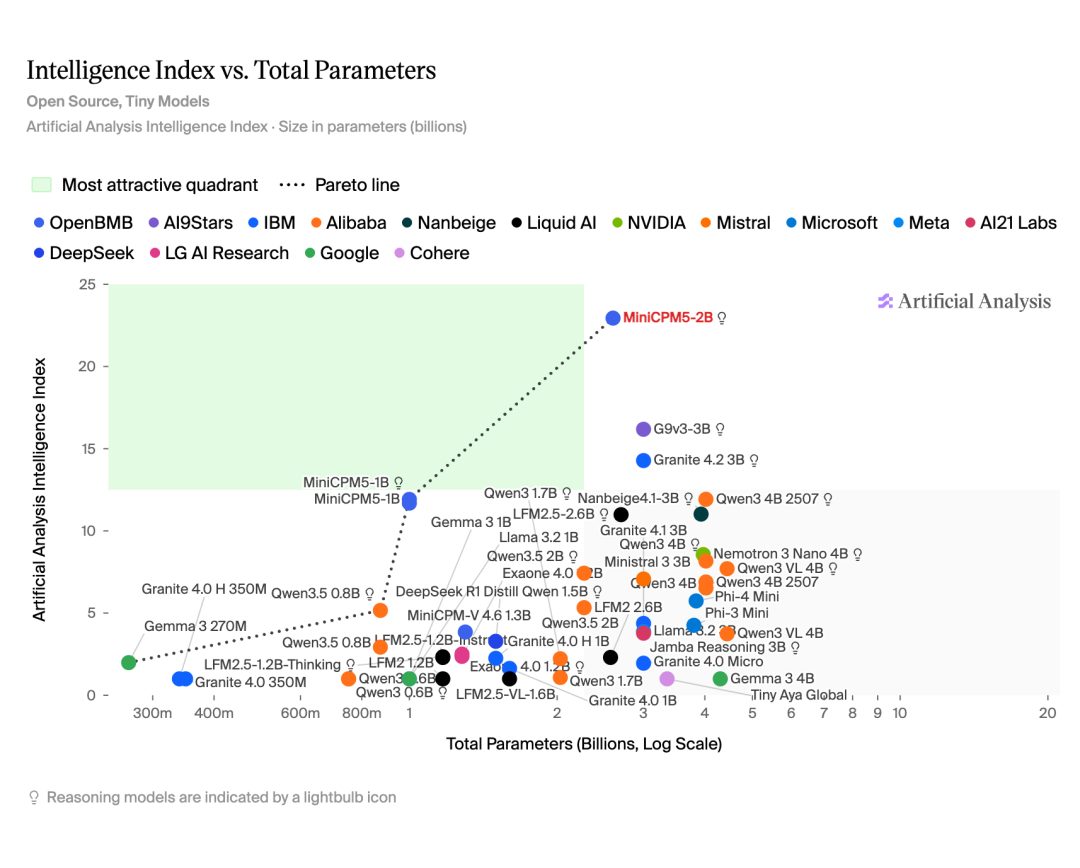
〓Intelligence Index 与模型参数量对比
到了 Agentic Index,MiniCPM5-2B 的领先已经不是几分,而是与第二名拉开了 11 分的差距。
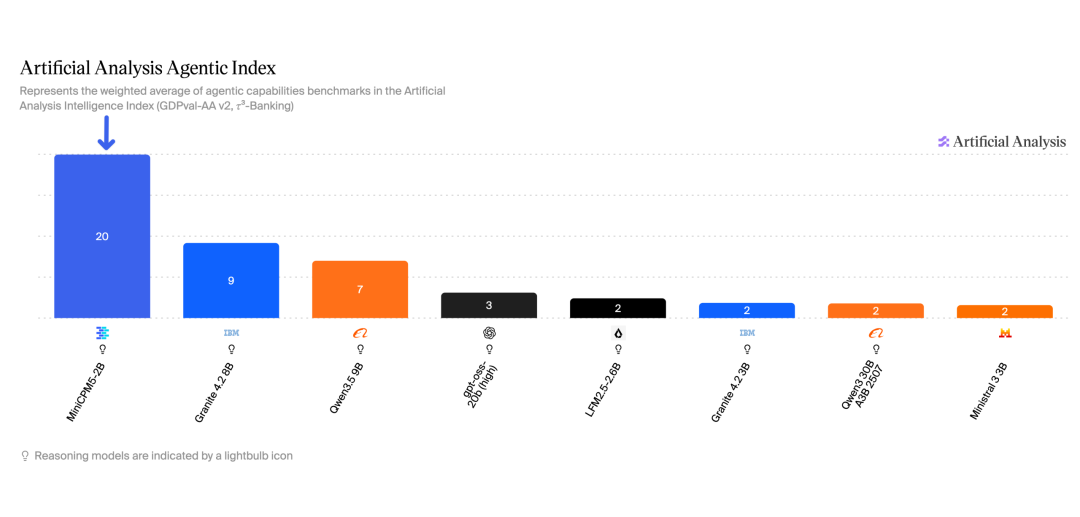
〓MiniCPM5-2B 在 Artificial Analysis Agentic Index 中的表现
在输出长度保持同档水平的同时,MiniCPM5-2B 仍然拿到了 23 分。
从单项评测的平均输出长度来看,它平均输出约 21k tokens,与 LFM2.5-2.6B 基本相当,也和同档模型处在同一量级。
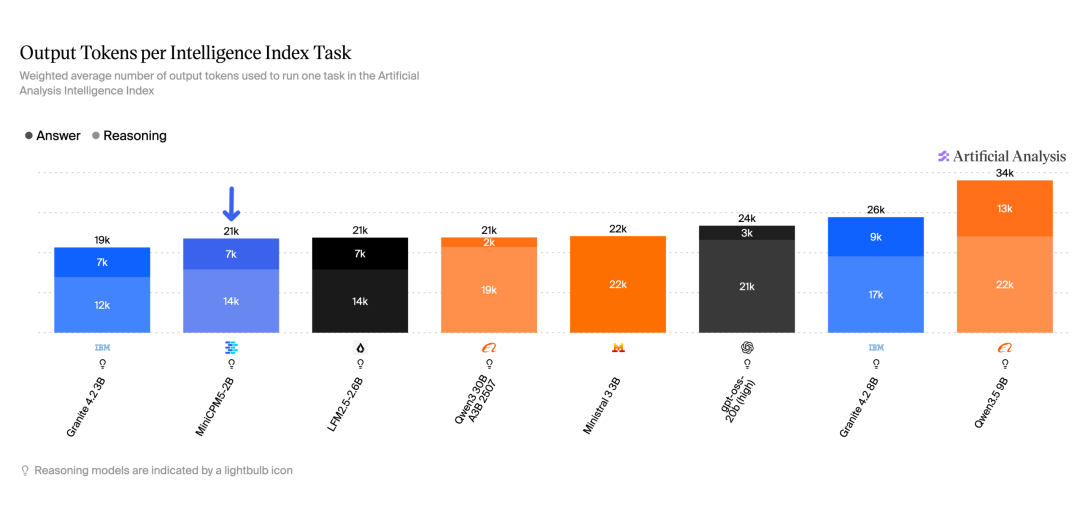
〓Intelligence Index 单任务平均输出 Token 对比
代码生成、工具调用、深度搜索乃至更完整的 Agent 工作流,都已经开始进入这个参数规模的能力范围。
对于端侧模型来说,参数规模已经不再决定能力边界。
我们也实际跑了几个任务。
先给它一份真实企业 AI 算力服务器采购材料。材料里的金额、付款、交付和签约状态,MiniCPM5-2B 很快就梳理清楚了。
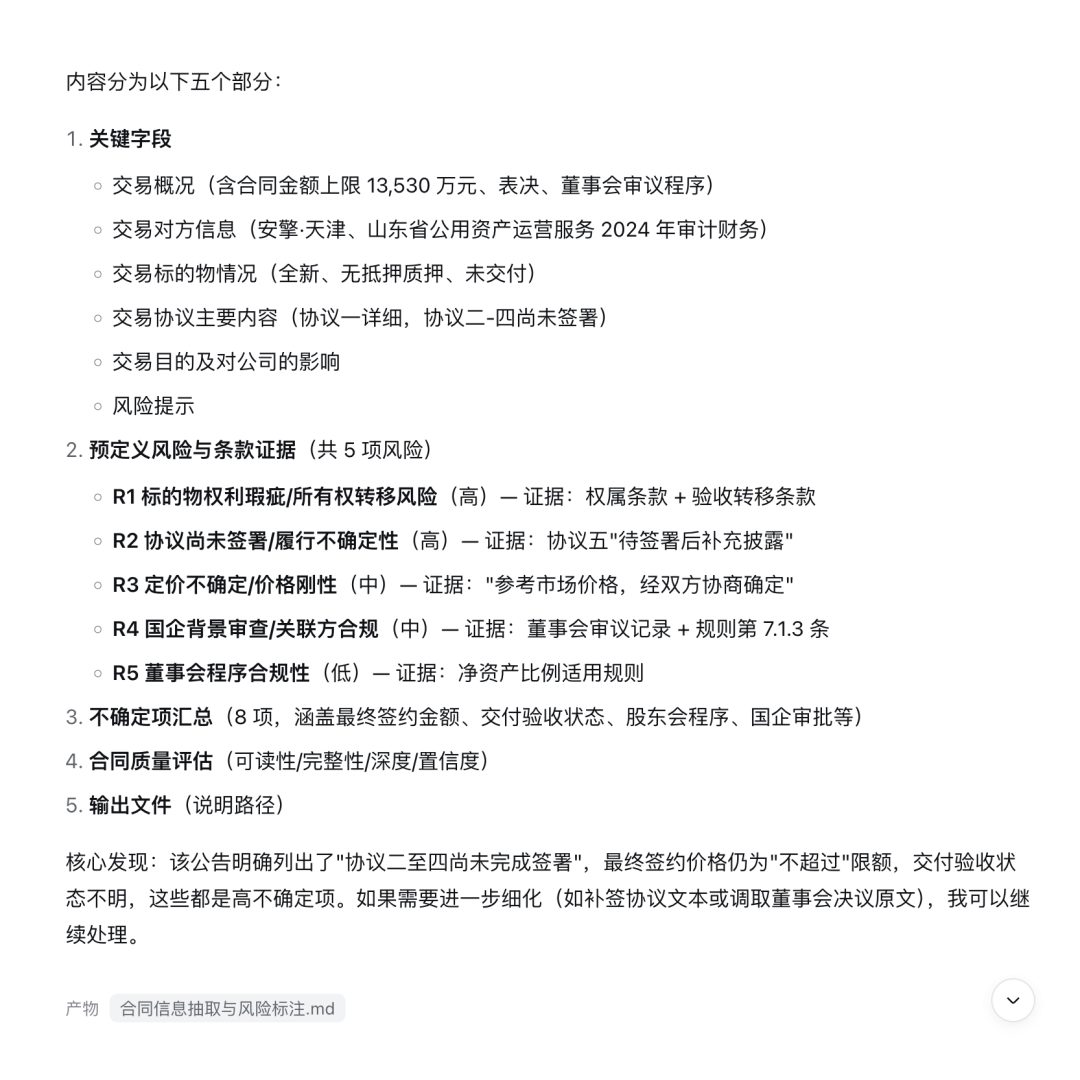
再换到 DJI Osmo Pocket 3,这次直接让 MiniCPM5-2B 自己读取产品页面、抓取重点,整理出一份产品简报。

第三组材料更杂:5 个生成式 AI 内容标识相关的官方页面,不同材料之间还要互相对照、找条款。
最后做出来的结果,已经有模有样了。

我们还想看看,一个 2B 模型能不能把并行任务真正跑起来。
8 篇 Agent 经典论文一起喂给它,MiniCPM5-2B 马上开始“在线摇人”。
Harness 里,8 个 Subagent 同时开工,每个负责一篇论文。第一轮结束后,再交给两个 Reviewer 做复核。
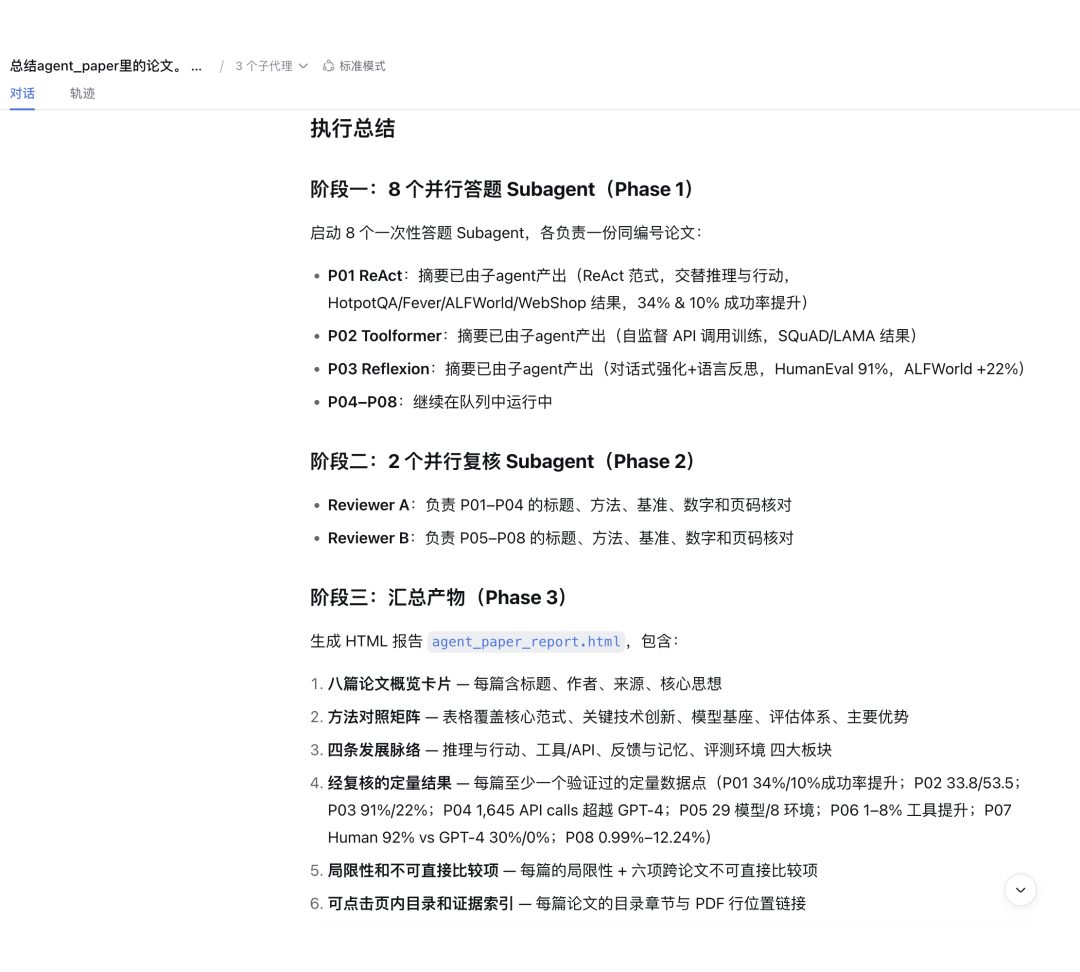
这一轮跑完,8 篇论文的概览、方法对照和技术脉络,也被整理进了一份完整报告。

从读取文件、访问网页,到多来源整理和多个 Subagent 并行执行,MiniCPM5-2B 已经开始把一个 2B 模型能做的事,从回答问题往完成任务继续推。
模型权重之外,数据家底打包开源
这些 Agent 能力,并不是在最后一轮微调里临时补出来的。
MiniCPM5-2B 从 Agentic 预训练、SFT 到大规模 RL,都专门围绕 Agent 做了优化。
贯穿这些训练阶段的,还有一套从预训练语料、代码数据,到 Agent SFT 和 RL 数据的数据治理体系。
每个训练阶段,都有自己的数据策略
先看最直接的一块——UltraData-SFT-Agent-2609。
它是 MiniCPM5-2B Agent 后训练阶段的核心数据池,规模约 50 万条。
工具调用、网页搜索、Code Agent、Office 文档处理、多轮记忆、数据库交互都被放了进去,既有一步就能完成的简单任务,也有需要持续规划、反复调用工具的长链路工作流。
同一个任务还会被放进不同 Agent Harness 和执行环境里反复采样。
工具、系统约束、交互接口发生变化后,模型还能不能把事情做完,也会成为训练的一部分。
最终结果则通过沙箱、测试用例、文件产物等方式真正验收,而不只是看回答“像不像对的”。
代码数据则走了另一条路线。
UltraData-Code 从约 1.92 亿个公开 GitHub 仓库出发,一层层把原始代码变成更适合模型学习的训练材料。
先清洗和去重,再筛出更有算法价值的代码,最后进一步合成任务描述、解题分析、参考实现和测试代码彼此对齐的结构化样本。
这种分层并不只是为了把数据做得更漂亮。
在相同训练预算下,用这类结构化样本替换一半算法代码训练数据后,EvalPlus 和 MultiPL-E 分别再提升 8.42 和 8.07 个百分点。
到了 RL 阶段,UltraData-RL-2609 更关心的是,一道题能不能验证,奖励标签靠不靠谱,以及它对当前模型来说到底有没有学习价值。
模型已经完全会做的题,就没必要继续消耗训练算力。处在“够得着、但还没完全学会”区间的样本会成为训练重点。
至于目前完全做不出的有效难题,也不会一刀切丢掉,而是通过动态采样保留未来继续学习的空间。
预训练数据的「精修术」
预训练语料本身的质量,同样会影响最终的模型能力。
传统过滤更习惯判断一篇网页留还是删,UltraX 处理得更细,它不直接重写整段文本,而是预测保留、删除、替换、插入等结构化编辑操作,再由程序确定地执行到原文里。
一篇网页里,好的内容可以留下,噪声可以删掉,需要调整的部分可以局部替换,而且每一步改了什么都可以记录和追溯。
为了得到这个精炼模型,面壁智能与 OpenBMB 团队先让更强的模型生成精炼后的文本,再把原文和精炼结果重新对齐,把其中发生的删除、插入和替换转换成可执行操作,最终得到约 162 万条 SFT 样本,用于微调 Qwen3-0.6B。
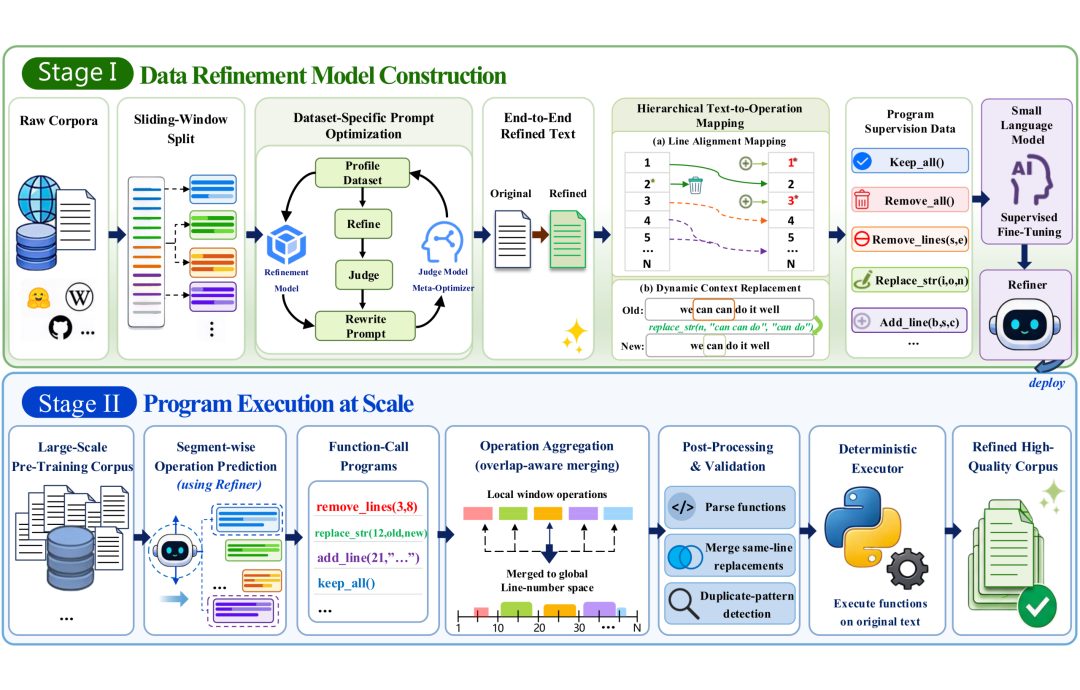
〓 UltraX 的数据精炼流程
团队分别从 FineWeb、RedPajama-v2、AICC、Ultra-FineWeb 和 FineWeb-ProX-Doc 五套语料中各取 20B tokens,用 1B 参数模型从零预训练。
UltraX 在五套语料上的平均表现全部最高,50 组“任务 × 语料”组合拿下 34 个最佳结果。相比原始数据,平均相对提升约 2%。
最直观的一组来自 FineWeb,UltraX 只训练到 16B tokens,平均分已经达到 45.49,超过原始数据训练满 20B tokens 的 45.08。
少用 4B tokens,结果反而更高。
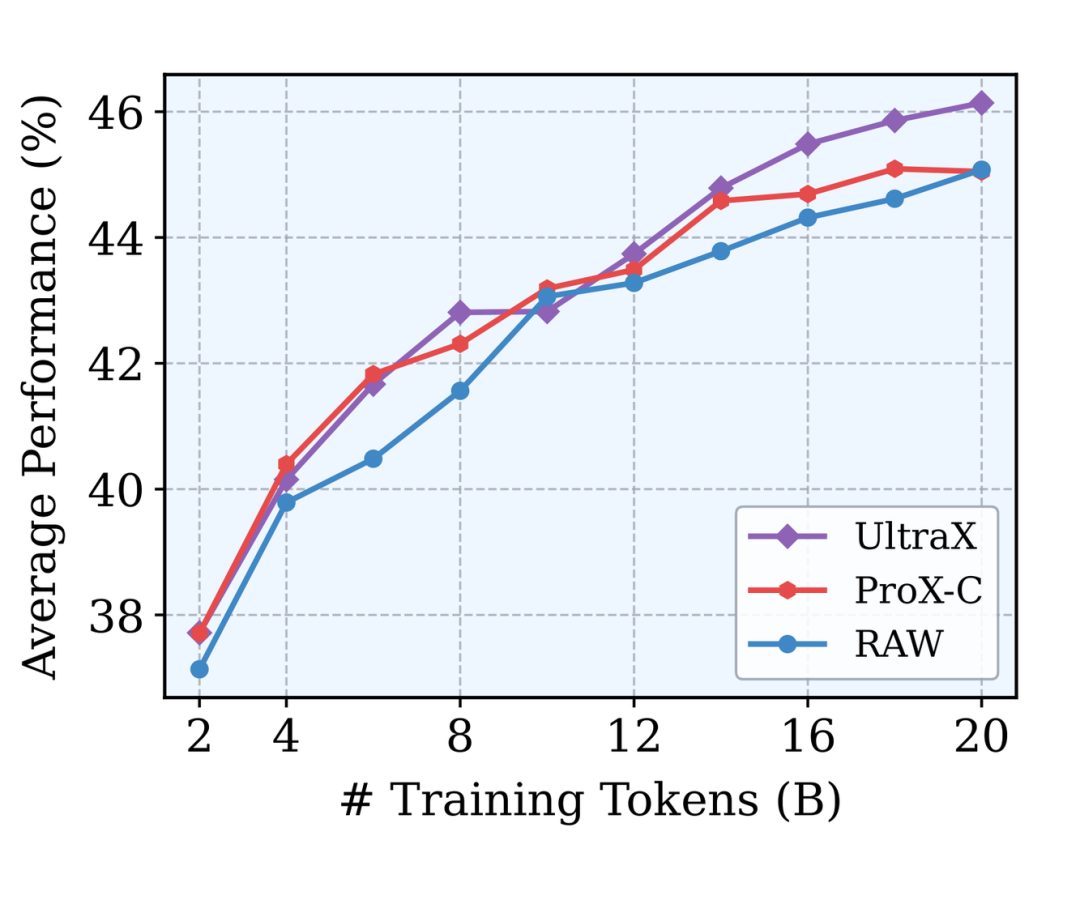
〓 FineWeb 在不同训练 token 预算下的平均下游性能
而且这种提升并不是靠大规模删数据换来的。
在 Ultra-FineWeb 这类本来就比较干净的高质量语料上,UltraX 只减少约 3.8% 的 token,同时保留超过 99.2% 的非空样本。
作为 UltraX 的开源数据成果,UltraX-Preview 包含五套精炼语料,总规模约 100B tokens、1.14 亿条样本,原始文本、精炼结果和实际执行的编辑操作也一并保留。
从预训练到后训练,MiniCPM5-2B 的多个训练阶段都有对应的数据成果开放出来。
这也不是面壁与 OpenBMB 第一次把训练数据拿出来。
从 UltraChat、UltraFeedback,到 Ultra-FineWeb,再到这次的新一批 UltraData,双方已经开放超过 10 个大模型训练数据集。
截至 2026 年 9 月,UltraData 系列累计下载量超过 266 万。
RL 框架同步开放
在 RL 这一环,面壁这次开放的也不只有训练数据。
随着 MiniCPM5-2B 开源,OpenBMB 还同步开放了自研强化学习框架 Meshy,以及面向长思维链强化学习的 JustRL II 训练配方。
RL 训练,换一种组织方式
Meshy 不再设置中央控制器,也摆脱了 Ray 依赖,而是把 Inference、Training、Rollout、Teacher 等角色做成独立 Service。
样本通过 TransferQueue 在服务之间流动,整个流程由数据是否就绪来驱动。
通过 recipe 组合不同角色,同一套框架可以支持同步 RL、有界异步、全异步流式训练以及 OPD,不需要为不同训练方式重新写一套中央控制流程。
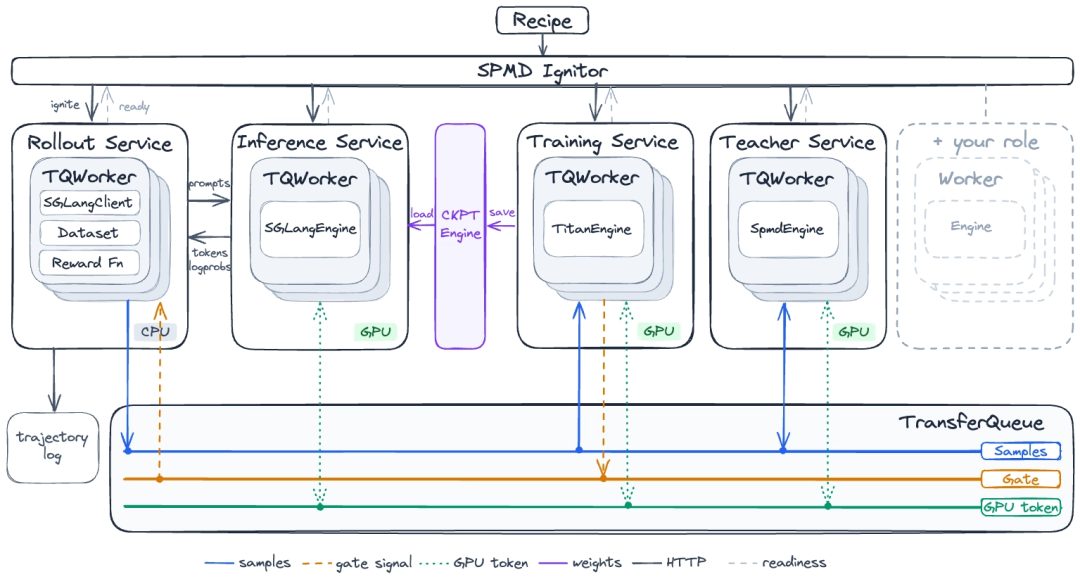
〓 Meshy 的角色驱动 SPMD 架构
让长思维链训练更稳定
用长思维链做强化学习时,训练前期指标还在上涨,到了后期却可能开始回落。
一方面,训练数据里的噪声标签、错误题目和难度错配,都可能让奖励信号产生偏差。
另一方面,GRPO 的信用分配比较粗,面对数万 token 的长推理链,很难判断具体哪些步骤真正起到了作用。
为此,MiniCPM 团队提出了 JustRL II。
数据侧,JustRL II 通过三阶段流水线筛选和校准训练数据。算法侧,则在保留 GRPO group 结构的基础上引入 Critic,把信用分配进一步细化到 token 级。
同样的数据和算力下,不带 Critic 的 baseline 在 74% 左右见顶后开始回落,JustRL II 则继续提升至 81%。
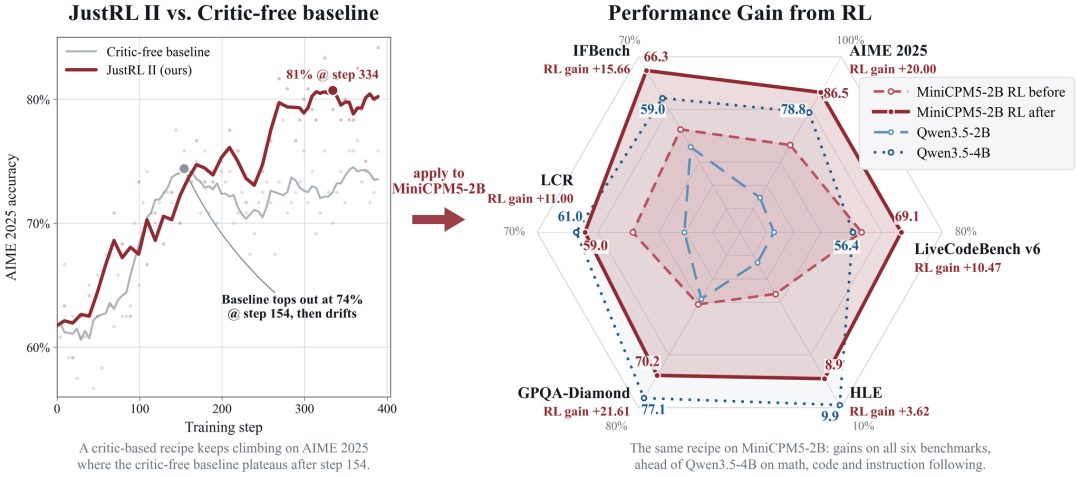
〓 JustRL II与 baseline 的训练表现及 RL 后能力变化
这套训练配方随后被用于 MiniCPM5-2B 的多领域 RL 后训练,并通过多教师在线策略蒸馏将不同领域的能力整合回最终模型。
最终,17 项评测全部获得提升。
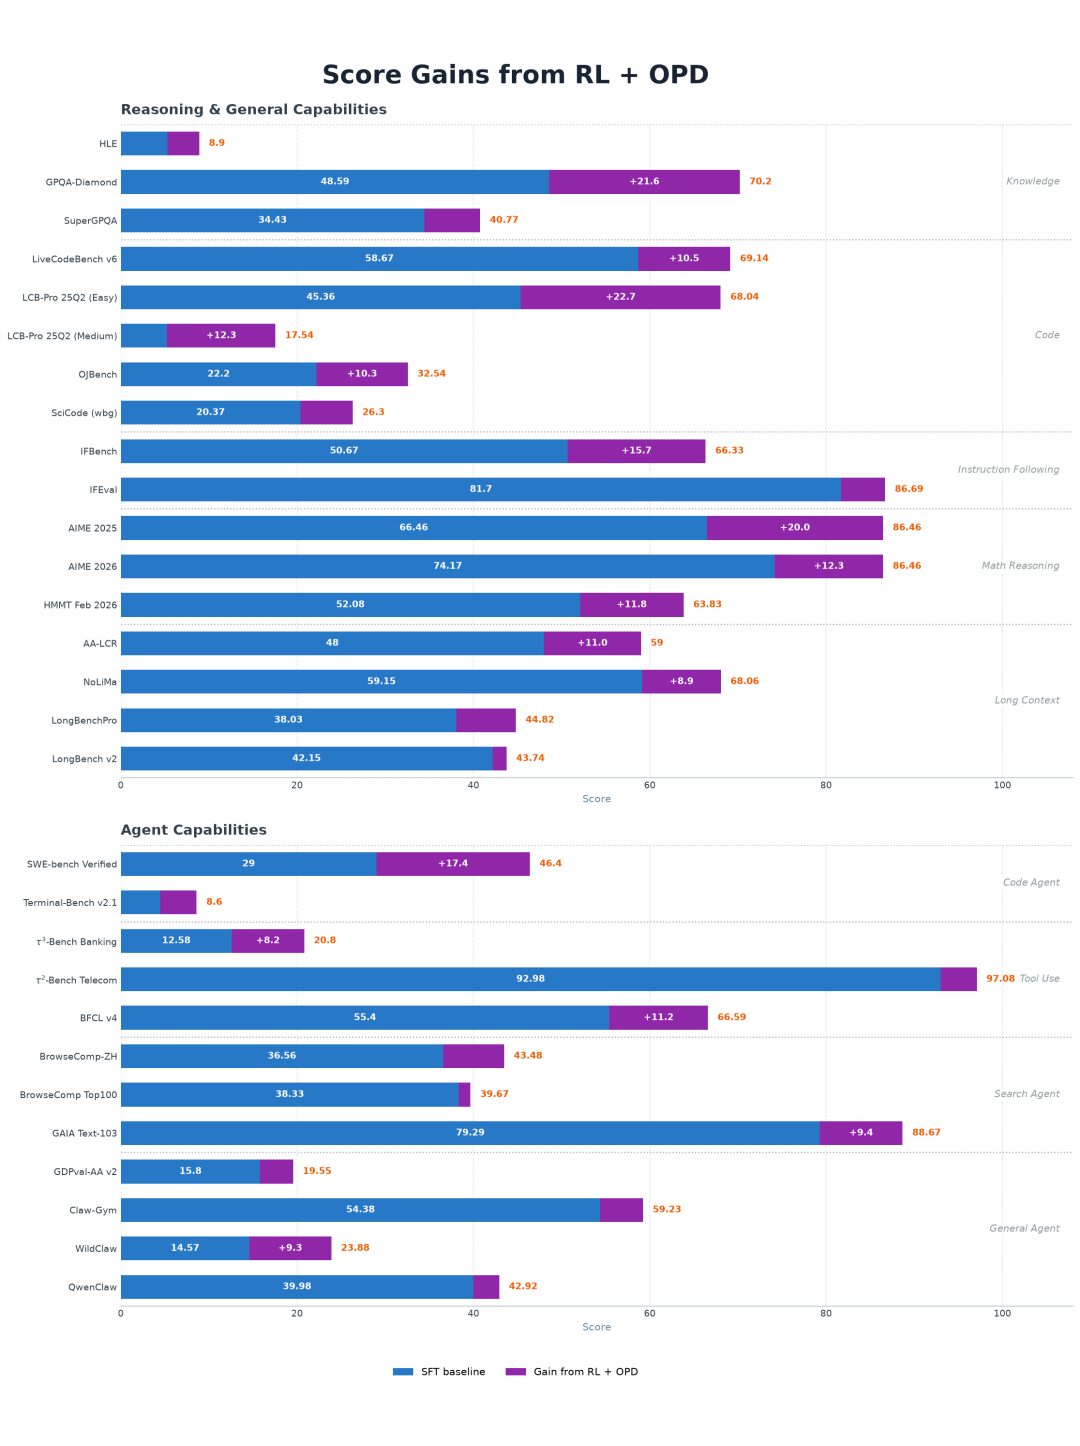
〓 MiniCPM5-2B 在 RL + OPD 后训练中的性能增益
结语
两年多以来,MiniCPM 一直在做同一件事:让端侧模型承担更多任务。
到了 MiniCPM5-2B,2B 参数已经覆盖代码、长文本、工具调用和深度搜索,多 Agent 协作这类更复杂的工作流也开始跑起来,端侧通用 Agent 的雏形随之变得更清楚。
这次开放的内容不只停在模型本身。部分训练 recipe、数据和 RL 框架进一步向社区开放,模型能力背后的训练方法、数据治理和强化学习基础设施,都有了更多可研究、可复现的空间。
端侧模型的竞争,已经不只是在有限资源下完成部署,还要看有限参数预算下究竟能够承担多复杂的任务。
MiniCPM5-2B 给出的,是面壁智能对这个问题的又一次回答。
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧
·