多篇论文入选国际顶会 EMNLP 2026!小米 AI 大模型技术实现创新突破
小米技术 2026-08-28 17:49 北京
近日,2026年EMNLP会议(Conference on Empirical Methods in Natural Language Processing)公布论文录用结果,小米共有 8 篇最新研究成果成功入选,覆盖移动智能体、大模型训练与推理效率、智能研发与主动智能等方向。
从让手机 AI 助手更准确、稳定地完成复杂任务,到让大模型“学得更省、想得更快”,再到探索 AI 辅助模型研发、判断何时主动提供帮助,此次入选成果围绕 AI 在真实场景中的效率、可靠性与智能化能力展开,持续推动前沿研究向实际智能体验延伸。
EMNLP 是自然语言处理领域国际公认的重要学术会议,聚焦自然语言处理与计算语言学领域的前沿研究与技术进展。EMNLP 2026 将于 2026 年 10 月 24 日至 29 日在匈牙利布达佩斯举行。
01
移动智能体
让 AI 从“会操作”到“做得对、走得稳”
▍GSAR: Goal-State-Anchor Rewards for Mobile GUI Agents with Self-Evolving Data Synthesis
合作者单位:武汉大学
论文作者:张龙,陈雨涵,张超然,曹晚霞,黄琨,高鹏至,刘伟,栾剑,李晨亮,邹立新
录用类型:主会长文
论文链接:https://arxiv.org/abs/2608.22847
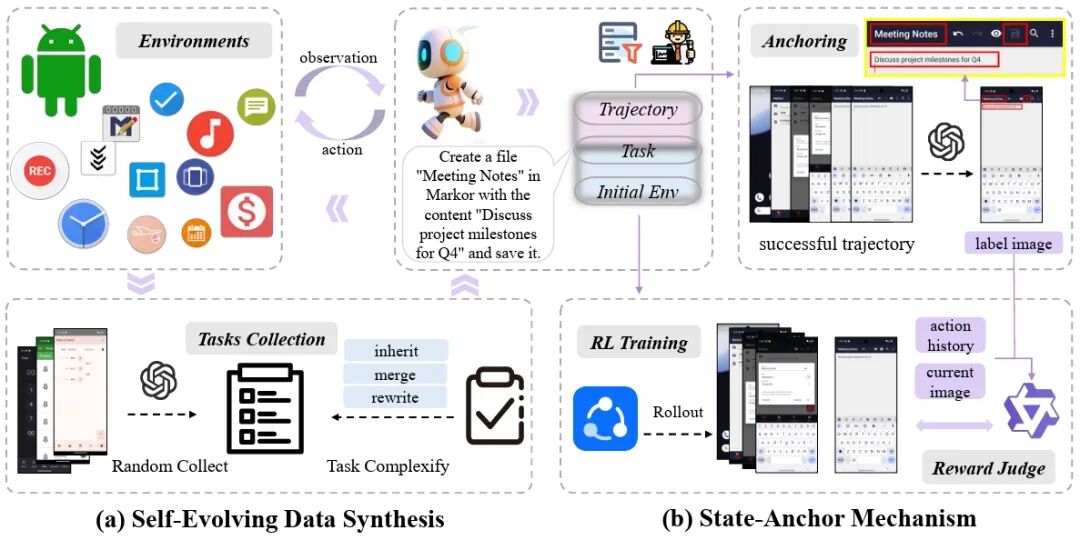
要让手机 AI 助手真正学会自己操作 App,得靠强化学习“边试边学”。但这里有两个老大难:训练任务过去要工程师一条条手工设计,规模一直做不大;判断“这一步做得对不对”的规则也要人工一条条写,稍复杂就顾不过来。
GSAR 让这两件事全部自动化AI 助手在与 App 反复交互的过程中,自己生成难度递增的新任务和执行路径;同时把“任务完成时的关键页面”当作参照物,自动识别其中和任务目标最相关的界面元素,判断某次操作是否真的达成了目标,彻底告别人工写规则。实验中,GSAR 判断任务是否完成的准确率超过 90%,并在 AndroidWorld 等主流基准上明显提升了 AI 助手的实际操作能力,为手机 AI 助手的大规模训练打开了一条更高效的路径。
▍GUI-PRA: Process Reward Agents for GUI Tasks
合作者单位:浙江大学
论文作者:熊涛,胡雪瑜,陈雨润,刘宇航,吴昌桥,高鹏至,刘伟,栾剑,张圣宇
录用类型:主会长文
论文链接:https://arxiv.org/abs/2509.23263
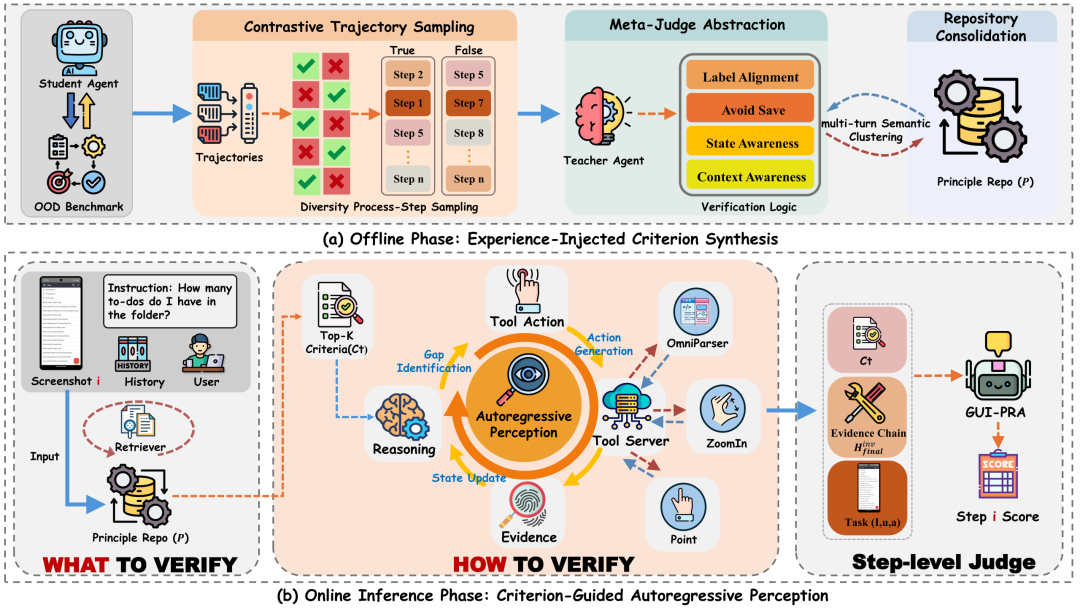
让 AI 助手完成订票、发消息这类多步任务时,如果只在最后才检查对错,中间某一步的小错误会一路滚雪球。已有的“过程打分”方法只是被动扫一眼整张截图,既没有明确的判断标准,也不会主动去核实关键细节。
GUI-PRA 把这个“打分员”升级成一个会主动取证的智能体:先从过往成功和失败的操作对比中总结出“什么样才算做对”的原则,再针对当前状态生成具体判断依据,一旦证据不足就主动调用视觉工具去核对界面细节,形成“原则—依据—证据—结论”的完整推理链。在 AndroidWorld 和 Mobile-MiniWoB++ 两大基准上,GUI-PRA 相比传统打分方法平均提升约 5.0 和 6.5 个百分点,并且无需训练专用 critic 也能在 OS-Critic Bench 上取得有竞争力的效果。
▍Towards Omni-dimensional GUI Agent Navigation with Masked Trajectory Prediction
合作者单位:中国科学院信息工程研究所,南开大学
论文作者:张言,付培,吴岱卿,申化文,张若嶒,张少杰,杨佳辉,周宇,马灿,罗振波,栾剑
录用类型:Findings 长文
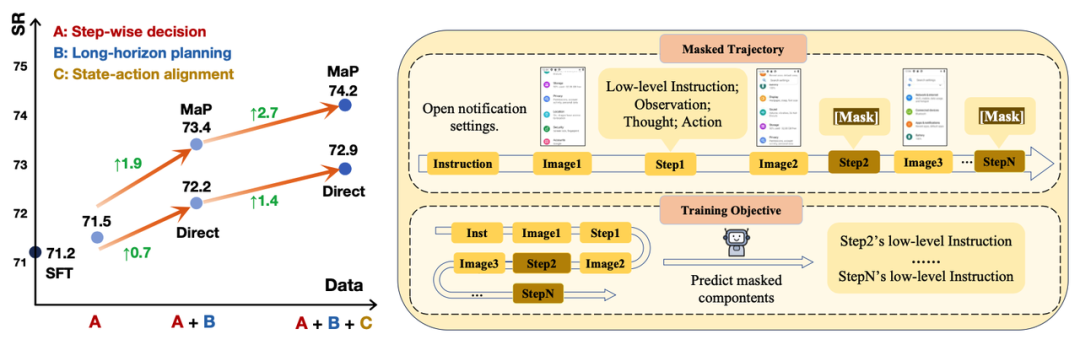
要让 AI 助手在真实 App 界面中完成任务,需要同时掌握三种能力:单步“下一步该点哪里”的决策、当前界面与动作是否匹配的判断、以及跨多步的整体规划。过去的方法要么把三种能力分开训练,要么把不同数据一股脑混在一起训练,容易顾此失彼。
团队提出的 MaP 把用户指令、界面截图、推理过程和操作动作打包成一个完整的“交互轨迹”,训练时随机遮住交互轨迹中的某一段,让模型学着补齐:用同一个训练目标把三种能力串到一起,同时通过“角色分工”机制区分不同信息,避免相互干扰。在五个主流 GUI 导航基准上,相较于直接混合训练,MaP 在三项核心能力上分别取得 2.8%、5.4% 和 2.1% 的零样本提升;在 AndroidControl-High 和 AndroidControl-Low 上,任务成功率分别从 72.9% 提升至 74.2%、从 89.0% 提升至 90.9%。
02
大模型效率
让 AI 从“会思考”到“学得省、想得快”
▍Informed Masking: Structure-Aware Perturbation for Reinforcement Learning in Diffusion Large Language Models
合作者单位:中国人民大学,University of Modena and Reggio Emilia
论文作者:喻霄奕,Enver Sangineto,付培,Fiorenzo Parascandolo,谭文辉,张睿康,Rita Cucchiara,宋睿华,栾剑
录用类型:Findings 长文
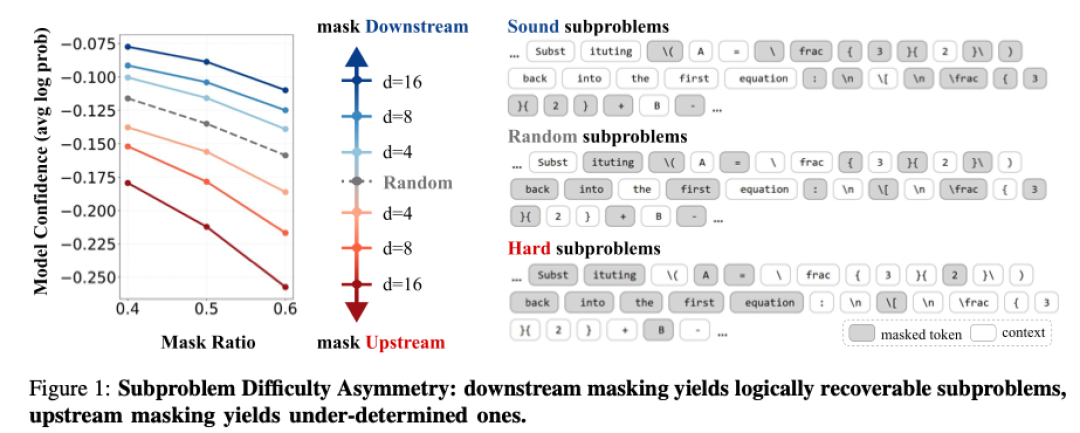
扩散大语言模型(dLLM)是与主流“逐字生成”模型并行的另一条路线,靠“先给整句话打上马赛克再逐步还原”的方式产生文本。用强化学习进一步训练它时,需要反复“遮住一部分文字让模型来猜”。但过去大家都是随机遮,简单题和难题混在一起,学习效率很低。
团队发现,句子里的字并不平等:有些“关键字”一旦被遮住,会带动周围一大片猜测都出错,属于“高难度题”;另一些字被遮住后只影响局部,是“合适练手题”。基于这一发现,团队提出的 Informed Masking 让训练时更多聚焦在“合适练手题”上,且不增加任何额外算力开销。将其接入三种最新的 dLLM 强化学习方法并应用于 LLaDA-8B-Instruct 后,在数学和规划类基准上分别带来最高 2.01%、8.52% 和 5.77% 的相对平均提升,训练过程也更加稳定。
▍ECHO: Early-layer Collaborative Hierarchical Orchestration with Bonus Logits in Speculative Decoding
合作者单位:武汉大学
论文作者:马子阳,张子红,李祖超,张乐飞,齐保元,李思奇,于思民
录用类型:主会长文
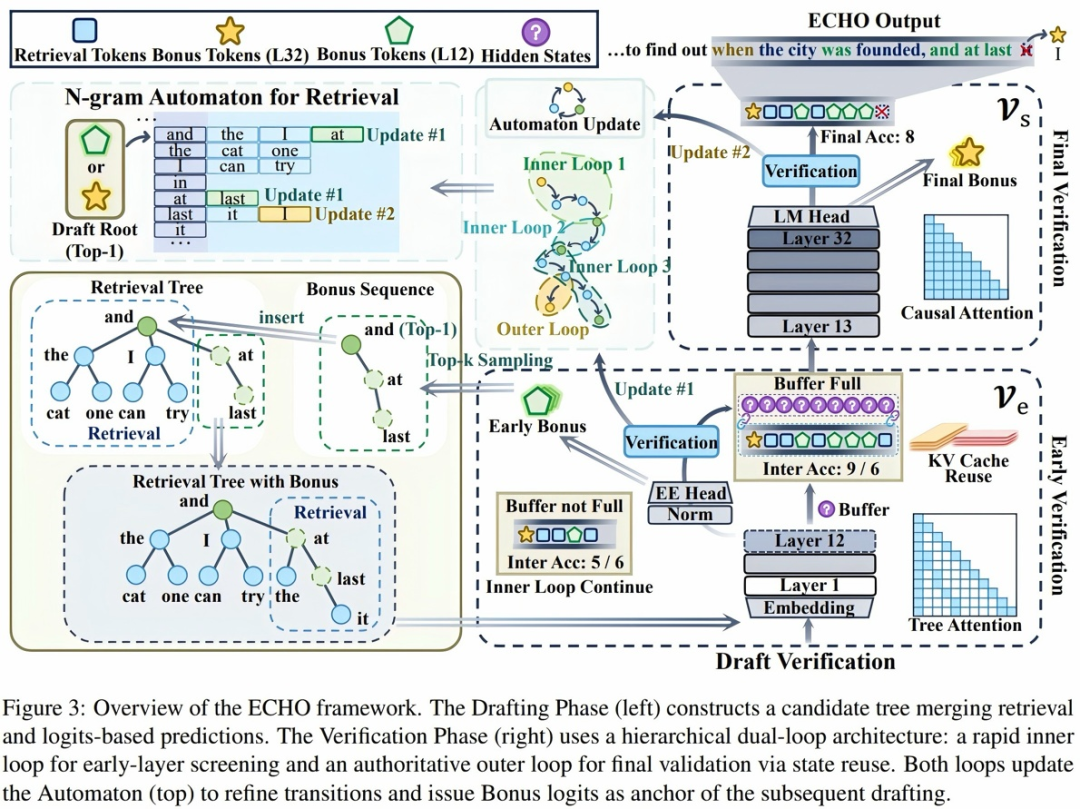
大模型输出慢的主要原因是“逐字生成”,一次只能吐一个字。业界的加速思路是“投机解码”,也就是先快速草拟出后面几个字,再由完整模型统一验证,猜对就跳过、猜错就纠正。此前的做法通常只用大模型最终层的信息来草拟,草稿更新慢、验证成本也高(业内称之为“验证墙”问题)。
ECHO 巧妙利用了大模型内部不同层的分工:让早期层负责“快速草拟”、由完整模型负责“权威验证”,形成一快一慢的双循环结构,把草稿从“照抄历史”升级为“理解上下文后再预测”。在 Spec-Bench、HumanEval 和 GSM8K 等基准上,ECHO 不需要新增任何参数就实现了 2.4 至 3.01 倍的推理加速,并大幅提升了草稿质量与接受率,是一种即插即用的通用提速方案。
▍BORA-BUDGET: Learning When to Think Under a Token Budget
合作者单位:上海交通大学
论文作者:王子龙,潘康, 张霄,孟二利, 李帅
录用类型:主会长文
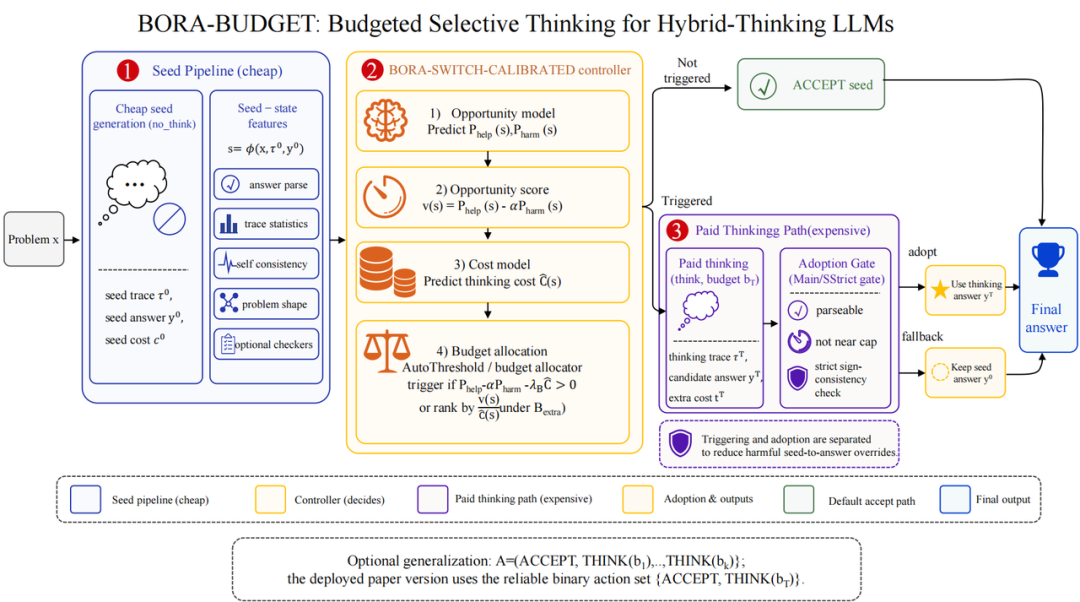
具备“深度思考”能力的大模型很聪明,但深度思考很耗算力,每个问题都进行深度思考可能消耗大量token,造成一些不必要的浪费。BORA-BUDGET 要解决的核心问题就是:在有限的 token 预算内,如何判断“哪些题目值得多想一步”?
框架的思路是把模型的计算资源当作预算来精细分配:先用快速模式给出一个初始答案,再预测“多想一想会带来多少收益”、“可能出错的风险有多大”、“要多花多少 token”,只对真正值得的问题启动深度思考。同时,团队还把“要不要多想”和“想完的结果要不要采纳”分成两个独立判断,避免深度思考反而把原本正确的答案改错。控制是否触发深度思考的控制模型通过收集深度思考后的回答反馈使用强化学习算法进行训练,在 Qwen3-8B 的 MATH500 测试中,快速模式准确率为 73.40%、全量深度思考为 93.33%(平均 4293 token);BORA 只用 3534 token 就达到 91.40%,而同等 token 消耗、50% 触发比例的随机策略只有 82.71%。在更大的 Qwen3-14B 上,BORA 用 3360 token 达到 93.13%,逼近全量思考的 95.07%(3903 token)。该方法把算力集中投入到真正困难的题目上,为大模型的低成本部署提供了一条实用路径。
03
智能研发与主动智能
让 AI 从“被动响应”到“主动判断、持续进化”
▍Accelerating Neural Architecture Search with Code Semantics
合作者单位:西安交通大学,北方工业大学,中关村学院
论文作者:刘振,周婉琪,白双豪,宋伟,张贺,刘雨涵,付靖文
录用类型:主会长文
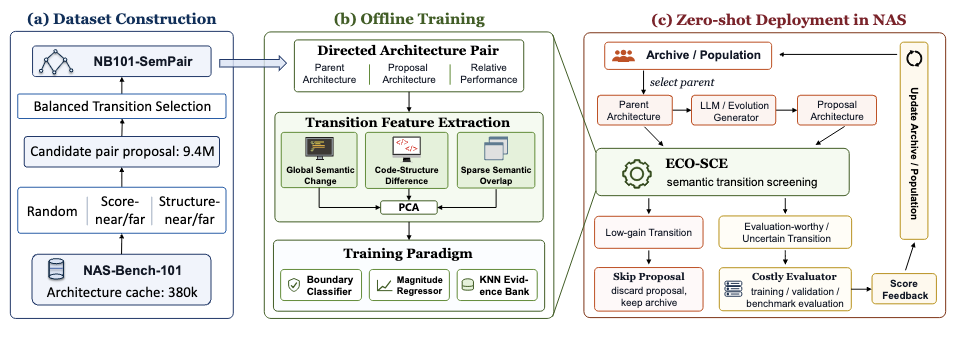
随着大模型开始自动改写神经网络代码,“让 AI 设计 AI”逐渐成为研发新趋势。但每尝试一个新方案都要完整训练一次才知道效果,算力和时间成本非常高。ECO-SCE 的做法是“先看看再决定要不要试”:在正式评测前,分析新方案相比原架构在代码层面到底改了什么,提前筛掉大概率没有收益的改动,把宝贵的评测预算留给真正值得投入的方案。这与仅仅判断“代码能不能跑通”不同——即便能跑通,ECO-SCE 也能识别出哪些改动其实没有意义。接入 OpenEvolve 后,ECO-SCE 在 7 个基准任务上平均节省 70.88% 的 GPU 时间,其中 6 个任务性能不降反升。该成果为小米沉淀了可复用的低成本自动化模型设计能力,有助于缩短端侧 AI、智能汽车和智能家居等场景中专用模型的研发周期,降低算力投入。
▍Perceive Before Reasoning: A Pre-Reasoning Perception Framework for Efficient and Reliable Proactive Mobile Agents
合作者单位:中南财经政法大学、吉林大学、香港中文大学(深圳)
论文作者:丁志杰,洪伟楠,祝子成,李磊,孔德志,王昊,周鹏,姜旭初,许家铭
录用类型:主会长文
论文链接:https://arxiv.org/pdf/2606.03236
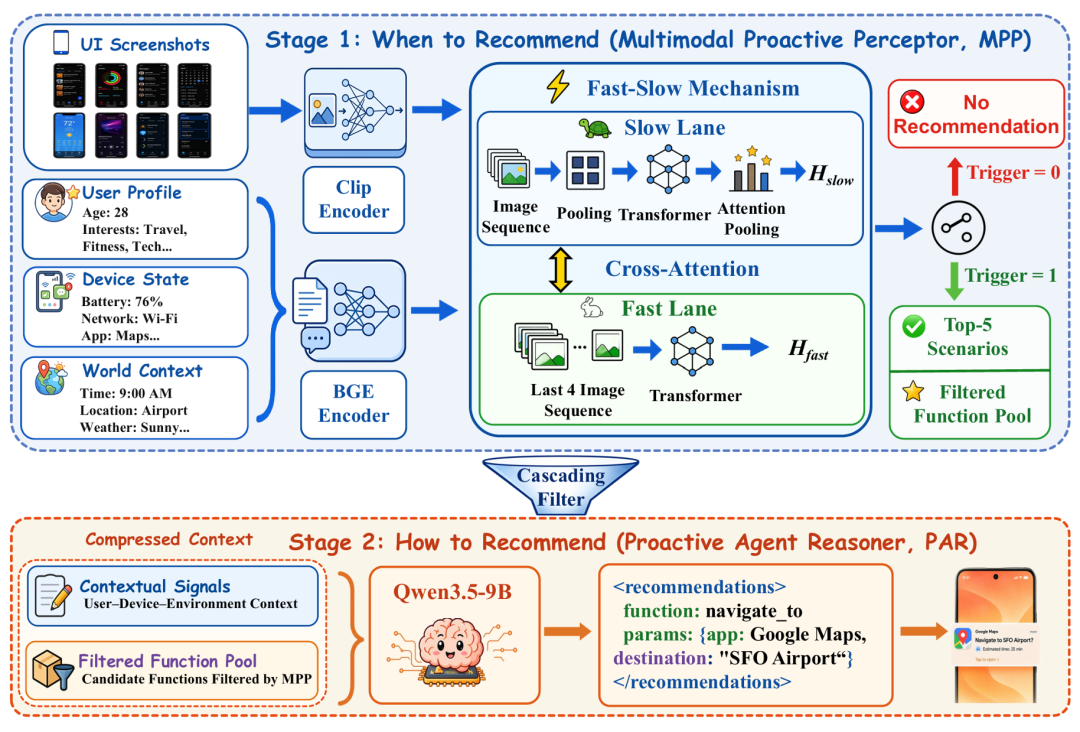
一个真正智能的手机助手不仅要能“回应你的问题”,还应该主动预判“该不该现在开口”、“要做什么”。这两个决策本质不同:前者要保守(免得频繁打扰),后者要深入(说得有价值)。但过去的系统用同一个大模型流水线同时处理这两件事,很难兼顾,还经常在不该出声的时候浪费算力做深度推理。
团队提出的 PRPF 采用“先感知、后推理”两步走:先用一个轻量模型快速判断“这个场景到底要不要推荐”,只有确认值得时才交给主推理模型深度思考。在 ProactiveMobile 基准上,PRPF 相比基线将任务成功率从 20.82% 提升到 41.15%,误触发率从 13.76% 降至 7.21%,同时推理算力开销降低 69.3%。
-
随着大模型和智能体技术不断演进,AI 的竞争正在从单点能力突破,走向训练、推理、执行与决策等多环节协同。对于小米而言,AI 也正在成为连接手机、汽车与智能家居的重要技术能力,模型是否足够高效、智能体是否足够可靠、系统是否能够理解环境与用户需求,都会直接影响下一阶段的智能体验。
此次入选 EMNLP 2026 的 论文,体现了小米围绕大模型、智能体、主动智能等方向的持续探索。从基础研究到工程能力积累,再到人车家全生态中的具体应用,小米正在不断完善 AI 技术体系,让不同方向的研究彼此支撑、相互协同。
面向未来,小米也将继续围绕真实用户需求和真实使用场景推进技术创新,让 AI 更自然地融入设备、服务与场景之中,为人车家全生态带来更连续、更智能的体验。
END