VLDB 2026|字节数据库 5 篇论文入选,附现场分享安排
字节跳动数据库 2026-09-01 17:00 北京
作为数据管理与数据库系统领域最具影响力的国际会议之一,VLDB 2026 于当地时间 8 月 31 日‑9 月 4 日,在美国波士顿拉开帷幕。字节跳动数据库团队今年共有 5 篇论文入选,方向涵盖键值分离存储引擎、写入下推、Agentic LLM 数据准备、时序图社区搜索、GPU 子图匹配。
5 篇入选论文一览:
Terark-DS|面向存算分离的高性能键值分离存储引擎。 写入吞吐提升 20.4%–63.9%,总成本降幅 22.7%–58.6%,已在字节存算分离架构上大规模部署。
WOP(Write Operation Pushdown)|把写操作下推到存储层,绕开 Fetch-Before-Write 的默认路径。生产工作负载吞吐最高提升 3.33 倍,写密集延迟最多降低 85.2%。
DeepPrep|基于 Agentic LLM 的自动化数据准备系统。开源 ADP 基准取得 SOTA,Buildings 真实数据集准确率 82.85%,推理成本约为 GPT-5 的 1/15。
TDC(Temporal Durable Community)|大规模时序图中的持久化社区搜索。相比在线算法最高快 100,000 倍,可扩展到含 3314 万条时序边的 Flickr 图。
gMatch|GPU 上的细粒度子图匹配。大查询工作负载下相较现有方法最高加速 36.58 倍,GPU 空闲线程占比降至 5% 以下。
而在今年的大会现场,字节数据库团队除了分享论文外还带来了以下分享:
Sponsor Talk:《How AI and Database Work Together in ByteDance Database Products》
Workshop:《Graph Memory for AI Agents — Design and Practice with MemoryBase》
文末附上了现场分享与交流的详细安排,欢迎现场参加。
以下是五篇论文的介绍:
Terark-DS:面向存算分离的高性能键值分离存储引擎
论文名称:《Terark-DS: A High-Performance and Storage-Efficient Key-Value Separation Storage Engine on Disaggregated Storage》
论文下载:https://www.vldb.org/pvldb/vol19/p822-zhang.pdf
GitHub 链接:github.com/SZ-NPE/terark-ds
背景与挑战
LSM-tree 是很多高写入吞吐存储系统的基础,但写放大的问题一直都存在。键值分离能缓解这个问题,但放到存算分离架构里,就会引发新问题:
复制写入与频繁 compaction 会使网卡(NIC)饱和,导致写入吞吐量下降 34.9%–45.5%。
远程访问会把垃圾回收(GC)延迟放大 2.03 倍,并将空间放大系数推高到 1.96 倍。
核心技术
针对这组约束,Terark-DS 采用了冗余策略、WAL 写入和 GC 一整套技术。
差异化冗余策略
根据各文件的访问模式匹配对应的冗余方案:WAL 采用仲裁机制、关键 SST 采用三副本复制、值 SST 采用(4:2)纠删码,以此平衡延迟与存储成本。
自适应 WAL 写入
根据写入组大小,在 串行与并行 WAL 写入模式间动态切换,抵消存算分离带来的额外网络往返开销。
网络高效型垃圾回收
按需 value 获取、批量与本地化 GC-Lookup、Flat Index Cache、Invalid Tree 和自适应预读等机制,一起用来减少 RPC 调用、降低冗余流量、加快空间回收。
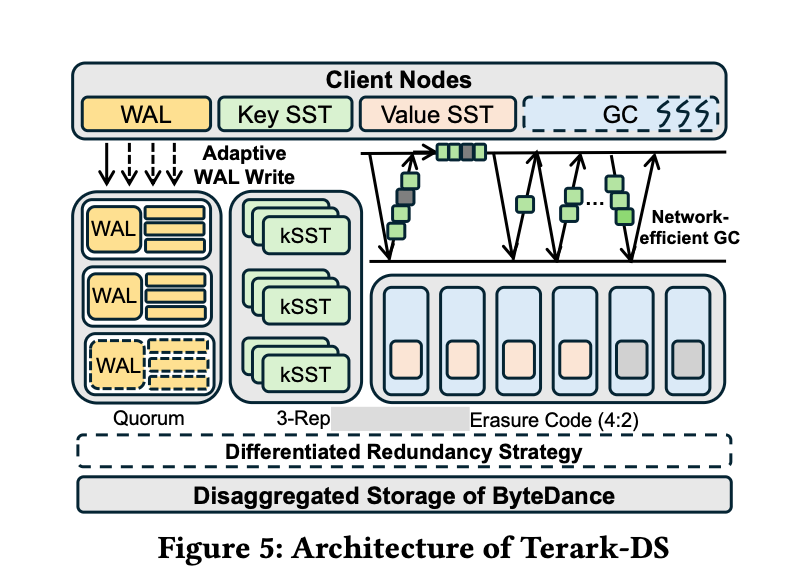
图1:Terark-DS 架构
结果验证
写入吞吐量提升 20.4% 至 63.9%。
总成本降幅 22.7% 至 58.6%。
已在字节跳动的分解式存储架构上完成大规模部署与验证。
WOP:把写操作下推到存储层,减少无效远程读取
论文标题:《Enhancing Database Write Performance with the Write Operation Pushdown Framework》
背景与挑战
在基于 B+Tree 的数据库里,写操作通常走的是 Fetch-Modify-Write:先把整页读回来,再在内存里修改,最后写回。这个模式在本地存储上已经不便宜,到了存算分离场景,代价会更明显。一次远程读取 16KB 页面,本身就是网络 I/O;再叠加二级索引带来的大量随机、非连续 I/O,写入吞吐量就更容易被卡住。
核心技术
WOP 瞄准的是这条写路径的默认前提。它的判断很直接:有一部分写操作,没必要先把页面取回计算层。对一部分满足条件的写入,可以把操作本身封装后直接下推到存储层异步执行,绕开 Fetch-Before-Write。
基于推送日志的执行机制
WOP 会把符合条件的写入操作封装成一种名为 PushLog 的专用日志记录格式,直接刷入存储层异步执行。轻量级元数据追踪
仅跟踪最少量的每页元数据,用来判断写入是否符合下推条件。在控制计算层缓冲池占用空间的同时,尽可能提升可下推写入的数量。一致性保障机制
确保 WOP 在单机部署与分布式部署场景下都不会违反事务隔离级别,能够管控运行中下推任务的可见性。即便出现部分故障或节点崩溃,也能维持分布式状态的一致性。Fetch-After-Write 优化
通过把附带重做日志的旧页面版本保留在虚拟块中,后续读取时再按需重放日志、重建最新页面,从而避免“写后读”场景下的读取停滞。
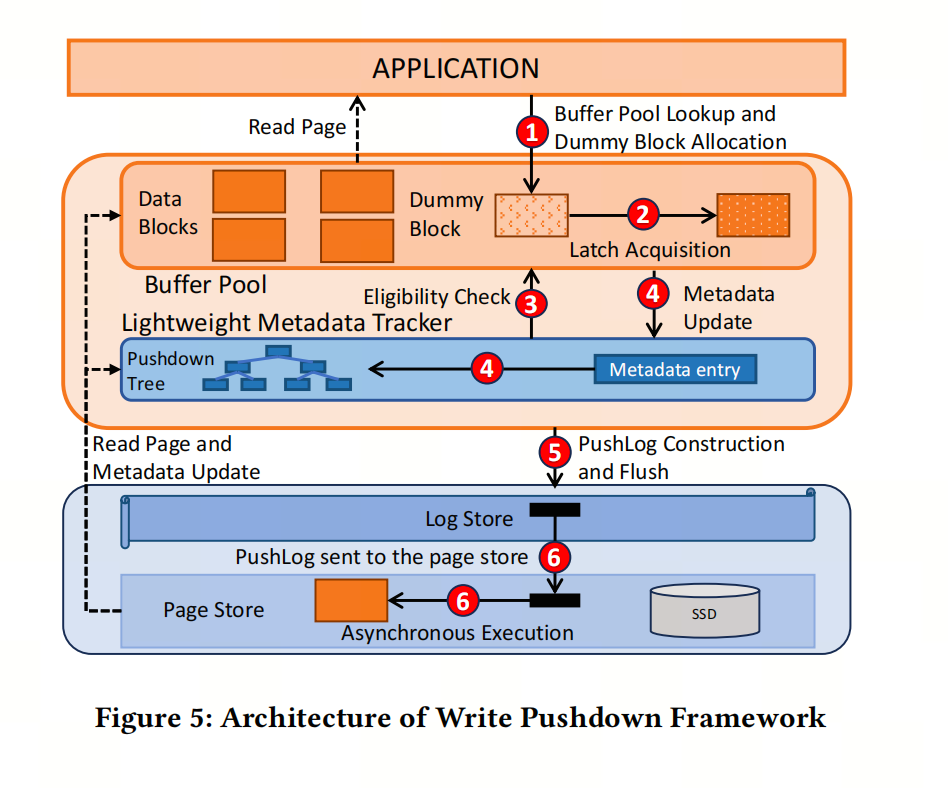
图2:写入下推框架架构图
结果验证
吞吐量提升:生产工作负载下最高可达 3.33 倍,合成基准测试下最高可达 6.7 倍。
延迟降低:在合成型写密集型工作负载下,平均延迟最多可降低 85.2%。
鲁棒性:可在不同内存大小与索引数量的场景下保持稳定运行;能够缓解写后读停顿问题,并在分解式部署场景下保障正确性。
DeepPrep:用 Agentic LLM 重构数据准备流程
论文标题:《DeepPrep: An LLM-Powered Agentic System for Autonomous Data Preparation》
背景与挑战
做数据分析时,数据准备往往要在建模之前完成,这会耗费端到端分析流程 60% 至 80% 的时间:看懂源表、清洗脏数据、连表、聚合字段、统一格式,把数据整理成能分析的样子。
但自动化数据准备并不容易,至少有三个挑战:
一次性大语言模型代码生成缺乏执行依据。
ReAct 风格的线性轨迹无法修正早期决策。
长流水线会导致训练过程中出现稀疏奖励问题。
核心技术
DeepPrep 想解决的,就是这件又重又碎、还很难完全自动化的事。
基于树的智能体推理
把流水线构建表示成显式的执行状态树:节点存储物化中间表,边代表已执行的算子。通过结构化的规划→扩展→执行→回溯交互,智能体可以保留备选路径,把下游故障归因到更早的决策,再执行非局部修正,而不是重头再来,或者困在线性轨迹里。渐进式智能体训练
不直接把问题全丢给稀疏奖励强化学习,而是走一条渐进式训练路径:算子语法学习→基于树的推理监督微调→多轮组相对策略优化。其中,混合奖励结合了最终正确性、部分表格相似度以及大语言模型判定的推理质量,为执行感知型规划、反馈响应与可解释回溯提供更密集的监督信号。基于执行的 ADP 数据合成
把 NL2SQL 基准测试转化成贴近实际的 ADP 任务:SQL 查询提供有实际意义的分析转换逻辑与目标表,大语言模型再把它转成可执行的算子流水线。随后注入可逆的数据质量噪声,例如不一致的日期格式,同时验证对应清洗算子能把数据恢复到原始状态,最终得到复杂且可执行的训练流水线,而不是随意拼接的算子链。
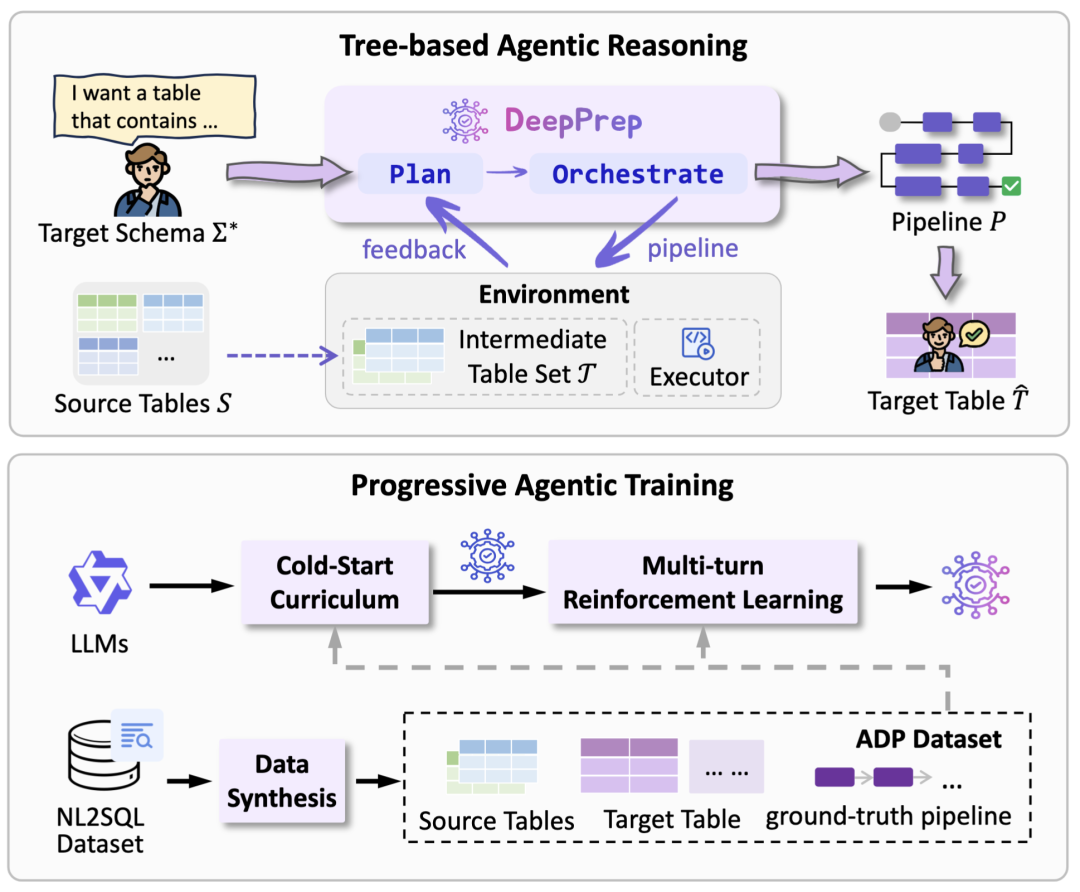
图3:DeepPrep 系统架构与训练机制
结果验证
在开源 ADP 基准测试中取得 SOTA 成绩(Synth-Spider / Bird / Parrot)。
以约 1/15 的推理成本达到与强闭源模型 GPT-5 相近的精度。
在真实世界 Buildings 数据集上达到 82.85% 准确率 和 100% 完成率。
支持 0.5B–14B 参数模型:提供开源代码、合成数据及权重,可灵活部署计算资源。
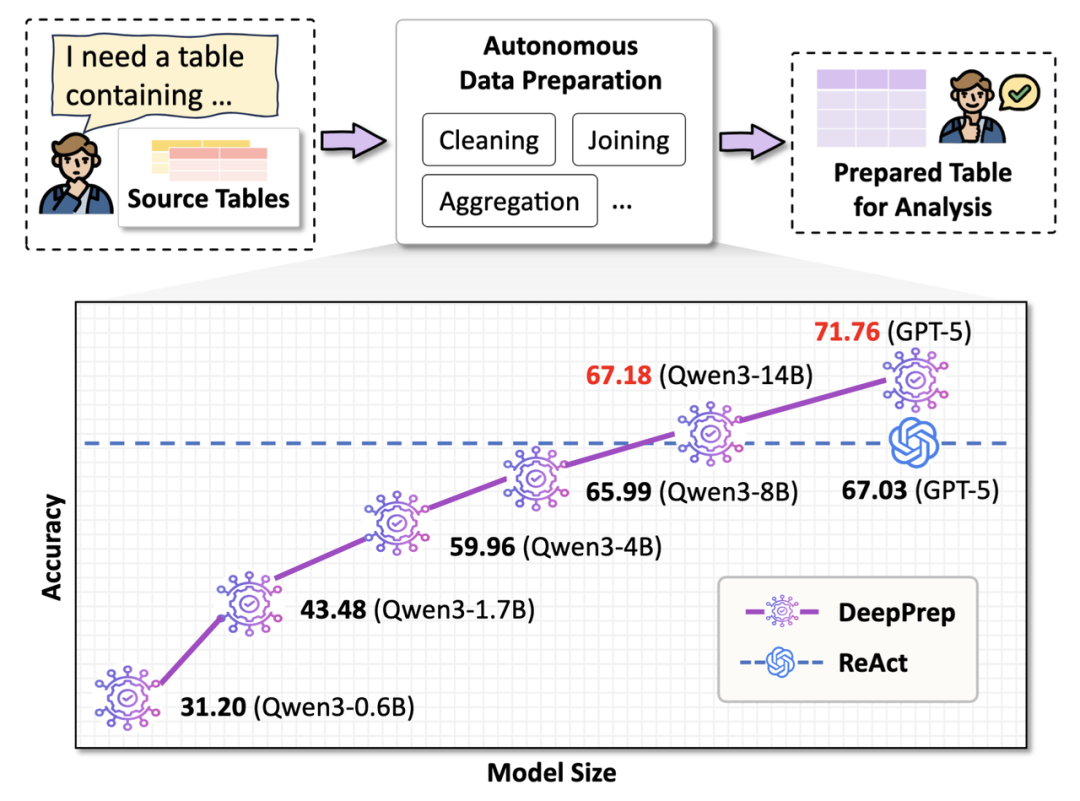
图4:DeepPrep 与 ReAct 性能对比
TDC:大规模时态图中的持久化社区搜索
论文标题:《Effective Durable Community Search in Large Temporal Graph》
背景与挑战
时序社区搜索能回答“谁”在某个时间窗口里形成了一个凝聚群体,但回答不了另一个同样重要的问题:这群人能稳定维持多久。在大型时序图上,靠枚举候选窗口去找答案,代价太高。
核心技术
TDC 抓的就是这件事。论文提出 Temporal Durable Community(TDC)模型,用来找包含查询顶点、并且在最长连续时间段里保持成员不变的时间 k-core。这样一来,社区搜索不只是“找到一组人”,而是进一步回答“这组关系能稳定多久”。
时序持久社区(TDC)
给定查询顶点、k 值与查询区间,找出社区持续时间最长的连通时序 k-核。其中,持续时间指的是该核的顶点集在形成后保持不变的时长。单调性引导的在线搜索(ONCE)
在起始时间固定的情况下,随着时间窗口扩大,时态 k-核只会不断增长或保持不变,不会发生分裂。ONCE 就利用这种单调性,对成员变更执行二分查找。紧凑式 ATG 索引 + 增量式 AIT
为每条边分配活跃时间;最小生成森林加关键出边可呈现成员归属关系与下一次变更信息;ATG 索引可在多个启动时间点复用共享结构,而 AIT 则会对先前计算得到的社区做增量式扩展。
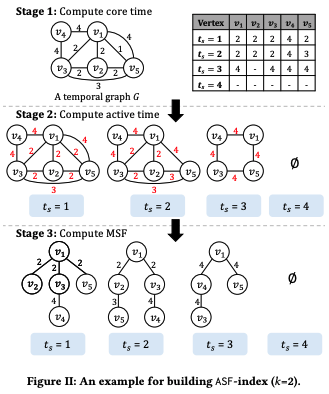
图5:ASF-index 构建示例(k = 2)
结果验证
TDC 相关方法最高比在线 ONCE 算法快 100,000 倍,比基础索引方法 BIT 快 1,000 倍。
索引构建速度最高提升 100 倍,并可扩展到包含 3314 万条时序边的 Flickr 图,仅需 7.1GB ATG-index。
在五个数据集中,TDC 的平均稳定时长比普通时序 k-core 社区高出 5.6 至 20.2 倍。
gMatch:GPU上的细粒度高效子图匹配
论文标题:《gMatch: Fine-Grained and Hardware-Efficient Subgraph Matching on GPUs》
Github 链接:https://github.com/SJTU-Liquid/gMatch
背景与挑战
子图匹配是图计算里的基础问题,在欺诈检测、知识图谱、网络安全等场景都很常见。GPU 并行能力很强,但子图匹配并不是那种天然规则、容易铺满硬件的任务。不同部分匹配对应的候选顶点数量差异很大,整个搜索过程非常不规则。
核心技术
gMatch 抓住的是这类任务和 GPU 执行模型之间的错配。现有 GPU 子图匹配系统通常采用粗粒度执行模型,也就是一个 warp 扩展一个 partial match。候选集一旦变小或分布很不均匀,warp 里就会出现大量空闲 lane。评估数据显示,在这种粗粒度执行下,空闲线程占比最高可达 70.74%。同时,每个 warp 还要维护更大的执行栈,内存压力也会上来,严重时会在大图或高度数图上触发 OOM。
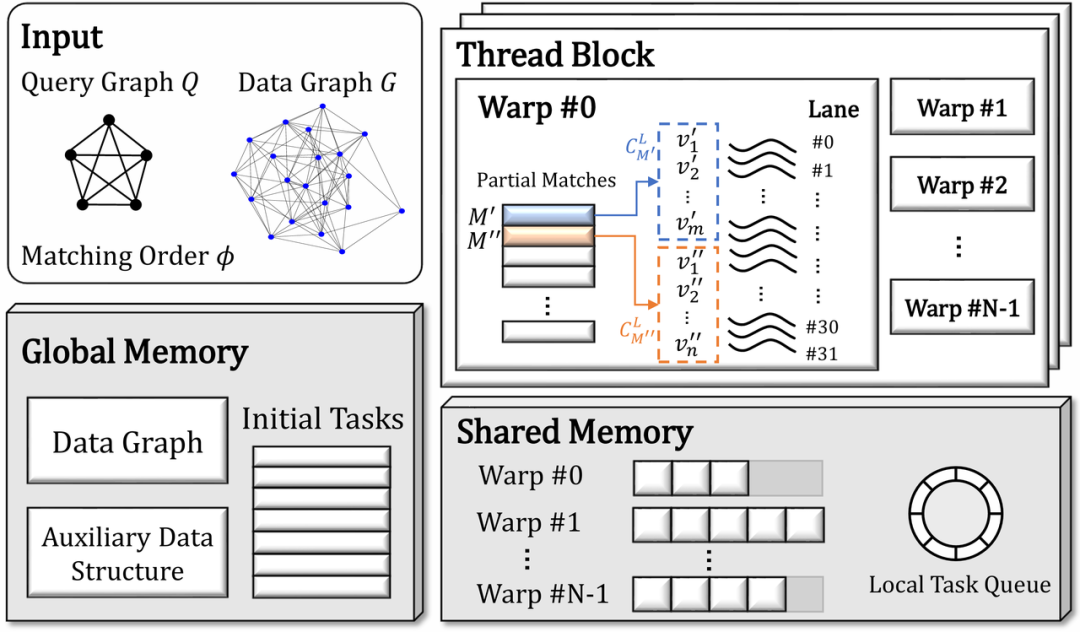
图6:gMatch架构纵览
细粒度并行执行
gMatch 把每一次部分匹配扩展拆成独立的候选检查任务,并把每个任务分配给一个 GPU 线程。这样既减少了单任务的执行状态开销,也让执行栈可以驻留在共享内存中,同时释放出更多并行能力。线程束级批量探索
由不同部分匹配生成的任务会被放进共享任务池,再打包到同一线程束。通过让一个线程束同时处理多个 partial match,gMatch 能把原本闲置的通道利用起来,把不规则候选集转成更密集的 GPU 执行任务。轻量级负载均衡
细粒度任务生成在常规执行过程中就能提供足够的并行性。只有当线程束进入空闲状态时,才触发工作窃取机制,既提升了负载均衡效果,也避免了持续全局调度带来的额外开销。
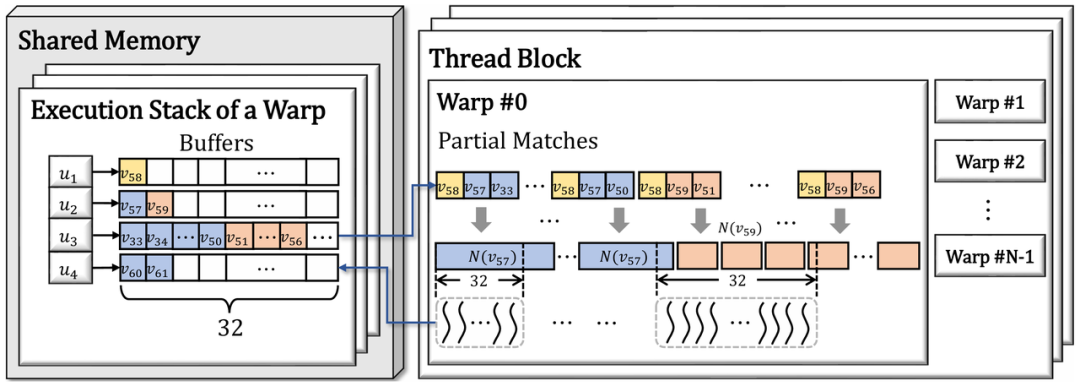
图7:跨多个部分匹配的 Warp 级批量探索
结果验证
gMatch 在大查询工作负载下,相较现有方法可实现最高 36.58 倍加速,并将 GPU 空闲线程占比降至 5% 以下。
对大规模图分析来说,这项工作说明,性能提升不只是把任务搬到 GPU 上,更关键的是让执行模型真正贴合图搜索的非规则负载。
附:大会现场交流安排
字节跳动数据库团队将在 VLDB 2026 的多个 Research Session、Industry Session、Poster Session、Sponsor Talk 和 Workshop 现场分享上述工作。参会同学可根据下图中的现场安排信息前往对应场次,与论文作者当面交流实现细节、部署经验或合作机会。
另外,团队还在大会期间特设交流晚宴。届时将与海外留学生深入沟通业务最新进展、共探 AI 发展趋势,打通人才交流渠道、促进就业对接,敬请大家关注。
