ACM MM 2026 Oral | 北航等提出CamoDreamer:要融入,先解耦:通过上下文解耦同化渲染重新思考伪装图像生成
原创 52CV 2026-11-10 23:47 江苏
本篇分享ACM MM 2026(Oral)论文《To Blend In, First Decouple: Rethinking Camouflage Image Generation via Context-Decoupled Representations》。北京航空航天大学计算机学院李甲赵一凡研究团队与吉利汽车研究院人工智能中心联合提出了一种上下文解耦同化渲染框架,用于高保真伪装图像生成。
作者:王文状(北航),赵一凡(北航),马明灿(吉利汽车),车云龙(吉利汽车),陈浩然(北航),刘明(吉利汽车),李甲(北航)
单位:北京航空航天大学,吉利汽车研究院
通讯作者:赵一凡,李甲
摘要
伪装图像生成(CIG)专注于生成视觉上隐蔽的物体,使其无缝融入背景。现有方法通常采用背景引导范式(通过风格迁移调整物体外观)或前景引导策略(基于物体特征对周围区域进行外推绘制)。然而,这些方法仍存在外观差异和背景伪影的问题。本文将这些局限性归因于跨上下文表征泄露物体与背景线索在耦合条件空间中相互纠缠,导致控制模糊且伪装保真度下降。
为解决这一问题,提出了一种新的上下文解耦生成范式,命名为CamoDreamer,旨在隔离上下文条件引导,并将潜在伪装特征显式解耦为协调的物体与背景控制流。首先,设计了一个对比感知上下文桥接模块,用于建模跨上下文差异并构建对比感知的双条件引导。其次,采用上下文解耦同化流,将基于双条件引导的生成交互分离,同时在潜在空间中利用目标感知线索促进背景渲染。
最后,频率自适应上下文融合模块整合了解耦特征中的互补高频纹理与低频结构,以提升整体连贯性。
研究背景与动机
伪装图像的关键并不只是生成一个外观逼真的目标,更在于让目标与周围环境在纹理、颜色和结构上形成自然协调的整体。现有伪装图像生成方法大致分为两类:背景引导方法倾向于调整前景目标以匹配指定背景,但可能损害目标自身外观;前景引导方法则以目标为条件补全背景,虽然能够保留目标结构,却仍可能在背景区域引入不自然的纹理,并造成前景与背景之间的颜色或外观差异。
论文进一步指出,这些问题与前景和背景表征在生成过程中的相互干扰有关。一方面,背景信息可能不加区分地进入前景表征,影响目标外观;另一方面,潜在空间中缺少结构化的交互机制,也会使不恰当的背景线索干扰目标生成。论文将这一现象概括为“跨上下文表征泄露”,并据此提出将目标与背景的条件引导及潜在特征先行解耦,再进行协调融合。
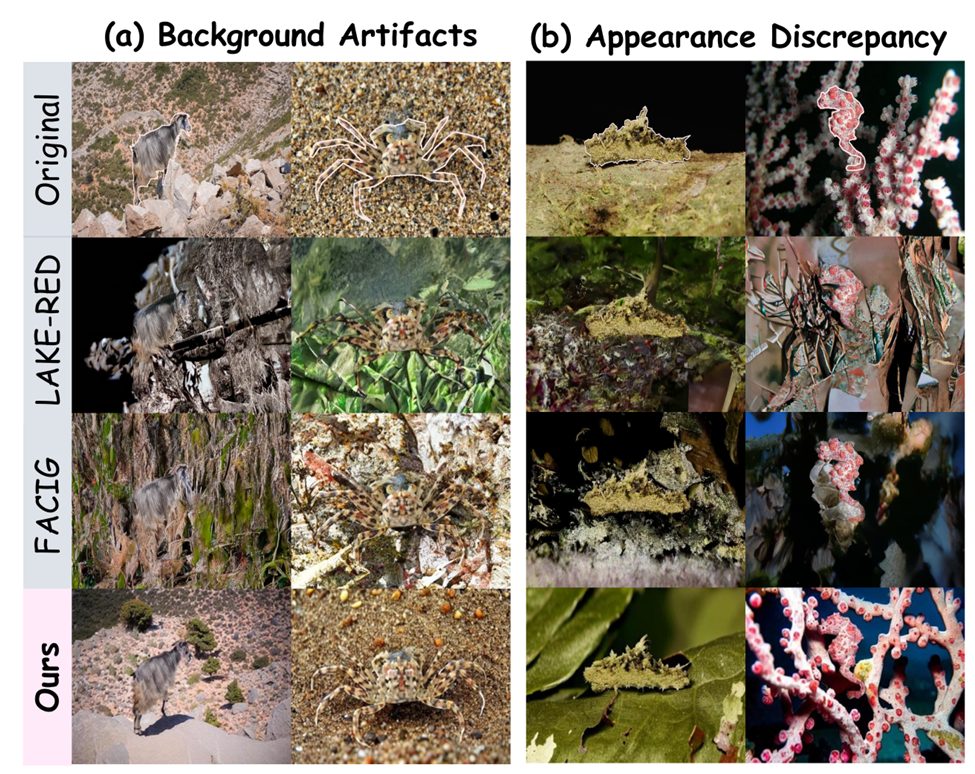
图1:研究动机与定性对比。展示本文CamoDreamer与前景引导方法(LAKE-RED和FACIG)的生成效果对比:(a)背景伪影:现有先进方法生成的背景常存在不真实现象和明显纹理伪影;(b)外观差异:前景与背景之间存在明显的视觉不一致,如颜色不协调。
方法:先解耦,再融合的上下文同化渲染
CamoDreamer以预训练Stable Diffusion为生成基础。给定目标图像及其掩码,模型首先利用视觉表征检索与目标相关的背景候选,再通过CCB建立目标与背景之间的对比关系,形成双路条件引导。
随后,CDAS将潜在伪装特征划分为目标流和背景流:目标流在目标区域内建模目标表征,背景流则在背景区域内进行生成,并通过同化分支引入目标感知线索,使背景渲染兼顾环境语义与目标特征。
最后,FACB在频率域中自适应整合高频纹理和低频结构,并将其映射回统一表征,生成具有整体上下文协调性的伪装图像。
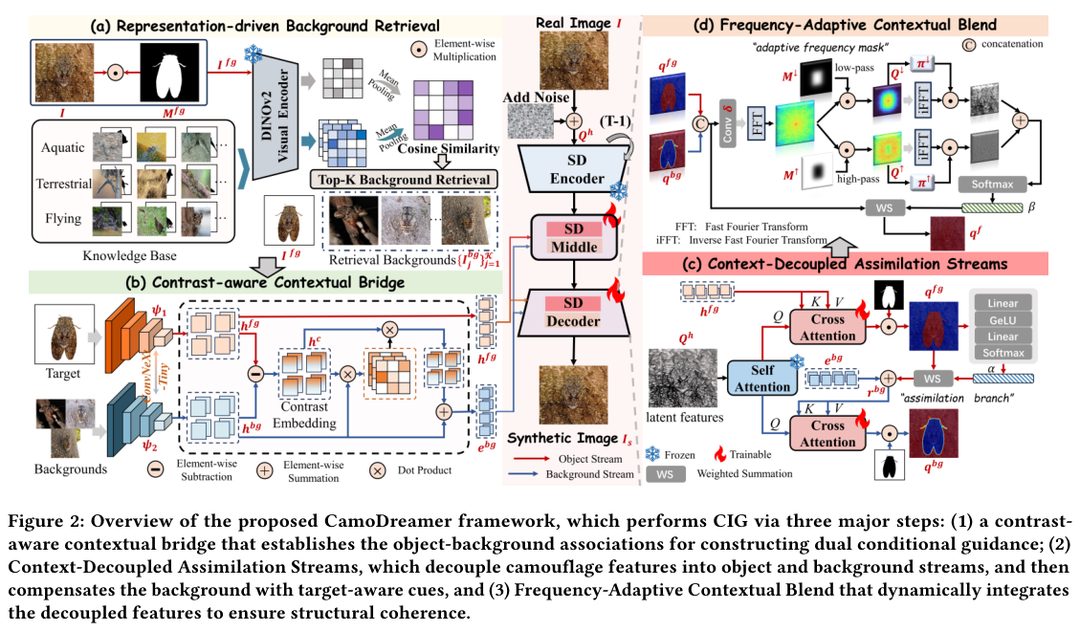
图2:CamoDreamer 框架概览。 整体流程包含三个主要步骤:(1) 对比感知上下文桥接模块(CCB),建立目标与背景之间的关联,构建双重条件引导;(2) 上下文解耦同化流(CDAS),将伪装特征解耦为目标与背景两路,并利用目标感知线索补偿背景;(3) 频率自适应上下文融合模块(FACB),动态融合解耦后的特征,以保证结构一致性。
该论文提出了以下方法作为CamoDreamer框架的一部分,用于高保真伪装图像生成:
对比感知上下文桥接(CCB):该组件建模目标与背景之间的关联,以构建双重条件引导,有助于分离目标和背景线索。
上下文解耦同化流(CDAS):该方法将潜在伪装特征显式解耦为独立的目标和背景注意力流,从而能够精确调节前景和背景特征。
频率自适应上下文融合(FACB):该模块整合来自目标和背景流的高频纹理与低频结构,以确保生成的伪装图像在整体视觉上的一致性。
这些方法共同解决了跨上下文表征泄漏的问题,并提升了伪装图像生成的逼真度和连贯性。
实验结果
生成保真度:在 LAKE-RED 数据集上,论文将 CamoDreamer 与 11 种代表性方法进行比较,涵盖背景引导、前景引导和文本提示生成范式。CamoDreamer 在整体测试集上取得 37.33 的 FID 和 0.0159 的 KID。其中,FID 相较于此前表现最好的对比方法降15.54,表明上下文解耦设计有助于减少背景伪影并改善目标与环境之间的视觉协调性。
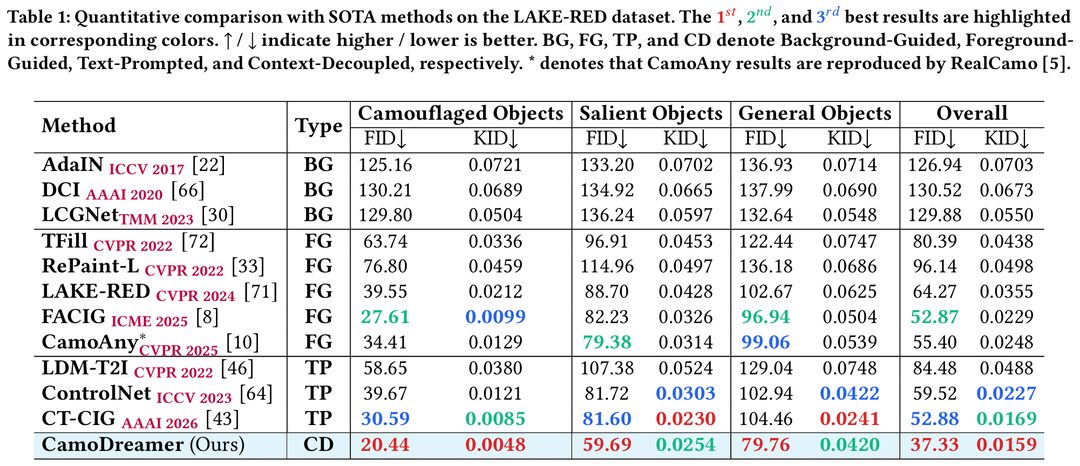
表1:LAKE-RED 数据集上与现有先进方法的定量比较。 最佳、次佳和第三佳结果分别以对应颜色标出。↑ / ↓ 分别表示数值越高 / 越低越好。BG、FG、TP 和 CD 分别表示背景引导、前景引导、文本提示和上下文解耦。
定性评估
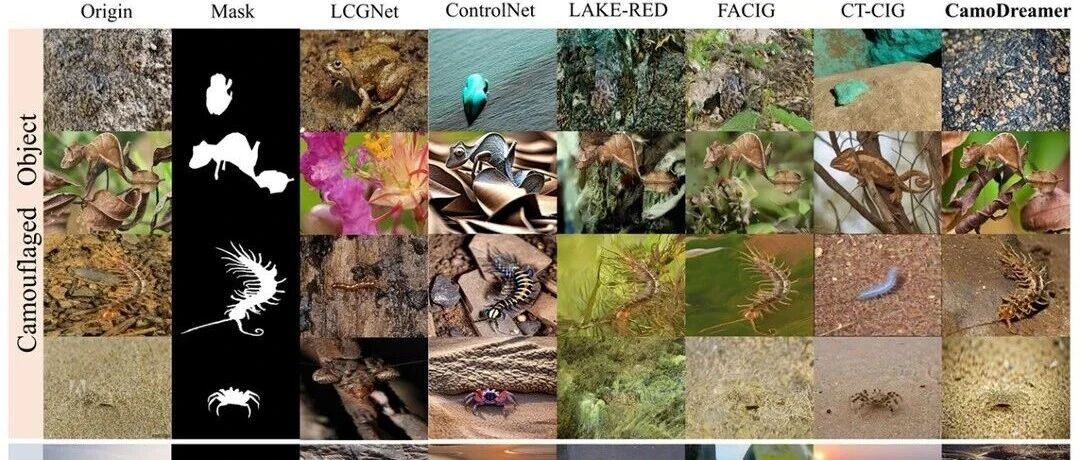
图1展示了以伪装目标和开放域目标为条件生成的图像定性对比。背景引导方法 LCGNet 倾向于使目标过度适应周围环境,导致前景严重失真甚至不可见(如第二行中呈现透明状态的变色龙)。
前景引导方法(如 LAKE-RED 和 FACIG)则容易引入伪影和语义不合理的背景(如最后一行面包周围的黑色背景,以及第三行蜈蚣周围不自然的绿色环境),难以形成真实的伪装场景。尽管文本提示方法 CT-CIG 借助更强的语义引导生成了视觉上具有较强隐蔽性的目标,但仍存在掩码错位和非预期的外观变化,限制了其在下游任务中的应用。
相比之下,本文提出的 CamoDreamer 能够生成真实且协调的伪装图像,在保持目标自身特征的同时,实现与背景的高度兼容和一致性。
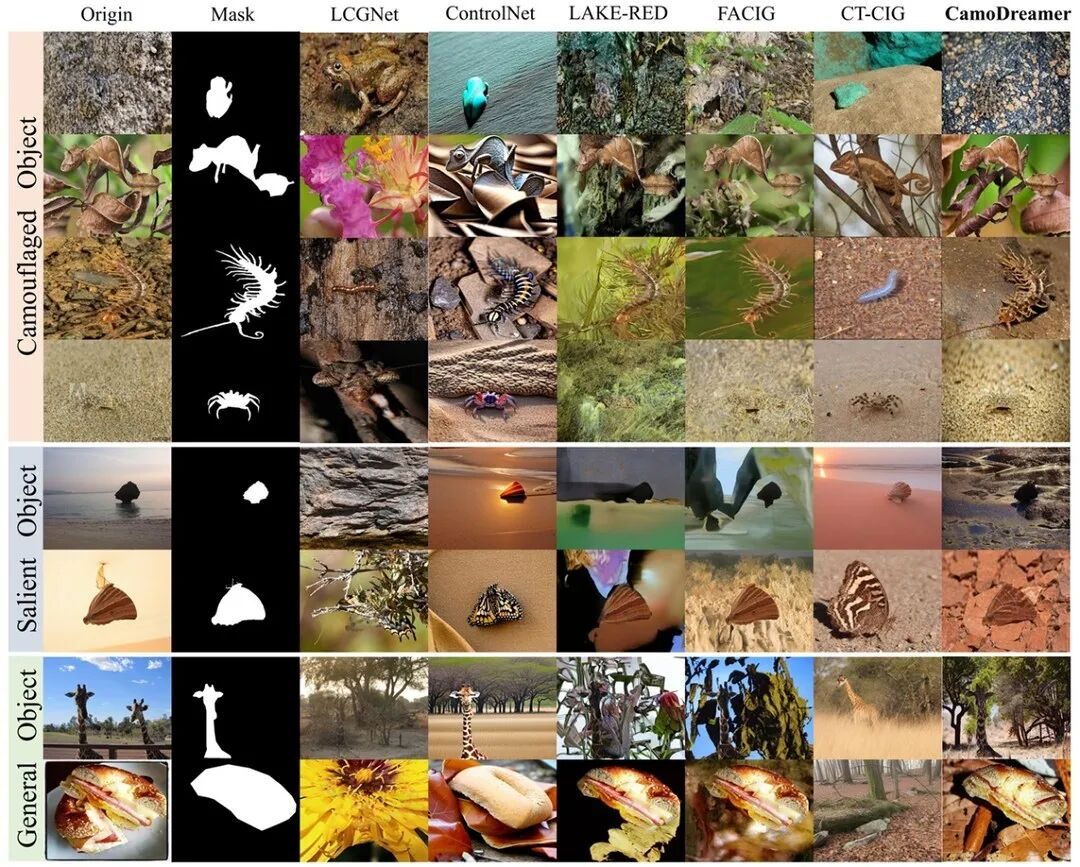
图1:不同伪装图像生成方法的定性对比。 前两列分别展示真实图像及其对应的掩码;第三列中 LCGNet 的背景由本文通过表征驱动的检索方式获得。

本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。